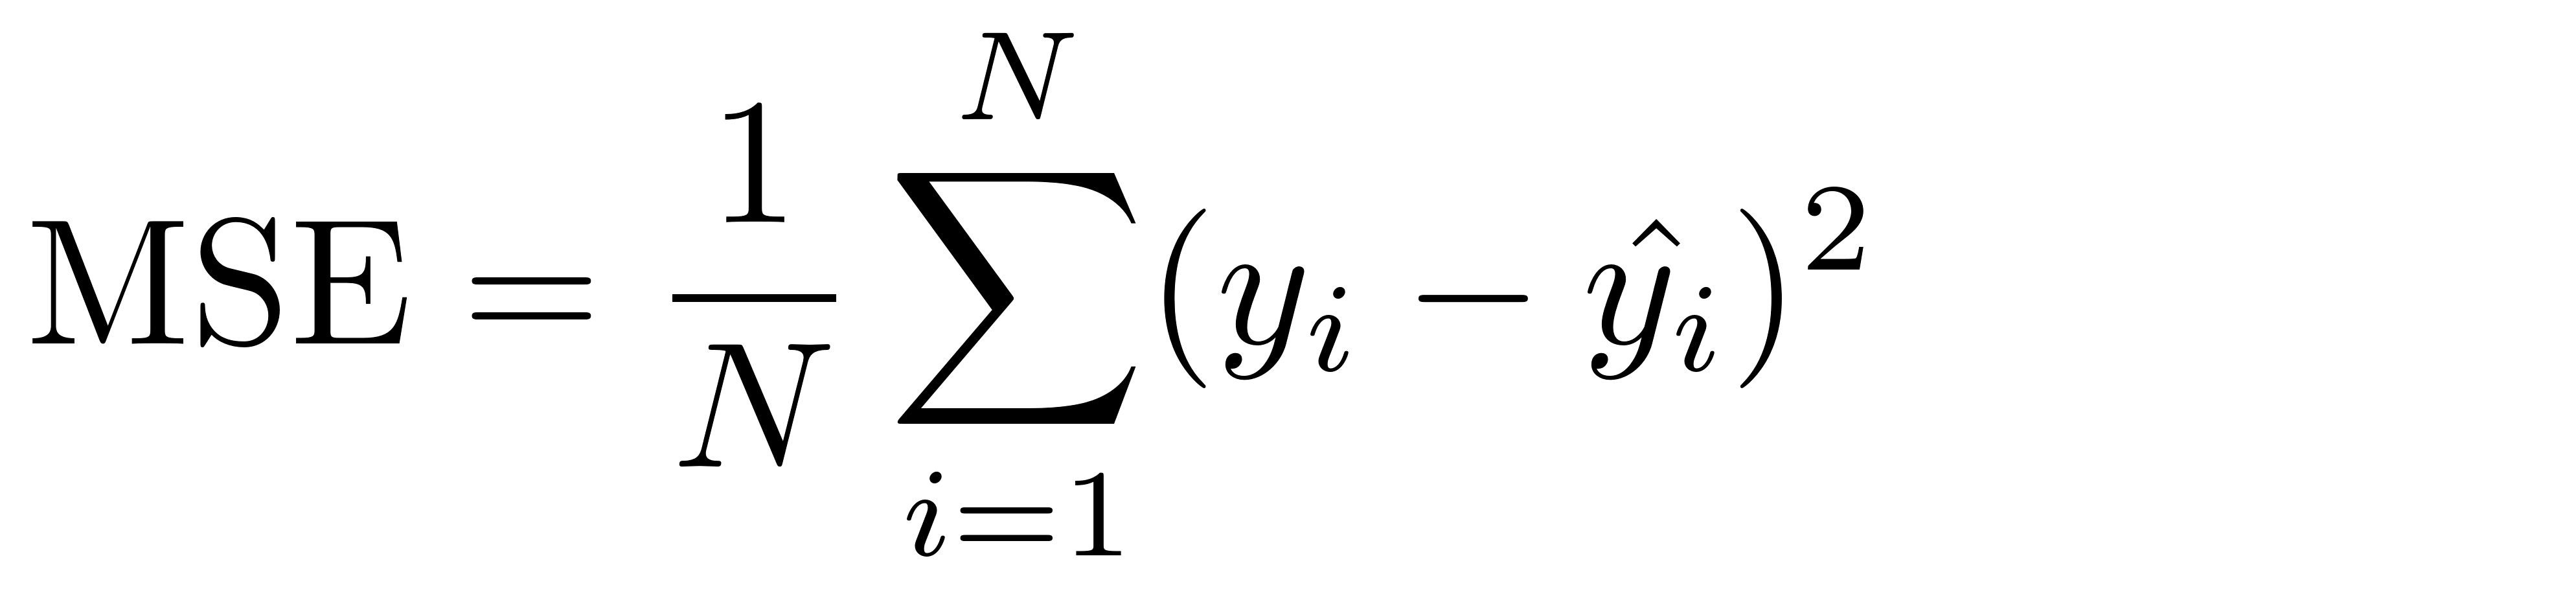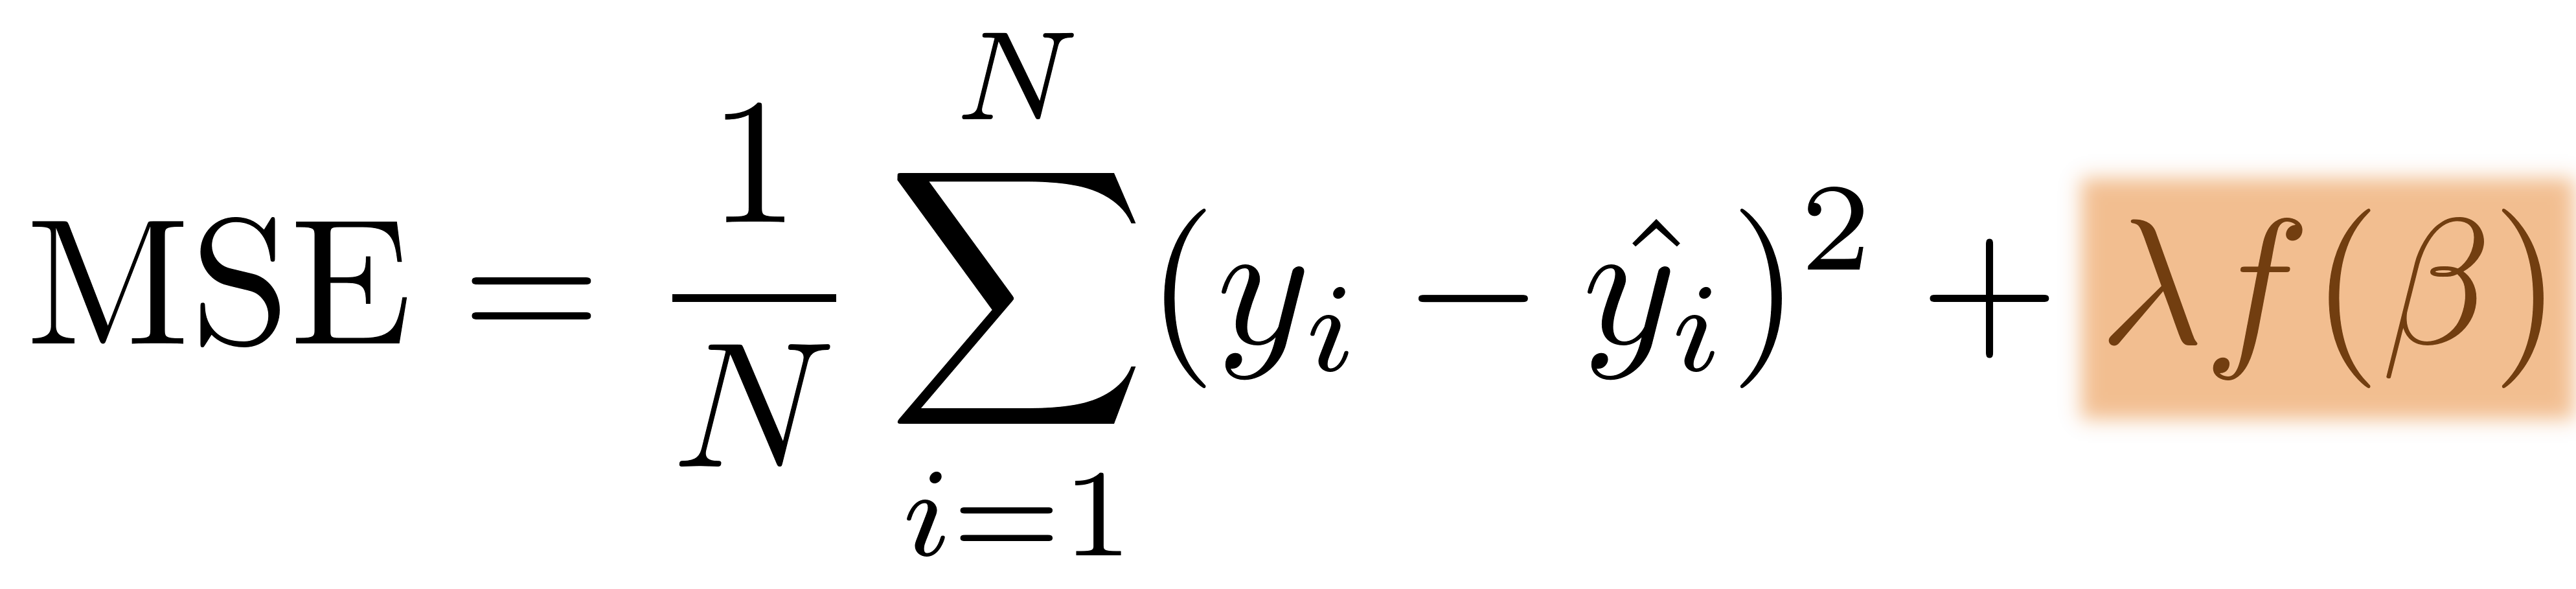Regularización

Machine learning con PySpark

Andrew Collier

Data Scientist, Fathom Data

Features: pocas

Conjunto de datos con pocas variables

Machine learning con PySpark

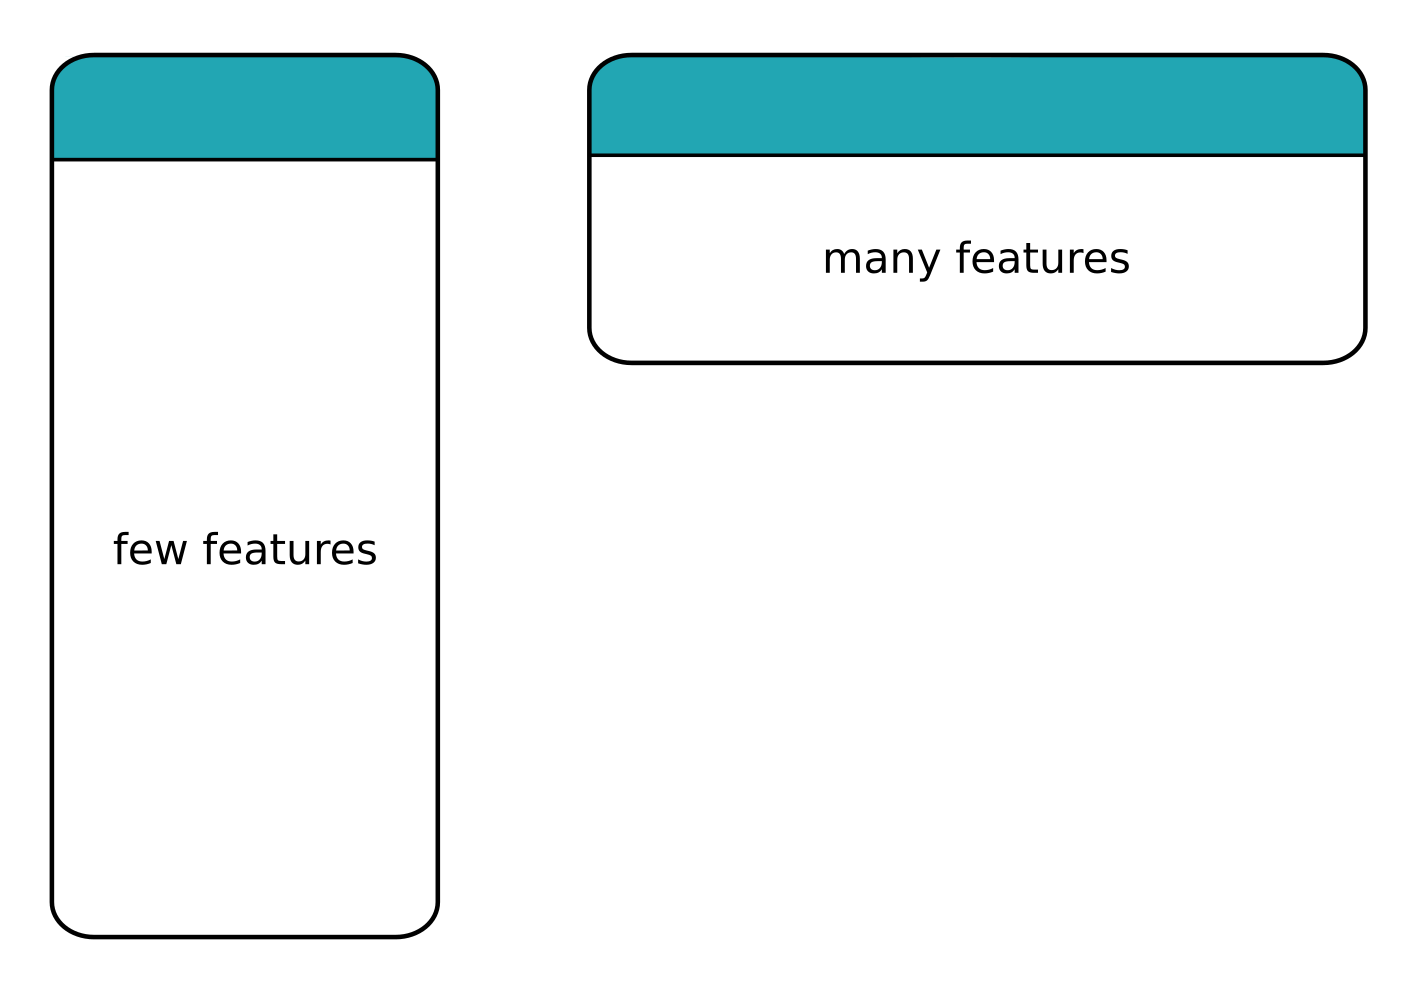
Features: demasiadas

Conjunto de datos con muchas variables

Machine learning con PySpark

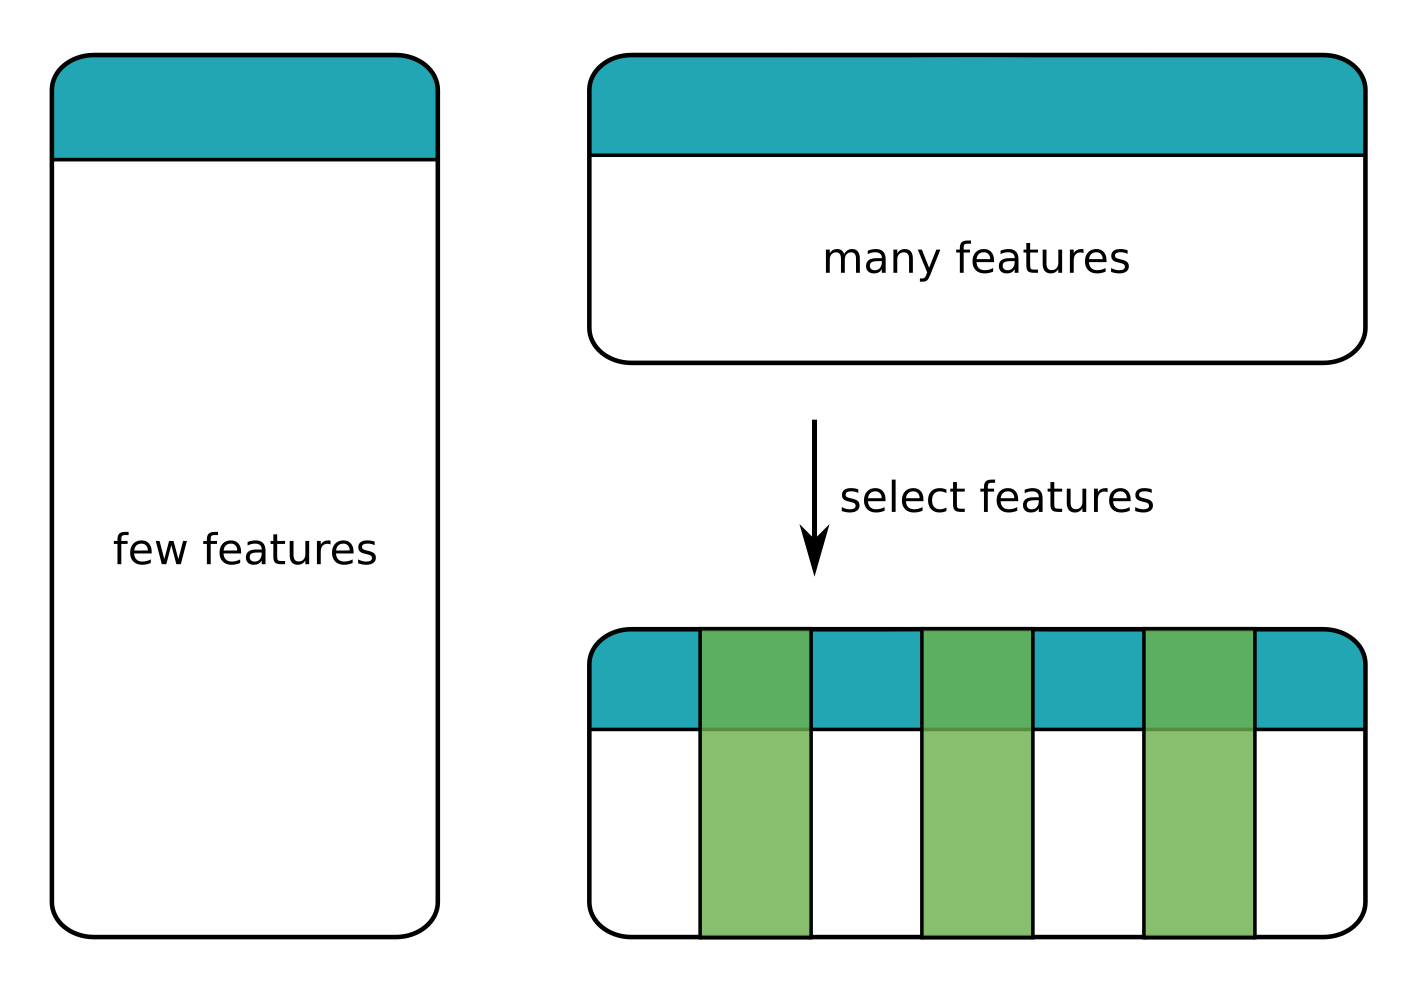
Features: seleccionadas

Selección de variables en un conjunto con muchas variables

Machine learning con PySpark

Función de pérdida (revisión)

La regresión lineal busca minimizar el MSE.

Función de pérdida de error cuadrático medio

Machine learning con PySpark

Pérdida con regularización

La regresión lineal busca minimizar el MSE.

Función de pérdida MSE con término de regularización

Añade un término de regularización que depende de los coeficientes.

Machine learning con PySpark

Término de regularización

Se añade un término extra de regularización a la función de pérdida.

El término de regularización puede ser

  • Lasso: valor absoluto de los coeficientes
  • Ridge: cuadrado de los coeficientes

También es posible una combinación de Lasso y Ridge.

La intensidad de la regularización la fija el parámetro $\lambda$:

  • $\lambda = 0$: sin regularización (regresión estándar)
  • $\lambda = \infty$: regularización total (todos los coeficientes a cero)
Machine learning con PySpark

Coches de nuevo

assembler = VectorAssembler(inputCols=[
    'mass', 'cyl', 'type_dummy', 'density_line', 'density_quad', 'density_cube'
], outputCol='features')
cars = assembler.transform(cars)
+-----------------------------------------------------------------------------+-----------+
|features                                                                     |consumption|
+-----------------------------------------------------------------------------+-----------+
|[1451.0,6.0,1.0,0.0,0.0,0.0,0.0,303.8743455497,63.63860639785,13.32745683724]|9.05       |
|[1129.0,4.0,0.0,0.0,1.0,0.0,0.0,244.2137140385,52.82580879050,11.42673778726]|6.53       |
|[1399.0,4.0,0.0,0.0,1.0,0.0,0.0,307.6753903672,67.66557958374,14.88136784335]|7.84       |
|[1147.0,4.0,0.0,1.0,0.0,0.0,0.0,264.1031545014,60.81122599620,14.00212433714]|7.84       |
+-----------------------------------------------------------------------------+-----------+
Machine learning con PySpark

Coches: regresión lineal

Ajusta un modelo de regresión lineal (estándar) a los datos de entrenamiento.

regression = LinearRegression(labelCol='consumption').fit(cars_train)
# RMSE en datos de prueba
0.708699086182001

Examina los coeficientes:

regression.coefficients
DenseVector([-0.012, 0.174, -0.897, -1.445, -0.985, -1.071, -1.335, 0.189, -0.780, 1.160])
Machine learning con PySpark

Coches: regresión Ridge

# alpha = 0 | lambda = 0.1 -> Ridge
ridge = LinearRegression(labelCol='consumption', elasticNetParam=0, regParam=0.1)
ridge.fit(cars_train)
# RMSE
0.724535609745491
# Coeficientes Ridge
DenseVector([ 0.001, 0.137, -0.395, -0.822, -0.450, -0.582, -0.806, 0.008,  0.029, 0.001])
# Coeficientes regresión lineal
DenseVector([-0.012, 0.174, -0.897, -1.445, -0.985, -1.071, -1.335, 0.189, -0.780, 1.160])
Machine learning con PySpark

Coches: regresión Lasso

# alpha = 1 | lambda = 0.1 -> Lasso
lasso = LinearRegression(labelCol='consumption', elasticNetParam=1, regParam=0.1)
lasso.fit(cars_train)
# RMSE
0.771988667026998
# Coeficientes Lasso
DenseVector([   0.0,   0.0,    0.0, -0.056,    0.0,    0.0,    0.0, 0.026,    0.0,   0.0])
# Coeficientes Ridge
DenseVector([ 0.001, 0.137, -0.395, -0.822, -0.450, -0.582, -0.806, 0.008,  0.029, 0.001])
# Coeficientes regresión lineal
DenseVector([-0.012, 0.174, -0.897, -1.445, -0.985, -1.071, -1.335, 0.189, -0.780, 1.160])
Machine learning con PySpark

Regularización → modelo simple

Machine learning con PySpark

Preparing Video For Download...