Clustering de documentos

Análisis de clústeres en Python

Shaumik Daityari

Business Analyst

Clustering de documentos: conceptos

  1. Limpia los datos antes de procesar
  2. Determina la importancia de los términos (en la matriz TF‑IDF)
  3. Agrupa la matriz TF‑IDF
  4. Encuentra términos y documentos top por clúster
Análisis de clústeres en Python

Limpia y tokeniza los datos

  • Convierte el texto en tokens y limpia los datos para procesarlos
from nltk.tokenize import word_tokenize
import re

def remove_noise(text, stop_words = []):
    tokens = word_tokenize(text)

cleaned_tokens = [] for token in tokens: token = re.sub('[^A-Za-z0-9]+', '', token)
if len(token) > 1 and token.lower() not in stop_words: # Get lowercase cleaned_tokens.append(token.lower()) return cleaned_tokens
remove_noise("It is lovely weather we are having. I hope the weather continues.")
['lovely', 'weather', 'hope', 'weather', 'continues']
Análisis de clústeres en Python

Matriz término‑documento y matrices dispersas

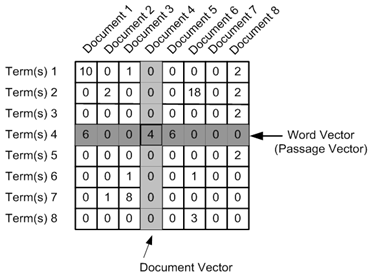
  • Se forma la matriz término‑documento
  • La mayoría de elementos son ceros

Source

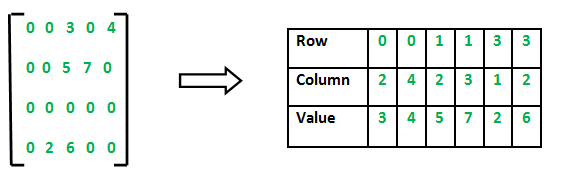
  • Se crea una matriz dispersa

Source

Análisis de clústeres en Python

TF‑IDF (Frecuencia de Término - Frecuencia Inversa de Documento)

  • Medida ponderada: evalúa cuán importante es una palabra para un documento en una colección
from sklearn.feature_extraction.text import TfidfVectorizer

tfidf_vectorizer = TfidfVectorizer(max_df=0.8, max_features=50, min_df=0.2, tokenizer=remove_noise)
tfidf_matrix = tfidf_vectorizer.fit_transform(data)
Análisis de clústeres en Python

Clustering con matriz dispersa

  • kmeans() en SciPy no admite matrices dispersas
  • Usa .todense() para convertir a matriz densa
cluster_centers, distortion = kmeans(tfidf_matrix.todense(), num_clusters)
Análisis de clústeres en Python

Términos top por clúster

  • Centros de clúster: listas del tamaño del nº de términos
  • Cada valor en el centro indica su importancia
  • Crea un diccionario e imprime los términos top
terms = tfidf_vectorizer.get_feature_names_out()

for i in range(num_clusters):
    center_terms = dict(zip(terms, list(cluster_centers[i])))

sorted_terms = sorted(center_terms, key=center_terms.get, reverse=True)
print(sorted_terms[:3])
['room', 'hotel', 'staff']

['bad', 'location', 'breakfast']
Análisis de clústeres en Python

Más consideraciones

  • Trata con hipervínculos, emoticonos, etc.
  • Normaliza palabras (run, ran, running -> run)
  • .todense() puede fallar con datasets grandes
Análisis de clústeres en Python

¡Vamos a practicar!

Análisis de clústeres en Python

Preparing Video For Download...