check_finite: si se comprueba que hay solo números finitos (predeterminado: True)
Devuelve dos objetos: centros de clúster y distorsión
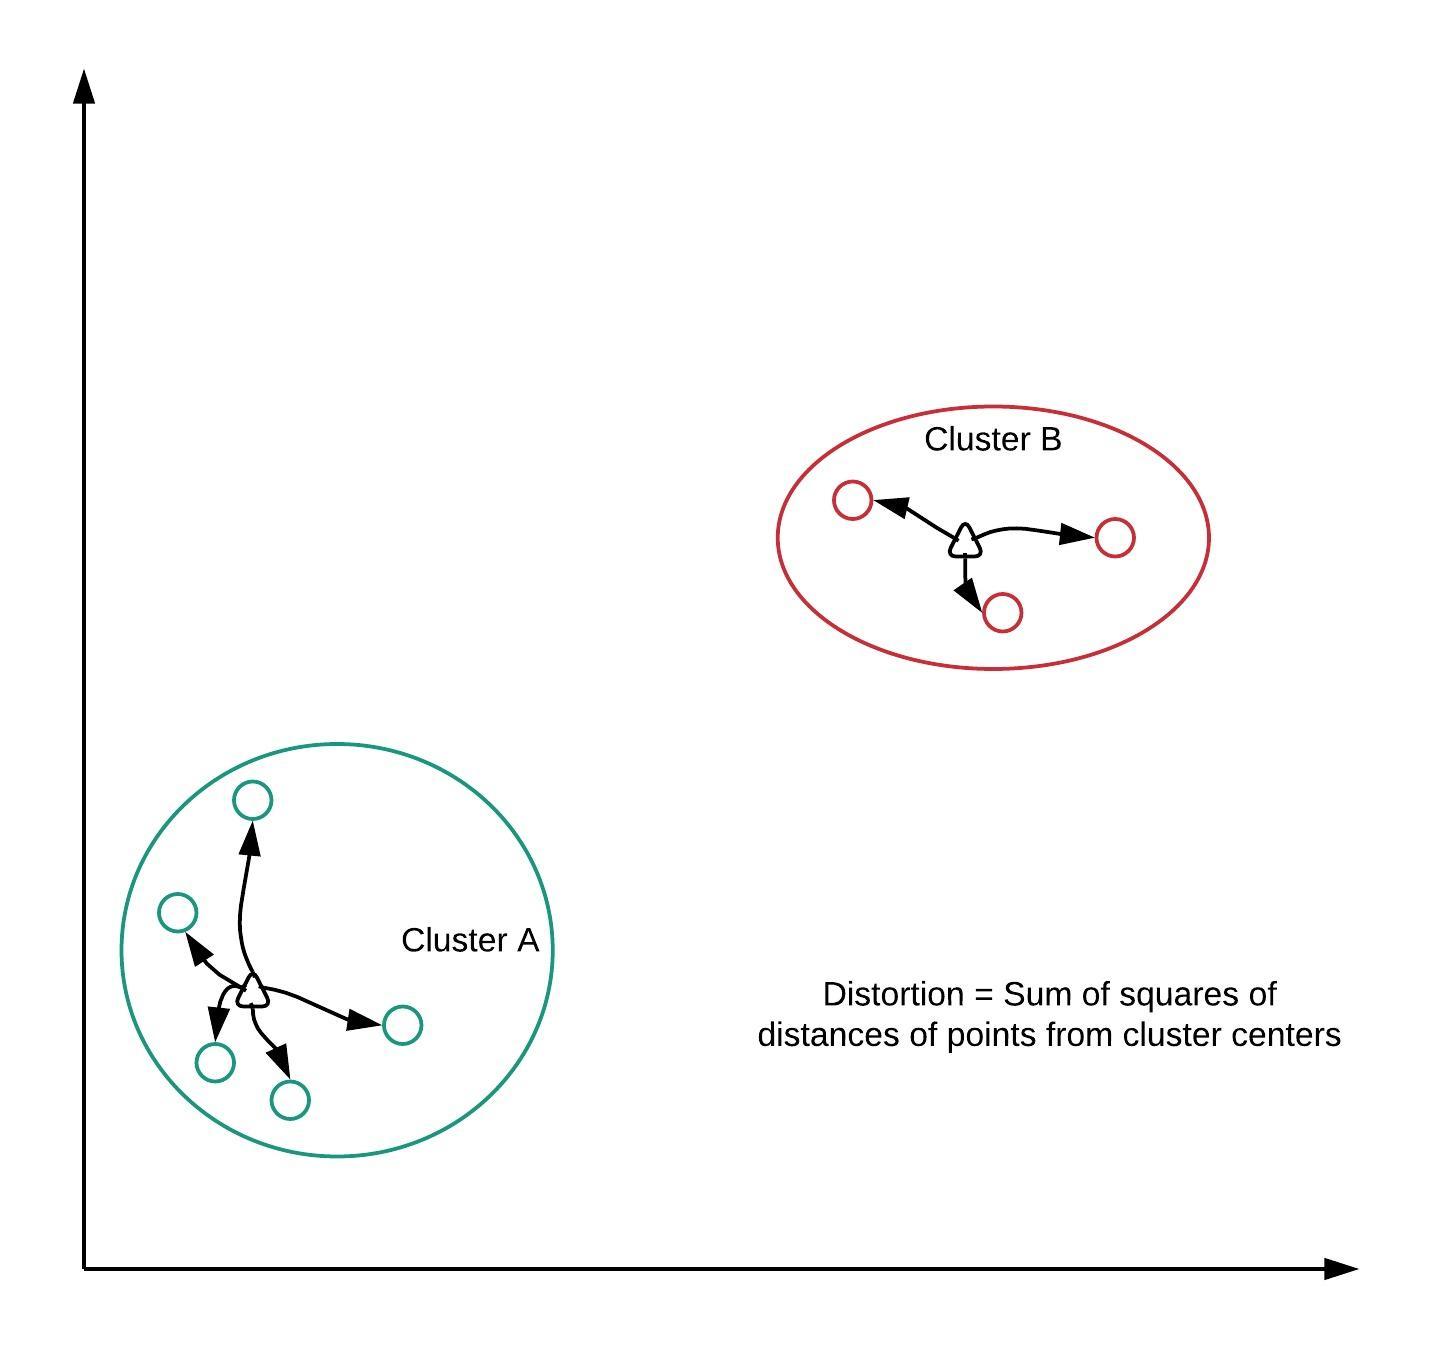
¿Cómo se calcula la distorsión?
Paso 2: generar etiquetas de clúster
vq(obs, code_book, check_finite=True)
obs: observaciones estandarizadas
code_book: centros de clúster
check_finite: si se comprueba que hay solo números finitos (predeterminado: True)
Devuelve dos objetos: lista de etiquetas de clúster y lista de distorsiones
Nota sobre las distorsiones
kmeans devuelve un único valor de distorsión
vq devuelve una lista de distorsiones.
Ejecutar k-means
# Importa las funciones kmeans y vq
from scipy.cluster.vq import kmeans, vq
# Genera centros y etiquetas de clúster
cluster_centers, _ = kmeans(df[['scaled_x', 'scaled_y']], 3)
df['cluster_labels'], _ = vq(df[['scaled_x', 'scaled_y']], cluster_centers)
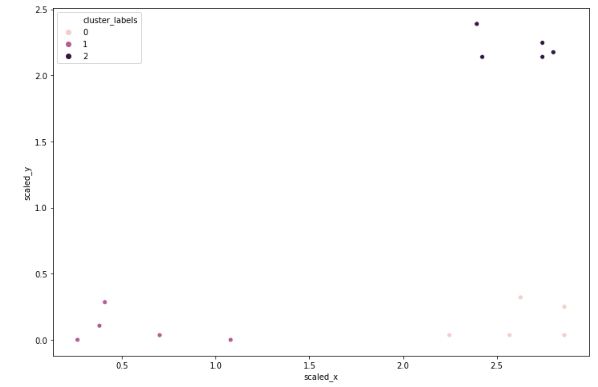
# Grafica los clústeres
sns.scatterplot(x='scaled_x', y='scaled_y', hue='cluster_labels', data=df)
plt.show()