Introdução ao Deep Q Learning
Aprendizado por reforço profundo em Python

Timothée Carayol
Principal Machine Learning Engineer, Komment
O que é Deep Q Learning?
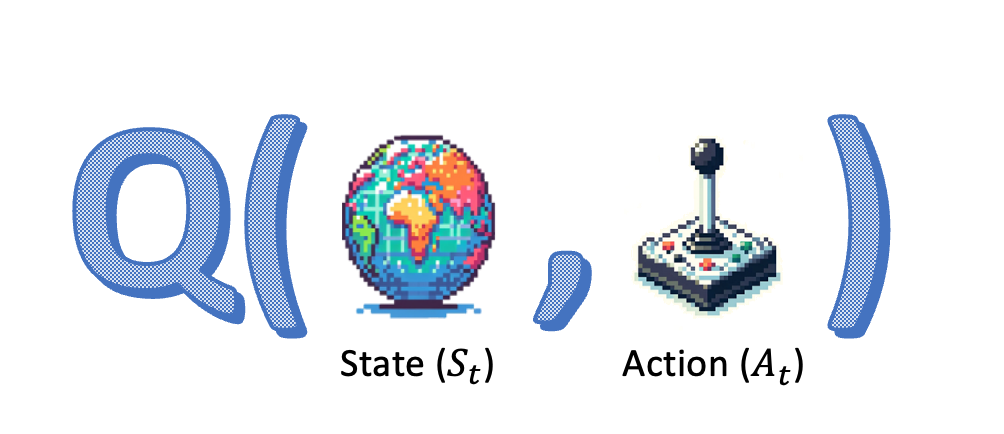
Revisão de Q-Learning
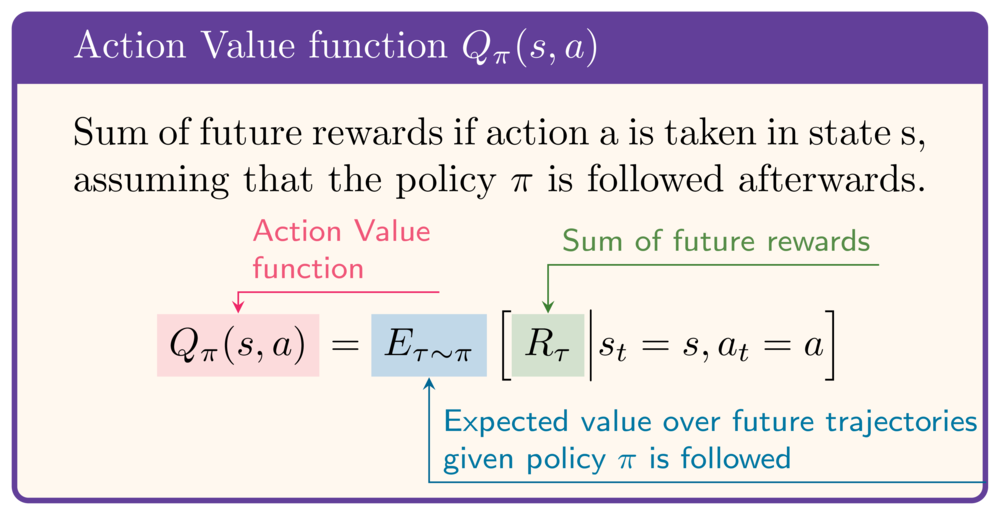
Revisão de Q-Learning
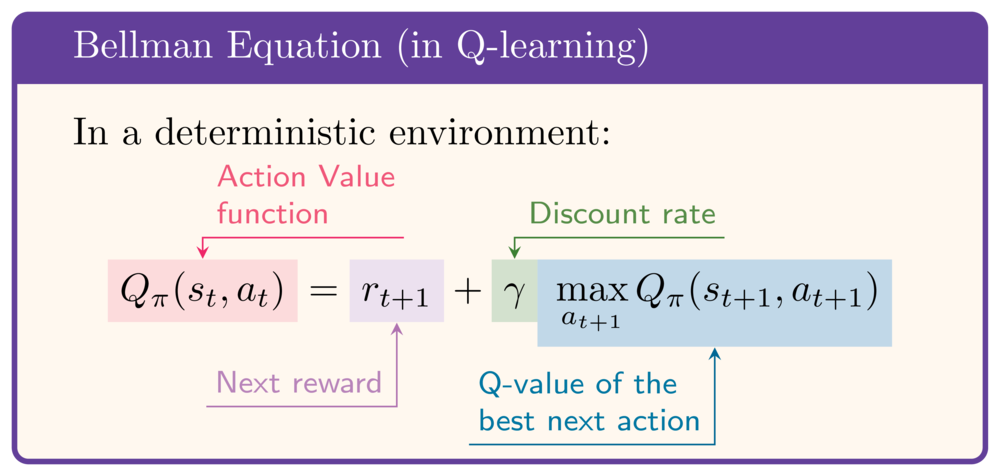
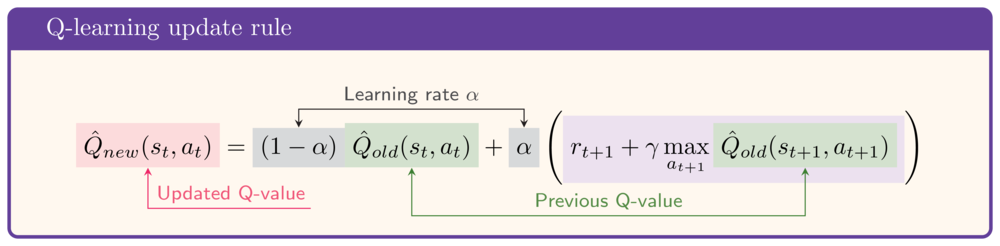
- Equação de Bellman: fórmula recursiva para $Q$
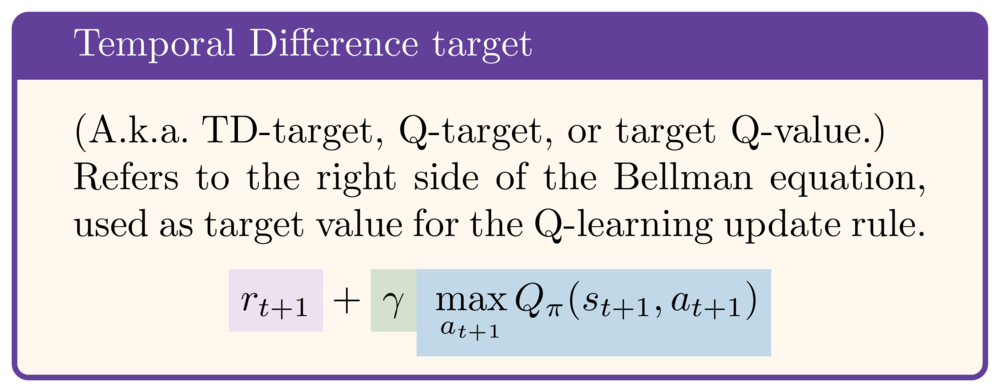
- Lado direito da Equação de Bellman: "TD-target"
- Use o TD-target da Equação de Bellman para atualizar $\hat{Q}$ a cada passo
A Q-Network
A Q-Network
A Q-Network
A Q-Network
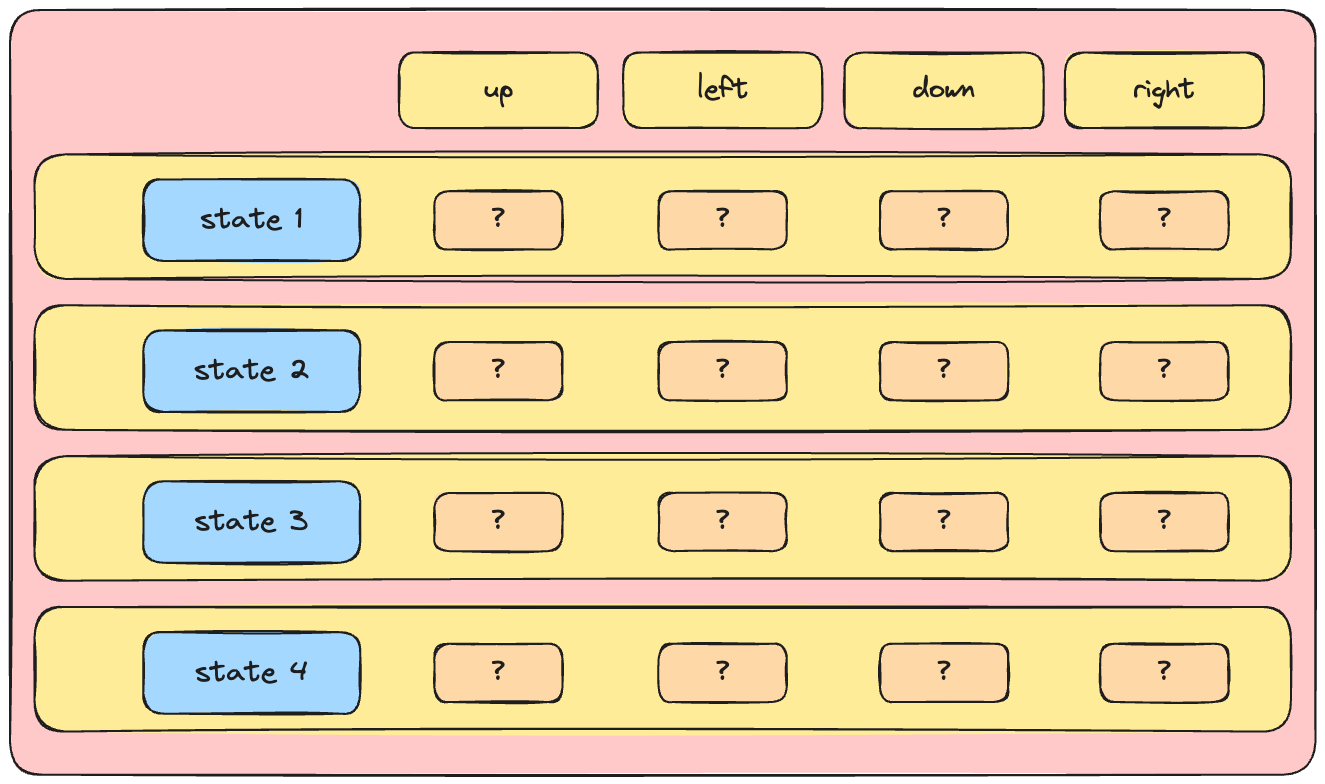
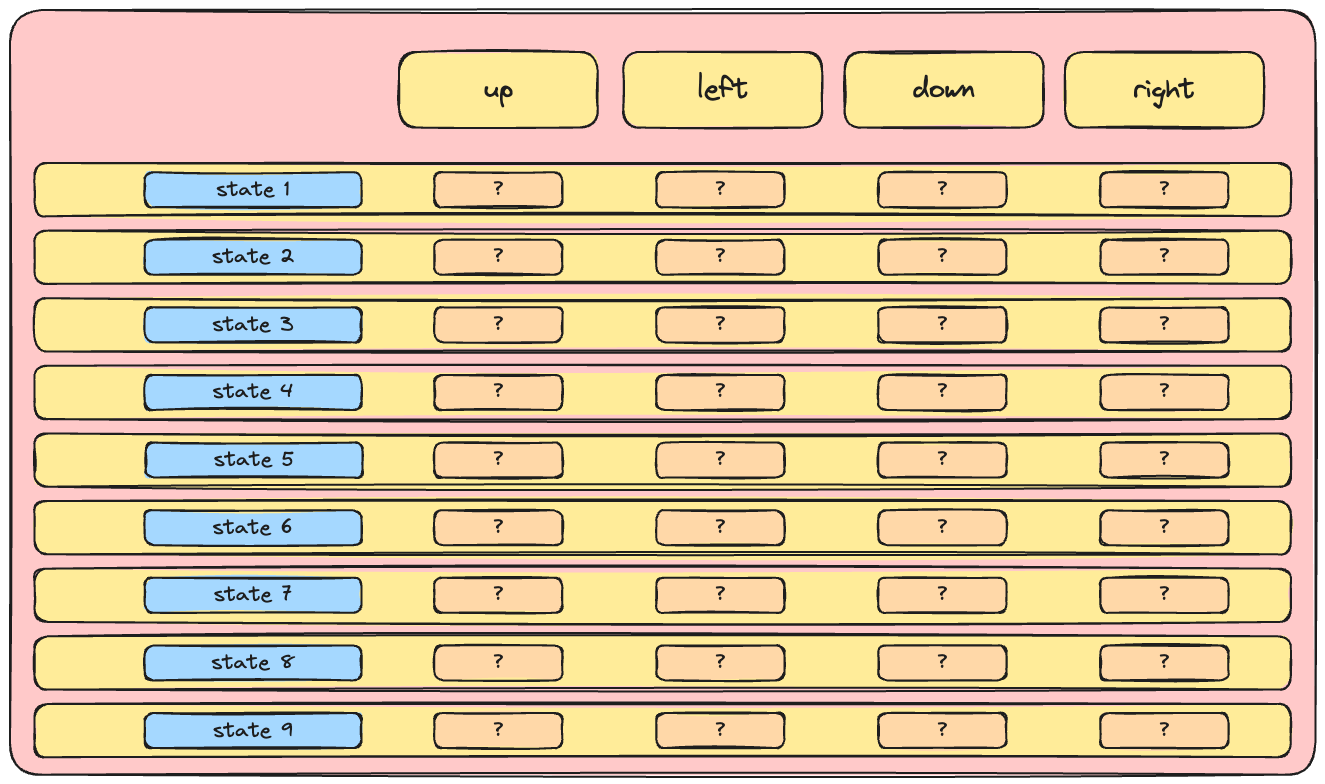
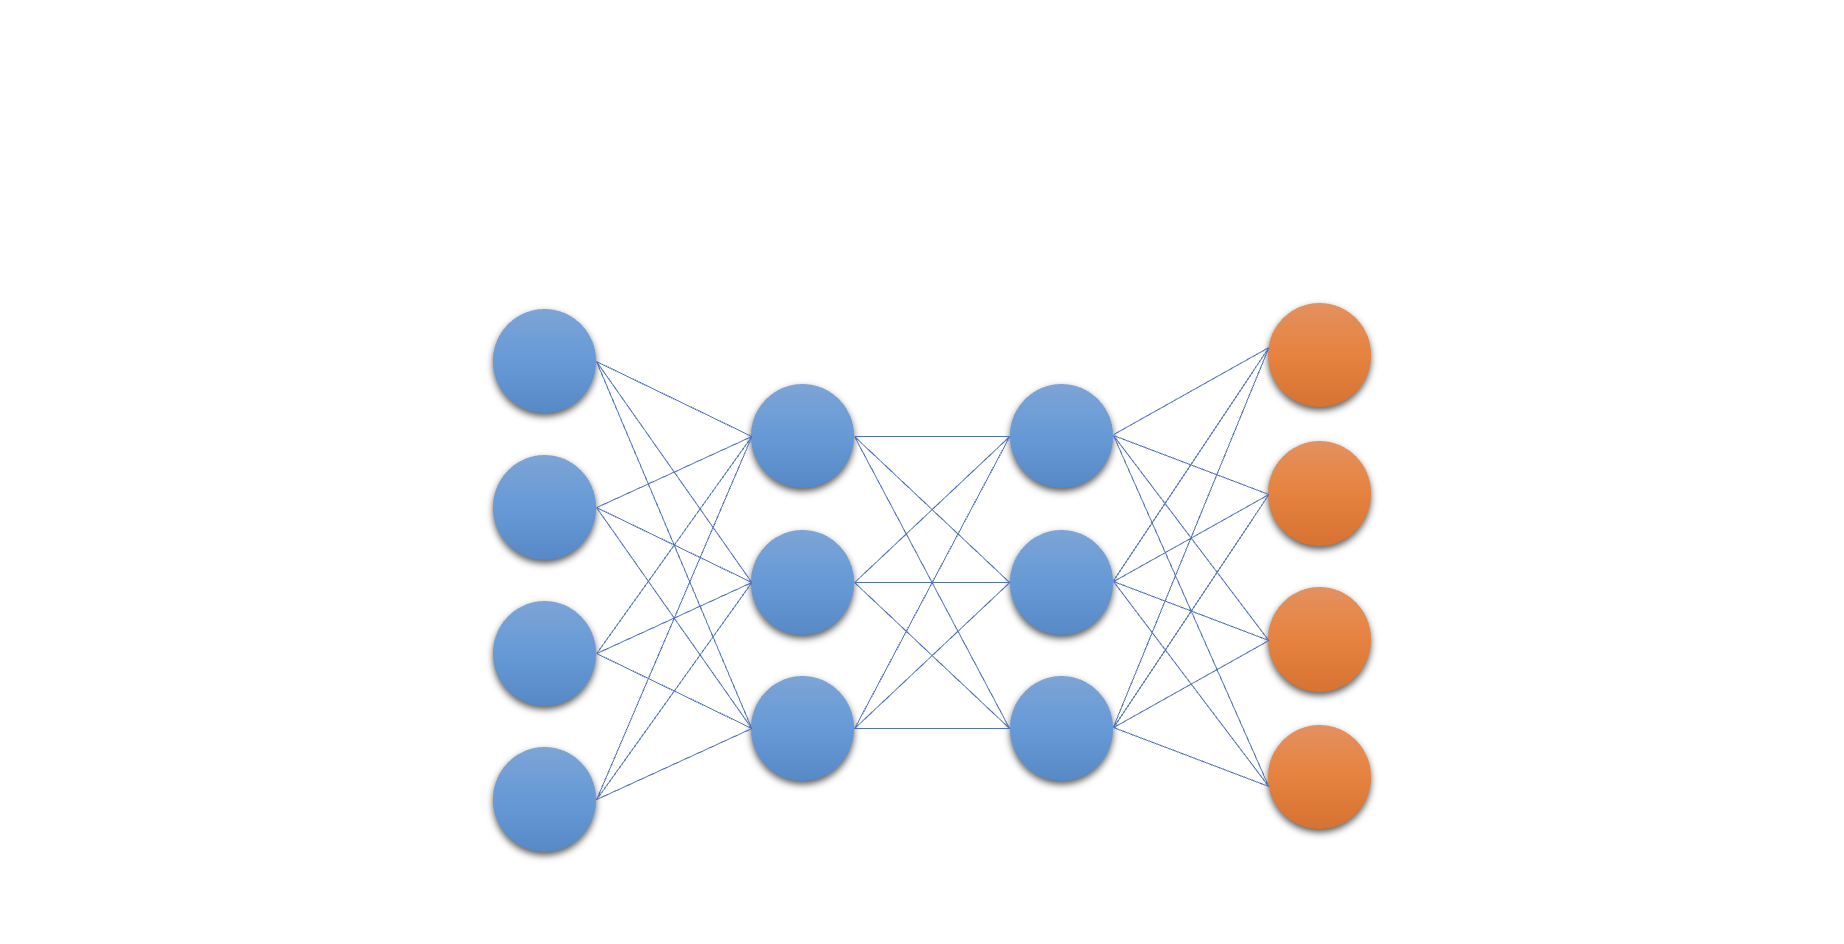
- No núcleo do Deep Q Learning: uma rede neural
A Q-Network
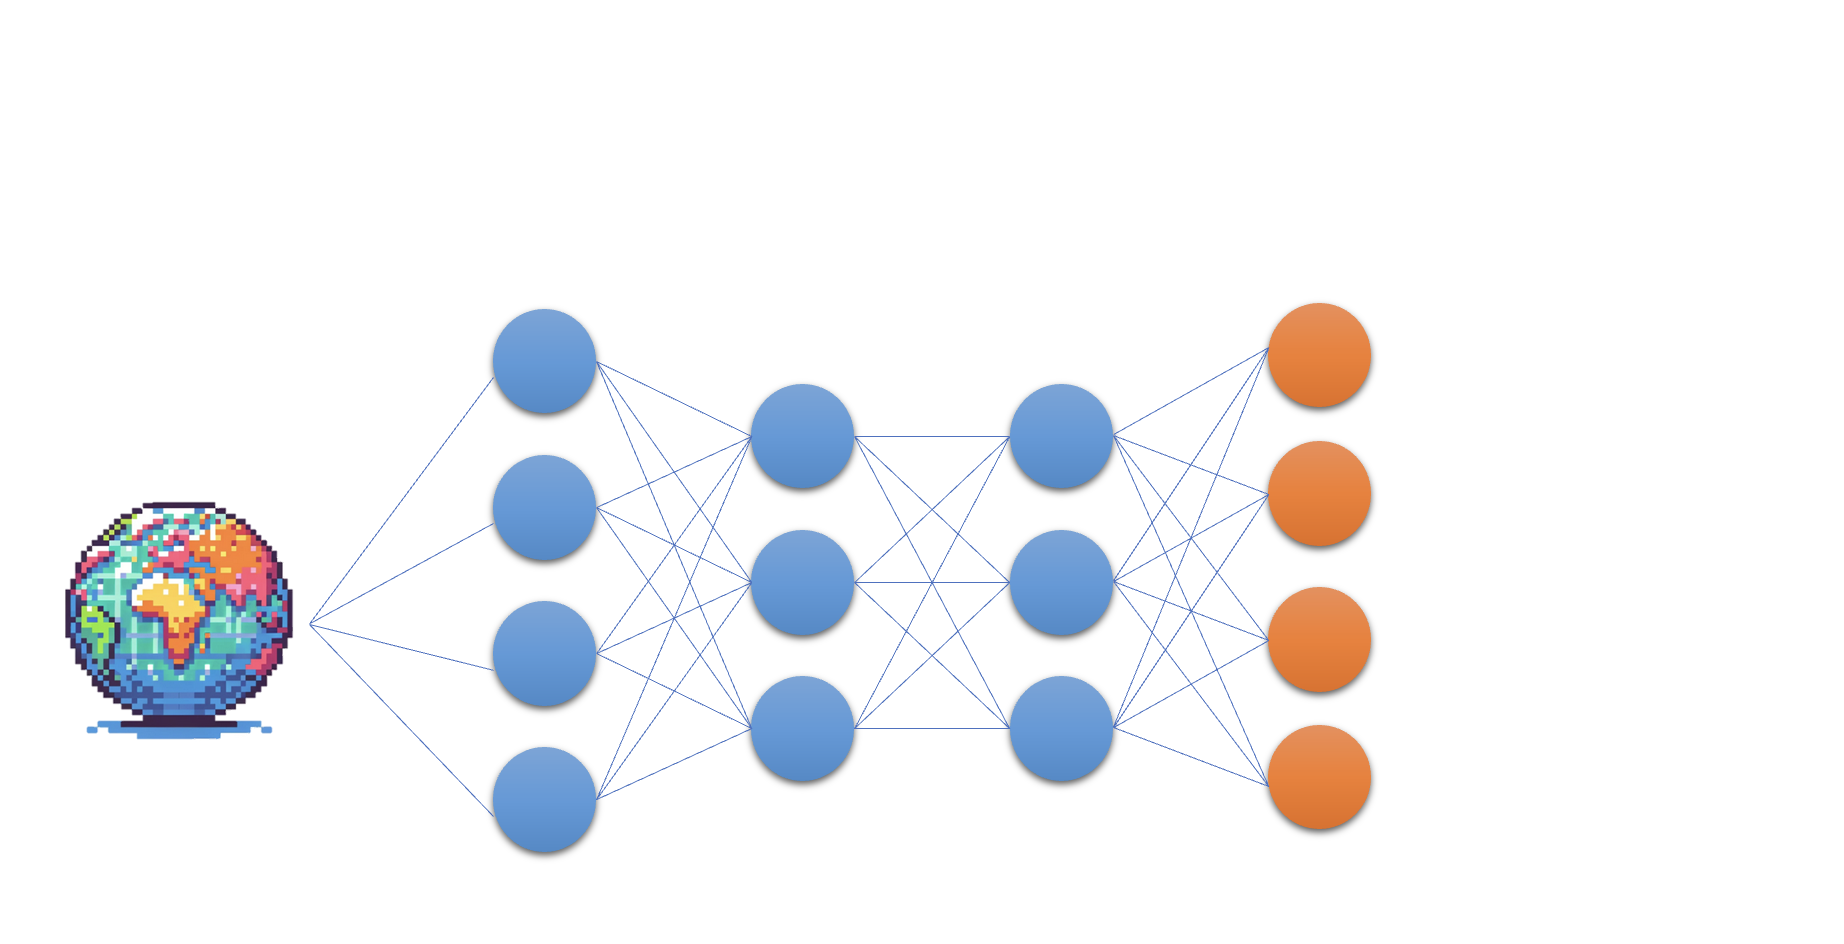
- No núcleo do Deep Q Learning: uma rede neural
A Q-Network
- No núcleo do Deep Q Learning: uma rede neural que mapeia estado para valores Q
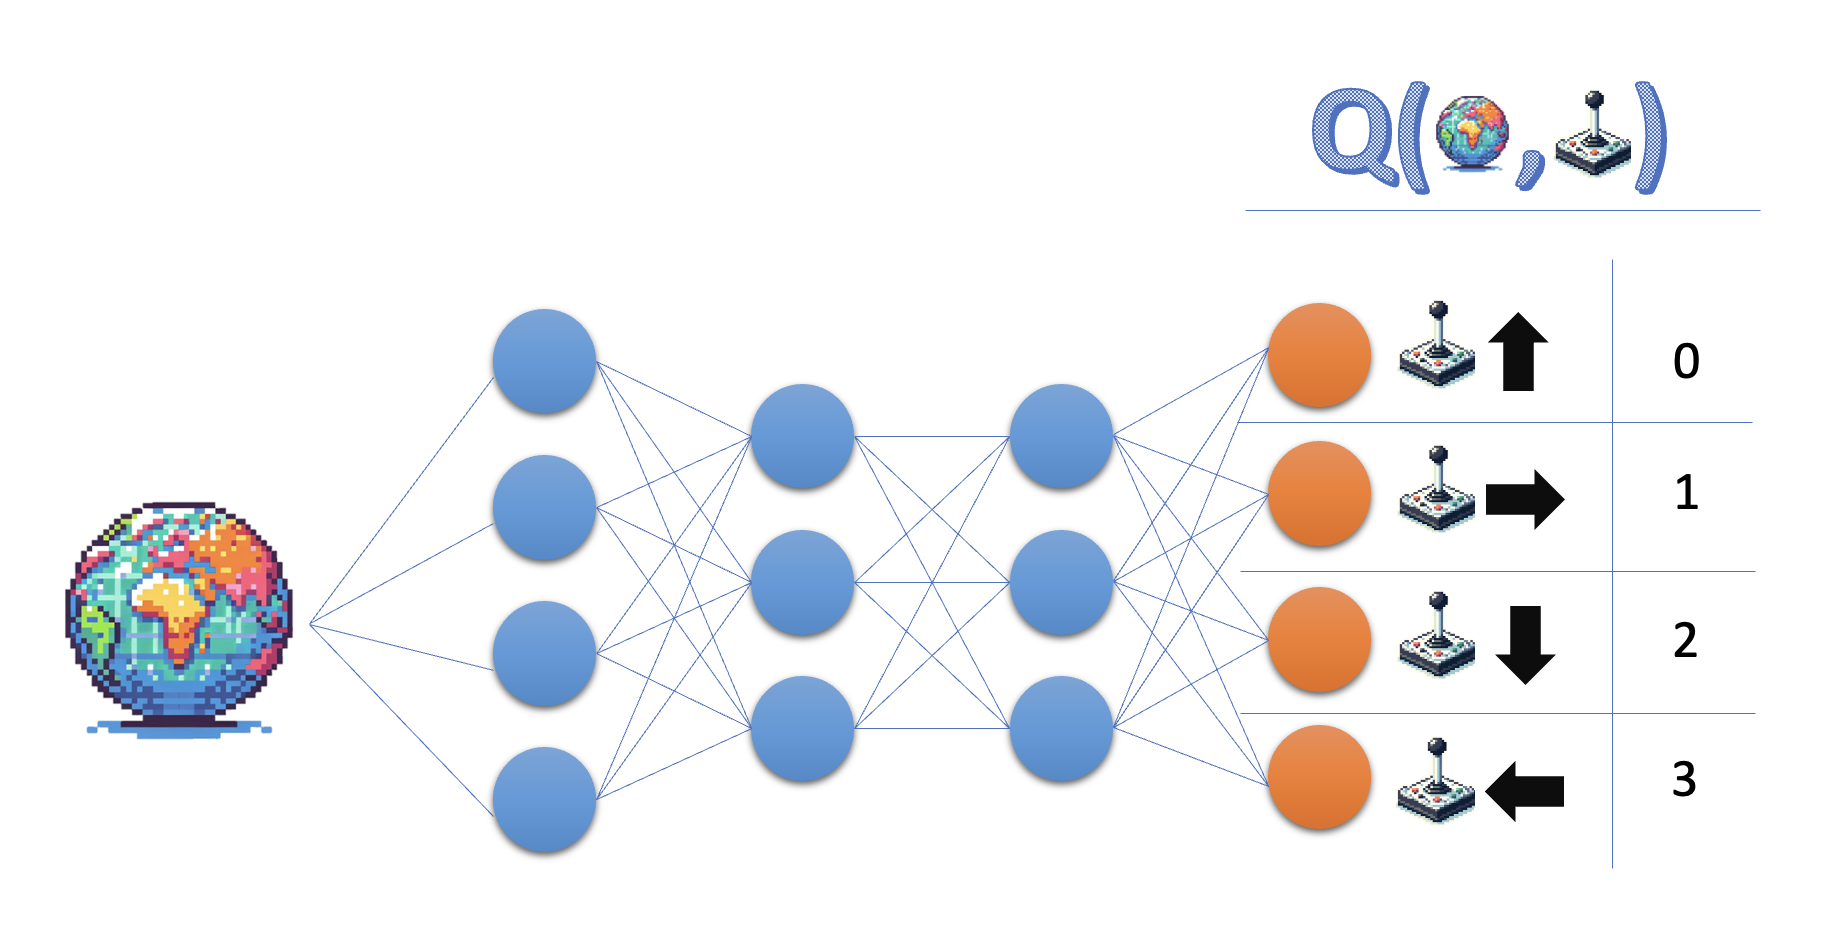
- Uma rede que aproxima a função valor-ação é chamada "Q-network"
- Q-networks são comuns em algoritmos de Deep Q Learning, como DQN.

