DQN com experience replay

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Introdução ao experience replay
 

  • DQN básico aprende só com a experiência mais recente
    • Atualizações consecutivas são altamente correlacionadas
    • O agente esquece rápido
  • Solução: Experience Replay
    • Guarde experiências em um buffer
    • A cada passo, aprenda com um lote aleatório de experiências passadas


Uma foto aérea de um labirinto de cercas-vivas

Aprendizado por reforço profundo em Python

A fila dupla (Double-Ended Queue)


from collections import deque

# Instantiate with limited capacity buffer = deque([1,2,3,4], maxlen=7)
# Extend to the right side buffer.extend([5,6,7,8])
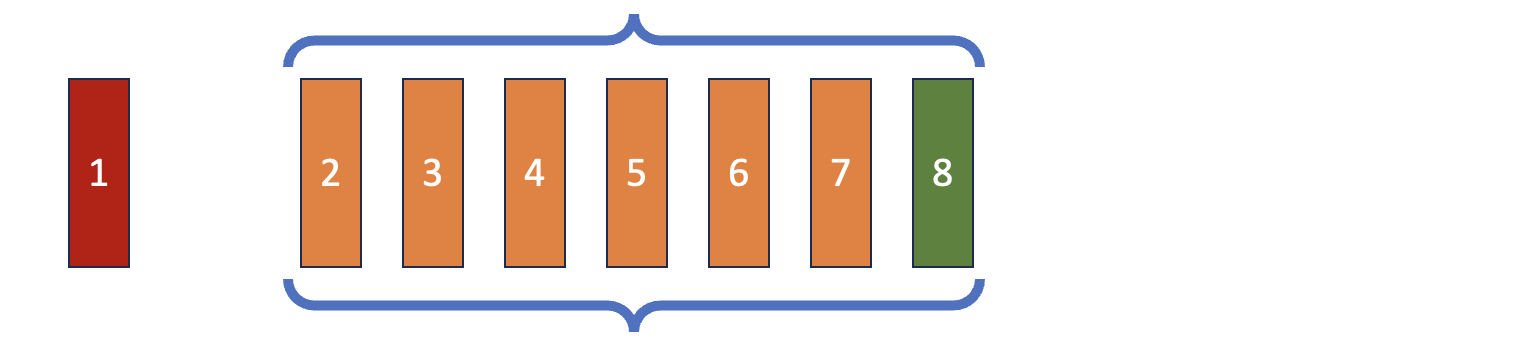
  • Ao exceder a capacidade, os itens mais antigos são descartados

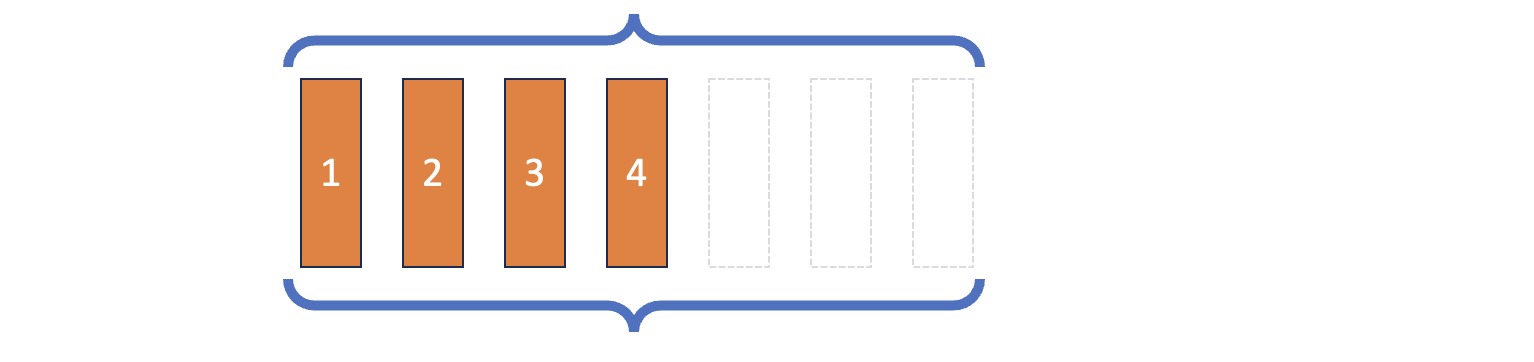
Uma deque com capacidade para sete, contendo quatro elementos rotulados de um a quatro.

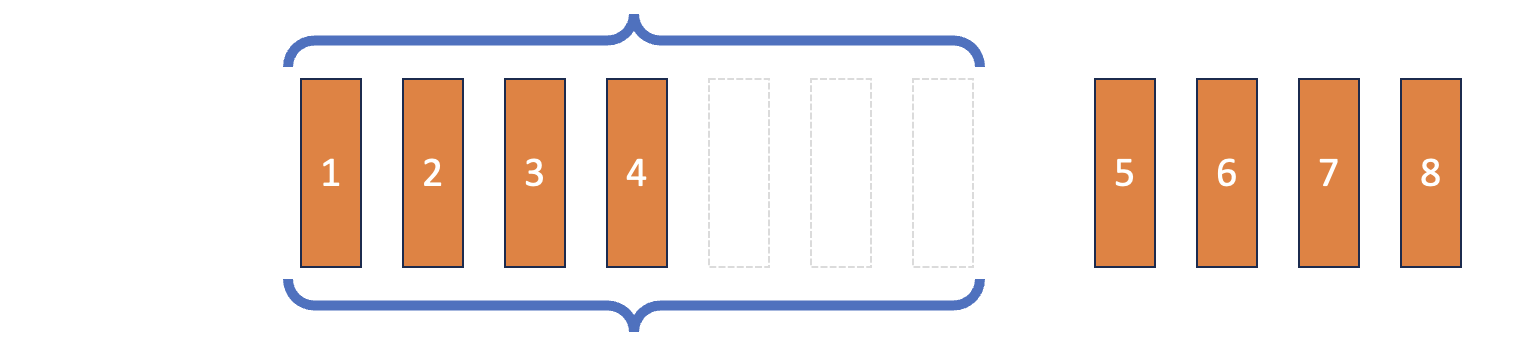
Uma deque com capacidade para sete, contendo quatro elementos rotulados de um a quatro. Quatro elementos adicionais, cinco a oito, visíveis à direita.

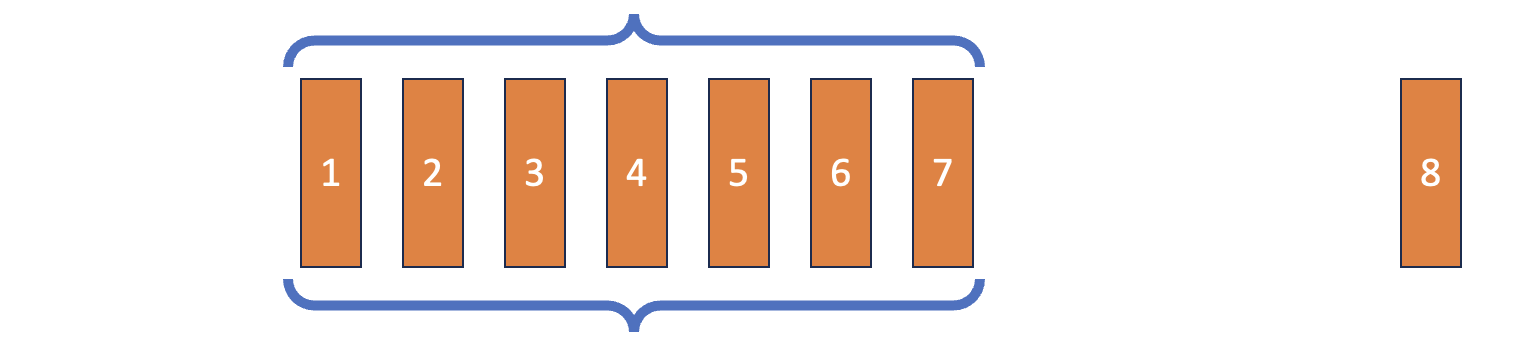
Uma deque com capacidade para sete, contendo sete elementos rotulados de um a sete. Um elemento adicional, 8, visível à direita.

Uma deque com capacidade para sete, contendo sete elementos rotulados de dois a oito. Um elemento adicional, 1, visível à esquerda.

Aprendizado por reforço profundo em Python

Implementando o Replay Buffer

import random

class ReplayBuffer:
def __init__(self, capacity):
self.memory = deque([], maxlen=capacity)
def push(self, state, action, reward, next_state, done):
experience_tuple = (state, action, reward, next_state, done)
self.memory.append(experience_tuple)
def __len__(self): return len(self.memory)
...
  • Memória de replay: deque com capacidade limitada
  • .push():
    • Experiência como tupla de transição
    • Adiciona a experiência ao buffer
    • No limite: descarta a mais antiga
Aprendizado por reforço profundo em Python

Implementando o Replay Buffer

...
def sample(self, batch_size):

batch = random.sample(self.memory, batch_size)
states, actions, rewards, next_states, dones = ( zip(*batch))
states_tensor = torch.tensor( states, dtype=torch.float32) ... # repeat identically for # rewards, next_states, dones
actions_tensor = torch.tensor( actions, dtype=torch.long).unsqueeze(1)
return states_tensor, actions_tensor, rewards_tensor, next_states_tensor, dones_tensor


  • Amostra aleatória de experiências passadas
  • batch: de lista de tuplas de transição...
  • ...para tupla de listas...
  • ...para tupla de tensores PyTorch
Aprendizado por reforço profundo em Python

Integrando Experience Replay no DQN

  1. Antes do loop de treino: replay_buffer = ReplayBuffer(10000)

  2. No loop de treino, após selecionar a ação:

replay_buffer.push((state, action, 
                    reward, next_state, done))

if len(replay_buffer) >= batch_size:
states, actions, rewards, next_states, dones = ( replay_buffer.sample(batch_size))
q_values = ( q_network(states).gather(1, actions).squeeze(1))
next_states_q_values = q_network(next_states).amax(1)
target_q_values = ( rewards + gamma * next_states_q_values * (1-dones))
loss = nn.MSELoss()(target_q_values, q_values)
  • Inicialize o replay buffer
  • Envie a transição mais recente para o buffer

Se o tamanho do buffer $\geq$ batch_size:

  • Extraia um lote aleatório do buffer e calcule a loss
  • Cálculo da loss conceitualmente inalterado
  • Mean Squared Bellman Error em um lote da replay memory
    • Aprendizado mais estável e eficiente
Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...