Aprendizado por reforço profundo em Python
Timothée Carayol
Principal Machine Learning Engineer, Komment
| Exemplos |
|---|
| Taxa de desconto |
| PPO: clipping epsilon, bônus de entropia |
| Experience replay: tamanho do buffer, tamanho do lote |
| Agenda de ganância epsilon decrescente |
| Fixed Q-targets: $\tau$ |
| Taxa de aprendizado |
| Número de camadas, nós por camada... |
Objetivo: recompensas cumulativas médias
Técnicas de busca de hiperparâmetros:


Fluxo de trabalho do Optuna:
study do Optuna
import optunadef objective(trial): ...study = optuna.create_study()study.optimize(objective, n_trials=100)
study.best_params
{'learning_rate': 0.001292481, 'batch_size': 8}
Na função objetivo:
Oferece flexibilidade total na especificação:
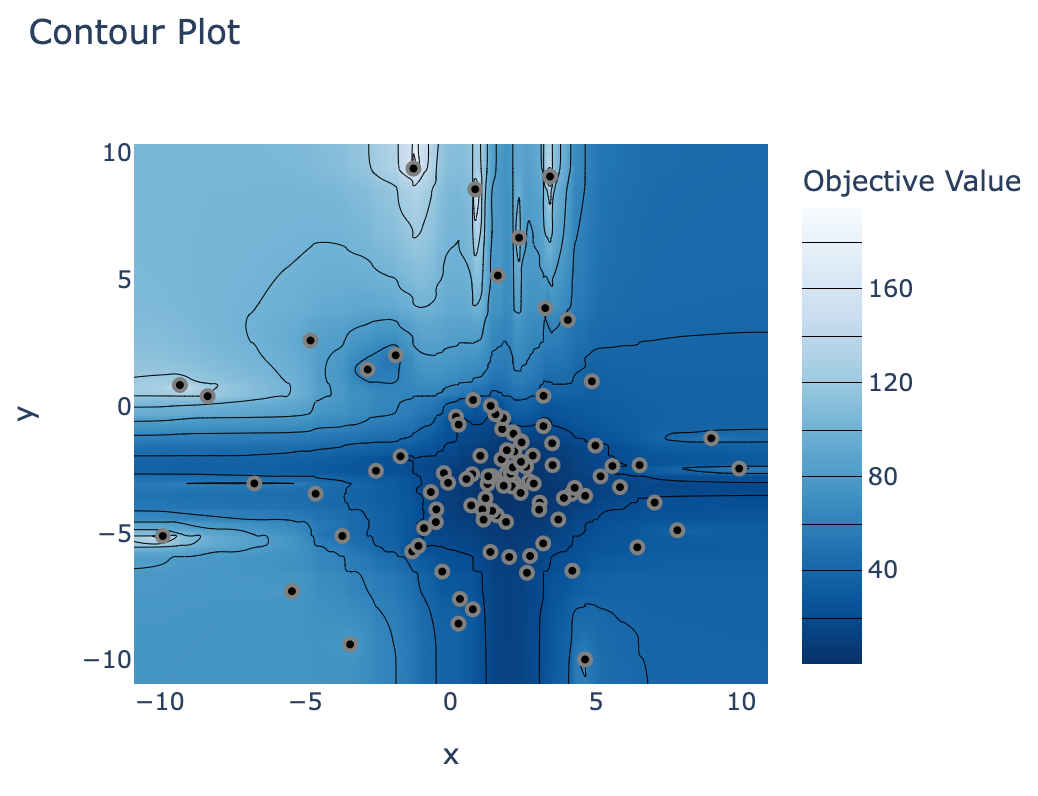
def objective(trial: optuna.trial.Trial):# Hiperparâmetros x e y entre -10 e 10x = trial.suggest_float('x', -10, 10) y = trial.suggest_float('y', -10, 10)# Retorna a métrica a minimizar return (x - 2) ** 2 + 1.2 * (y + 3) ** 2
n_trials com o sampler padrão (TPE)n_trials for omitido: executa até ser interrompido
import sqlite study = optuna.create_study( storage="sqlite:///DRL.db", study_name="my_study")study.optimize(objective, n_trials=100)
loaded_study = optuna.load_study(
study_name="my_study",
storage="sqlite:///DRL.db")
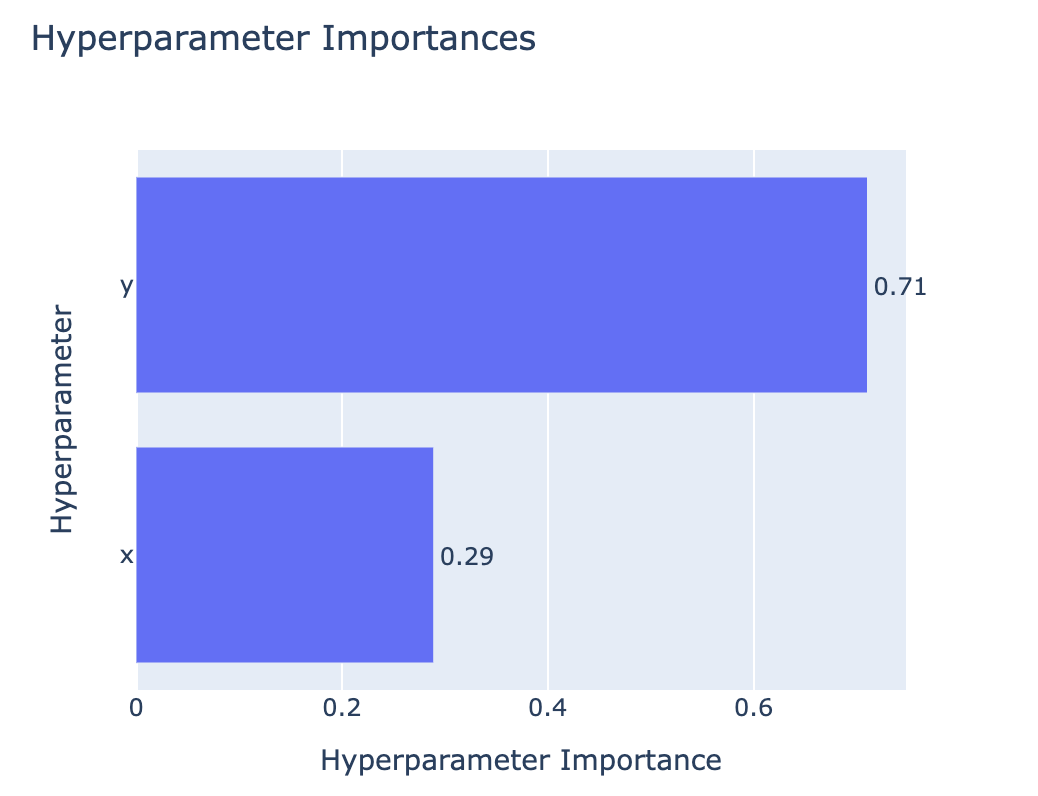
optuna.visualization.plot_param_importances(study)
optuna.visualization.plot_contour(study)
Aprendizado por reforço profundo em Python