O algoritmo DQN básico

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

O DQN básico


  • Primeiro passo rumo ao DQN completo
  • Recursos:
    • Loop genérico de treino em DRL
    • Uma Q-network
    • Princípios de Q-learning
for episode in range(1000):
  state, info = env.reset()
  done = False
  while not done:
    # Action selection
    action = select_action(network, state)
    next_state, reward, terminated, truncated, _ = (
                                   env.step(action))
    done = terminated or truncated
    # Loss calculation
    loss = calculate_loss(network, state, action, 
                          next_state, reward, done)
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    state = next_state
Aprendizado por reforço profundo em Python

Seleção de ação no DQN básico


def select_action(q_network, state):

# Feed state to network to obtain Q-values
q_values = q_network(state)
# Obtain index of action with highest Q-value action = torch.argmax(q_values).item()
return action
  • Política: selecionar a ação com maior Q-value
    • $ a_t = {\arg\max}_a Q(S_t, a) $
    • Aqui: ação 2, com Q-value 0.12


Q-values: [-0.01, 0.08, 0.12, -0.07]

Ação selecionada: 2, com q-value 0.12
Aprendizado por reforço profundo em Python

Função de perda do DQN básico


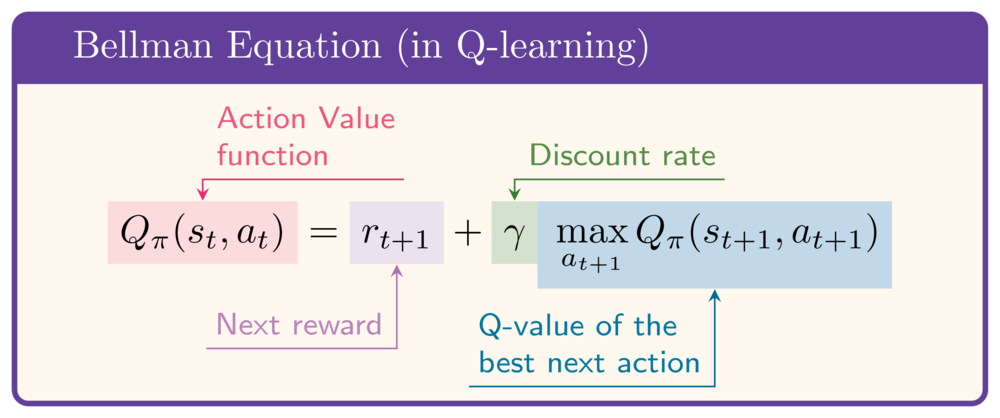
  • A função Valor-Ação satisfaz a Equação de Bellman
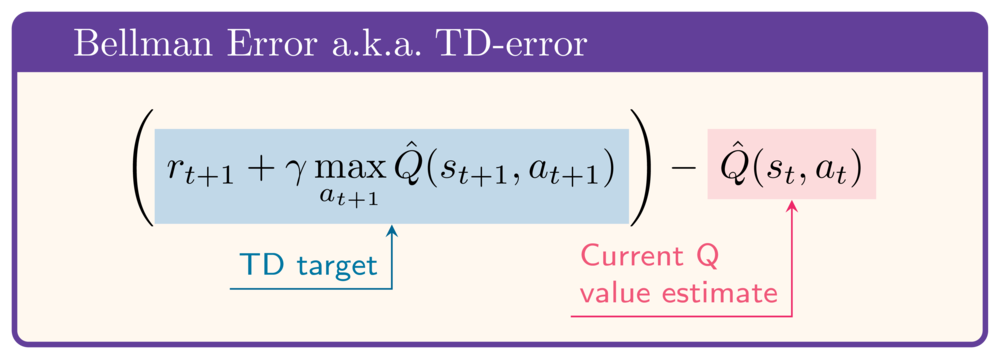
  • Ideia: minimizar a diferença entre os dois lados (TD-error ou erro de Bellman)
  • Use o Erro de Bellman ao quadrado como função de perda:
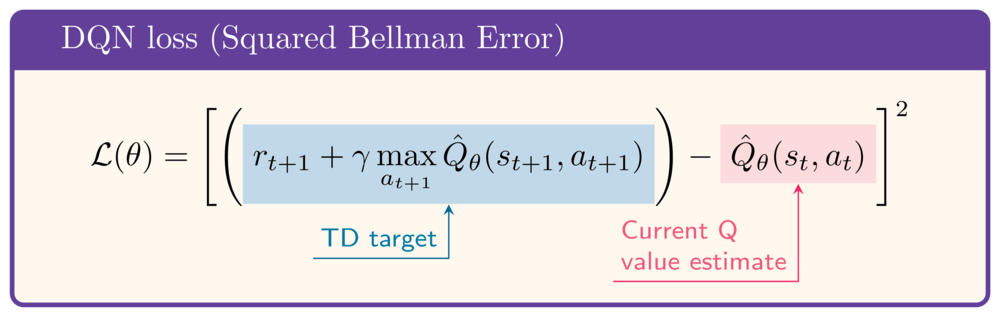
Perda do DQN (Erro de Bellman ao quadrado): L(theta) = quadrado do erro de Bellman


Equação de Bellman Q(S,A) = reward + discount * max(Q(S_next,A))

Erro de Bellman Q(S,A) - (reward + discount * max(Q(S_next,A)))

Aprendizado por reforço profundo em Python

Função de perda do DQN básico

def calculate_loss(
      q_network, state, action,
      next_state, reward, done):

q_values = q_network(state)
current_state_q_value = q_values[action]
next_state_q_value = q_network(next_state).max()
target_q_value = reward + gamma * next_state_q_value * (1-done)
loss = nn.MSELoss()( current_state_q_value, target_q_value)
return loss
  • Q-value do estado atual:

       $Q(s_t, a_t)$

  • Q-value do próximo estado:

       $\max_a Q(s_{t+1}, a)$

  • Q-value alvo:

       $r_{t+1} + \gamma \max_a Q(s_{t+1}, a)$

  • Perda do DQN:

$$\left(Q(s_t, a_t) - (r_{t+1} + \gamma \max_a Q(s_{t+1}, a)\right)^2$$

Aprendizado por reforço profundo em Python

Descrição dos episódios

describe_episode(episode, reward, episode_reward, step)
| Episode    1 | Duration:   84 steps | Return: -871.38 | Crashed  |

| Episode 2 | Duration: 53 steps | Return: -452.68 | Crashed |
| Episode 3 | Duration: 57 steps | Return: -414.22 | Crashed | | Episode 4 | Duration: 54 steps | Return: -475.09 | Crashed |
| Episode 5 | Duration: 67 steps | Return: -532.31 | Crashed | | Episode 6 | Duration: 53 steps | Return: -407.00 | Crashed | | Episode 7 | Duration: 52 steps | Return: -380.45 | Crashed | | Episode 8 | Duration: 55 steps | Return: -380.75 | Crashed | | Episode 9 | Duration: 88 steps | Return: -688.68 | Crashed | | Episode 10 | Duration: 76 steps | Return: -338.06 | Crashed |
Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...