O algoritmo DQN completo

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

O algoritmo DQN


  • Estudamos DQN com Experience Replay
  • Próximo do DQN publicado pela primeira vez (2015)
  • Ainda faltam dois componentes:
    • Epsilon-greediness -> mais exploração
    • Q-targets fixos -> aprendizado mais estável

Uma aventureira em pé, com a letra grega epsilon ao lado

A letra maiúscula Q, congelada em um bloco de gelo

Aprendizado por reforço profundo em Python

Epsilon-greediness no algoritmo DQN

  • Implemente Epsilon-greediness decaído em select_action()
def select_action(q_values, step, start, end, decay):

# Calculate the threshold value for this step epsilon = ( end + (start-end) * math.exp(-step / decay))
# Draw a random number between 0 and 1 sample = random.random()
if sample < epsilon: # Return a random action index return random.choice(range(len(q_values)))
# Return the action index with highest Q-value return torch.argmax(q_values).item()
  • $\varepsilon = end + (start-end) \cdot e^{-\frac{step}{decay}}$
  • Faça uma ação aleatória com probabilidade $\varepsilon$
  • Faça a ação de maior valor com probabilidade $1 - \varepsilon$
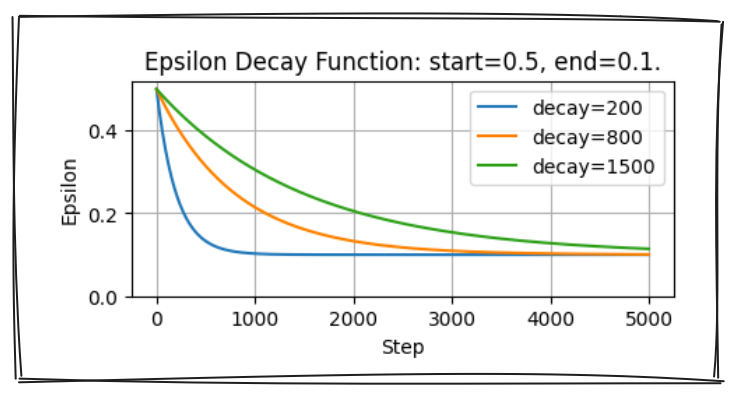
Um gráfico representando o agendamento do decaimento do Epsilon para diferentes valores do parâmetro de decaimento.

Aprendizado por reforço profundo em Python

Q-targets fixos


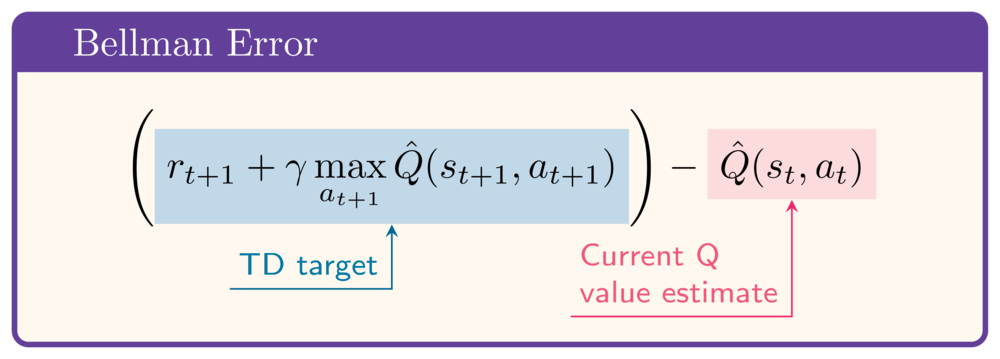
  • No Erro de Bellman:
    • Q-Network em ambos: cálculo do Q-Value e do TD-Target
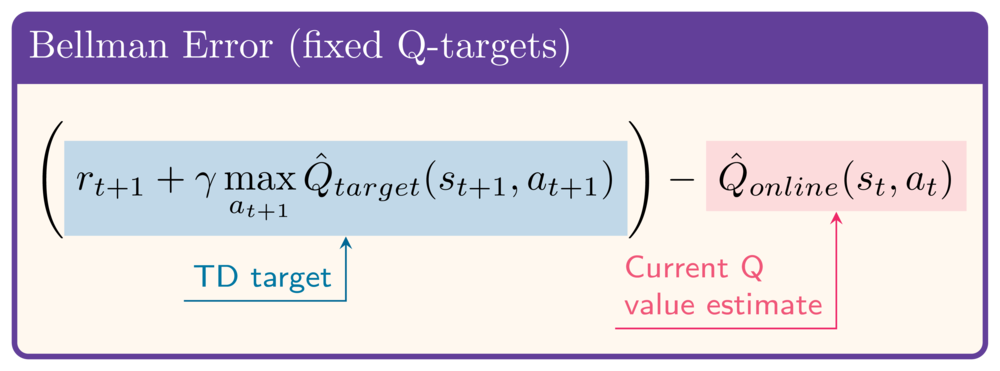
    • Instabilidade por alvo variável


  • Introduza uma rede alvo para estabilizar o alvo


O Erro de Bellman: (r_t+1 + gamma max(Q(s_t+1, a))) - Q(s_t, a_t)

(r_t+1 + gamma max(Q_target(s_t+1, a))) - Q_online(s_t, a_t)

Aprendizado por reforço profundo em Python

Implementando Q-targets fixos

online_network = QNetwork(state_size, action_size)
target_network = QNetwork(state_size, action_size)

target_network.load_state_dict( online_network.state_dict())
def update_target_network( target_network, online_network, tau):
target_net_state_dict = target_network.state_dict() online_net_state_dict = online_network.state_dict() for key in online_net_state_dict:
target_net_state_dict[key] = ( online_net_state_dict[key] * tau + target_net_state_dict[key] * (1 - tau))
target_network.load_state_dict( target_net_state_dict)
return None
  • Inicialmente Online Network = Target Network
  • O state dict de uma rede contém todos os pesos: a representação de um dicionário de estado de rede, com entradas para fc1.weight, fc1.bias e fc2.weight; o valor de cada entrada é um tensor.
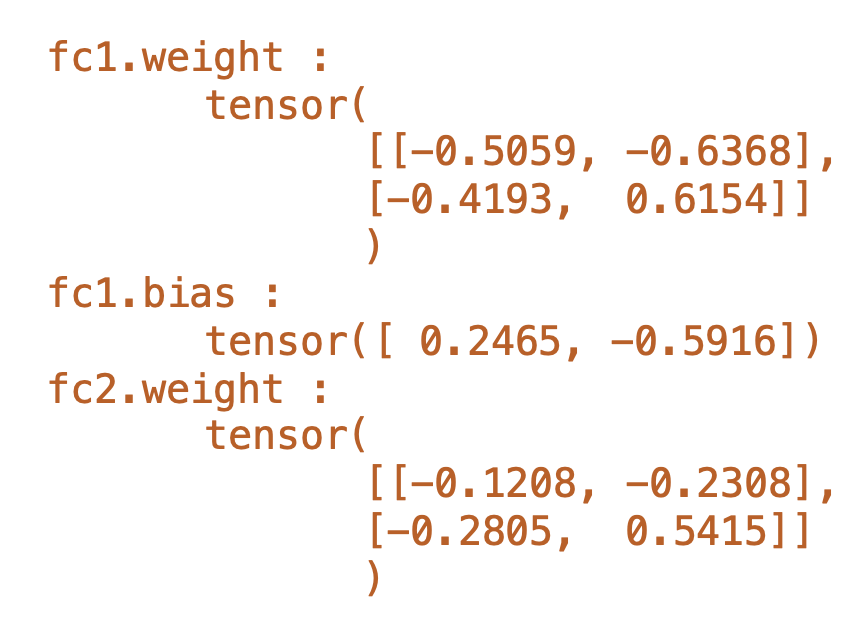
  • A cada passo, cada peso da Target Network fica um pouco mais perto da Online Network
Aprendizado por reforço profundo em Python

Cálculo da perda com Q-targets fixos

# In the inner loop, after action selection
if len(replay_buffer) >= batch_size:
  states, actions, rewards, next_states, dones = 
      replay_buffer.sample(64)

q_values = (online_network(states) .gather(1, actions).squeeze(1))
with torch.no_grad():
next_q_values = ( target_network(next_states).amax(1)) target_q_values = ( rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(target_q_values, q_values) optimizer.zero_grad() loss.backward() optimizer.step()
update_target_network( target_network, online_network, tau)


  • Q-values usam online_network
  • Target Q-values usam target_network
  • Use torch.no_grad() para desativar o rastreamento de gradiente dos target Q-values
  • Ainda use Mean Squared Bellman Error no cálculo da perda
  • Use update_target_network() para atualizar lentamente a target_network
Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...