Atualizações em lote no policy gradient

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Atualizações de gradiente passo a passo vs. em lote
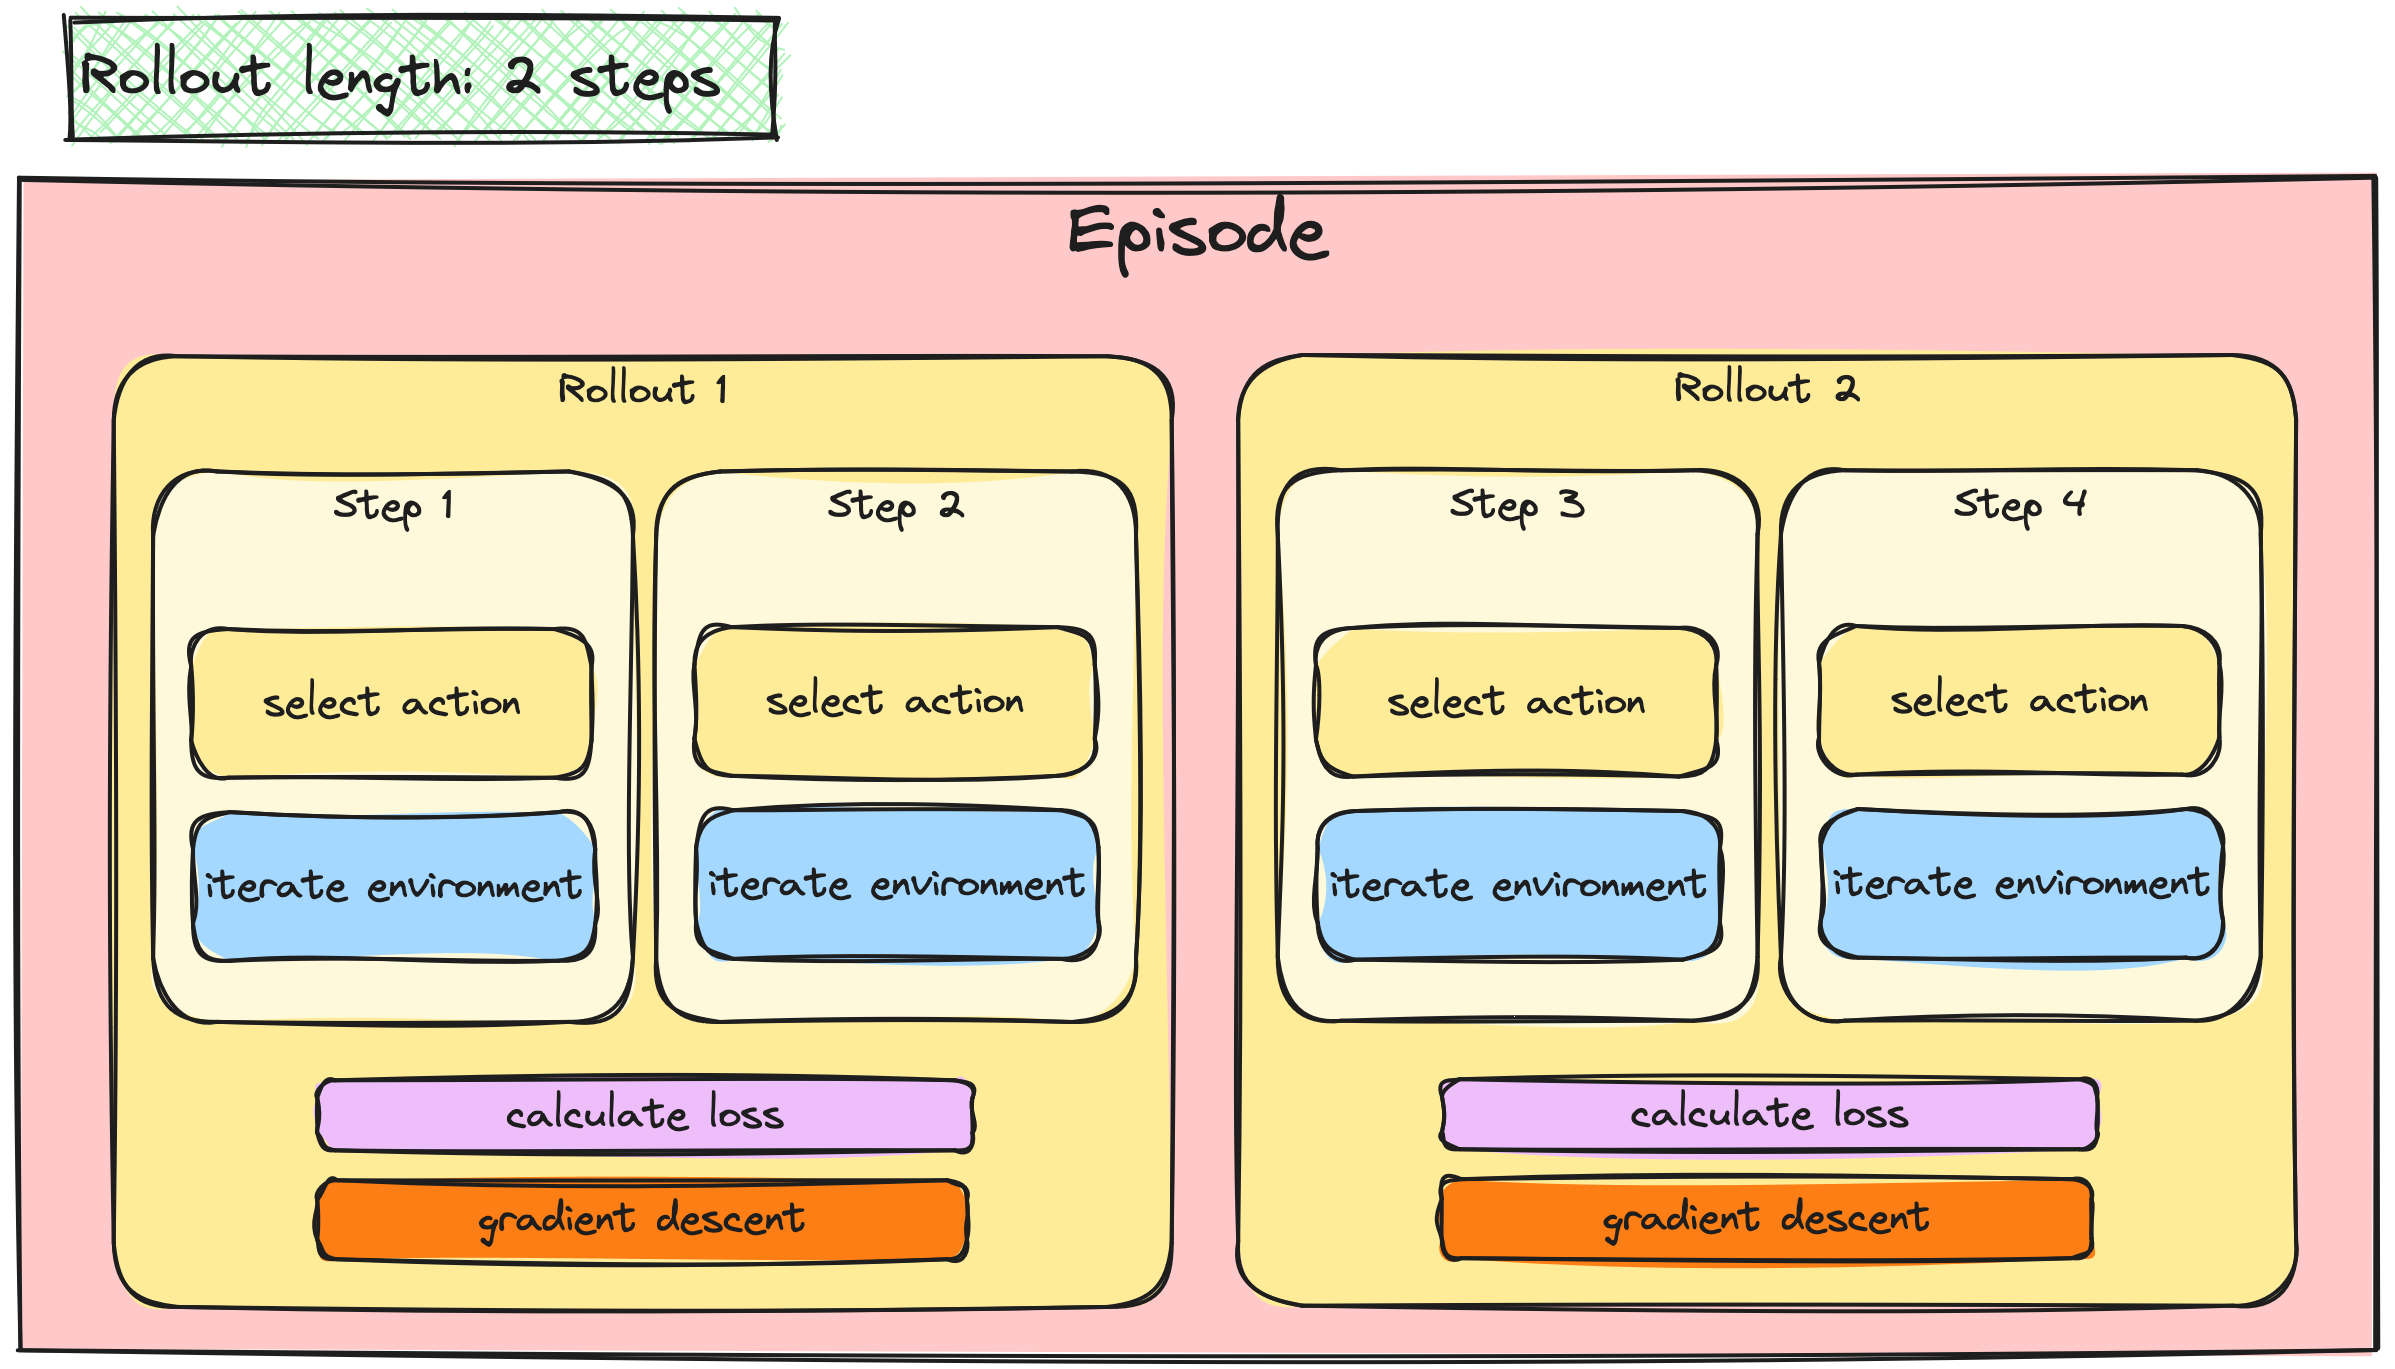
Uma caixa grande representando um episódio.

Aprendizado por reforço profundo em Python

Atualizações de gradiente passo a passo vs. em lote
Na caixa grande, aparece uma menor, representando o passo 1. Dentro dela, outra caixa com o texto 'select action'.

Aprendizado por reforço profundo em Python

Atualizações de gradiente passo a passo vs. em lote
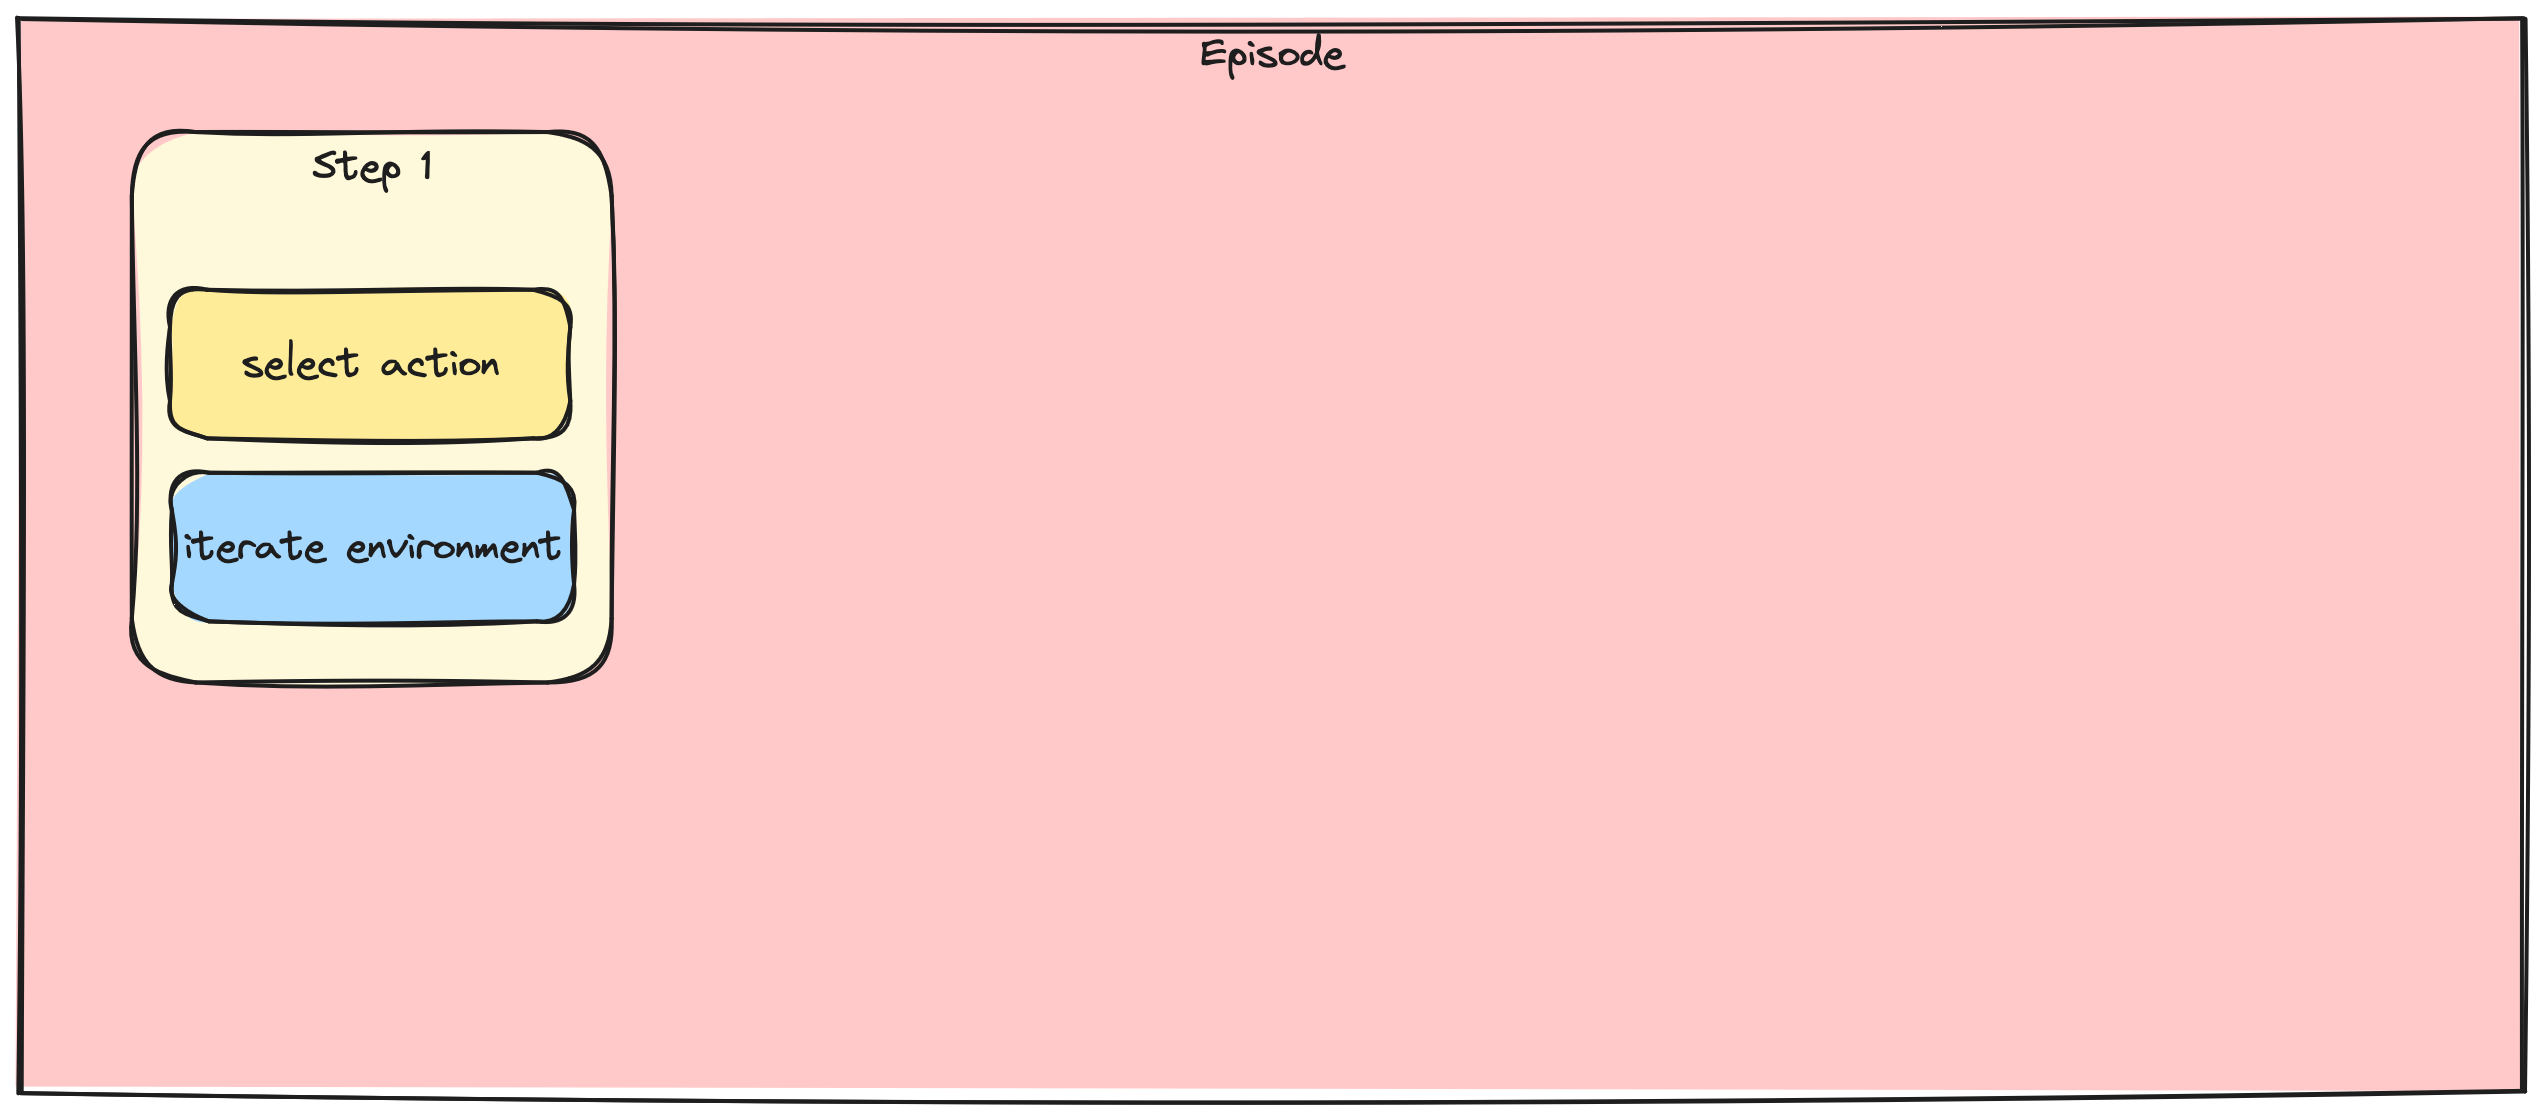
Na caixa do passo 1, aparece outra caixa menor com o texto 'iterate environment'

Aprendizado por reforço profundo em Python

Atualizações de gradiente passo a passo vs. em lote
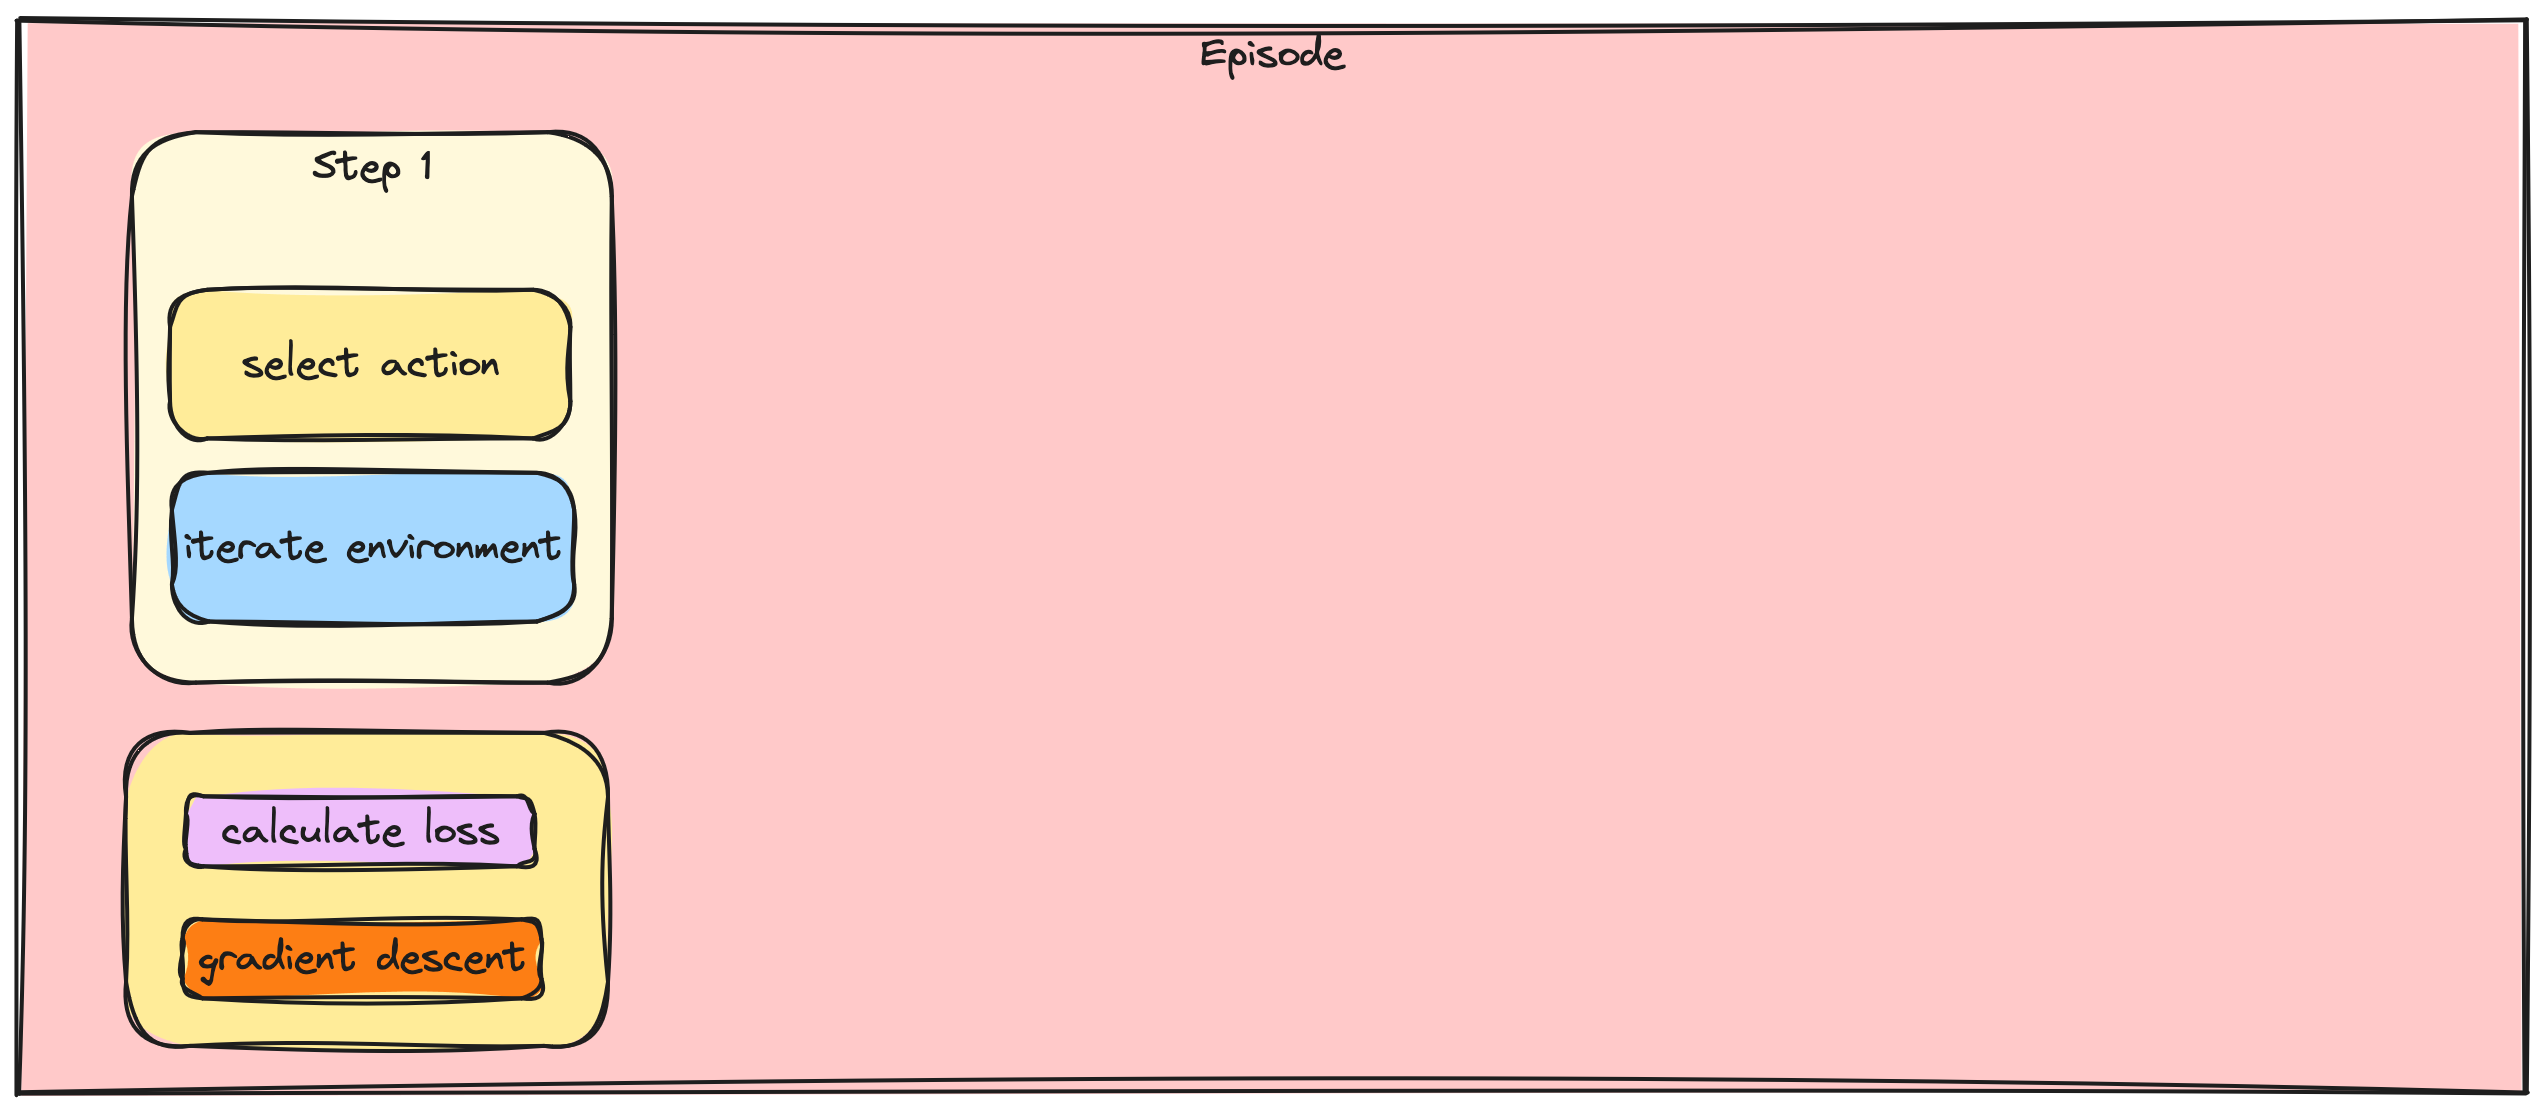
Abaixo da caixa do passo 1, outra caixa com os rótulos 'calculate loss' e 'gradient descent'

Aprendizado por reforço profundo em Python

Atualizações de gradiente passo a passo vs. em lote
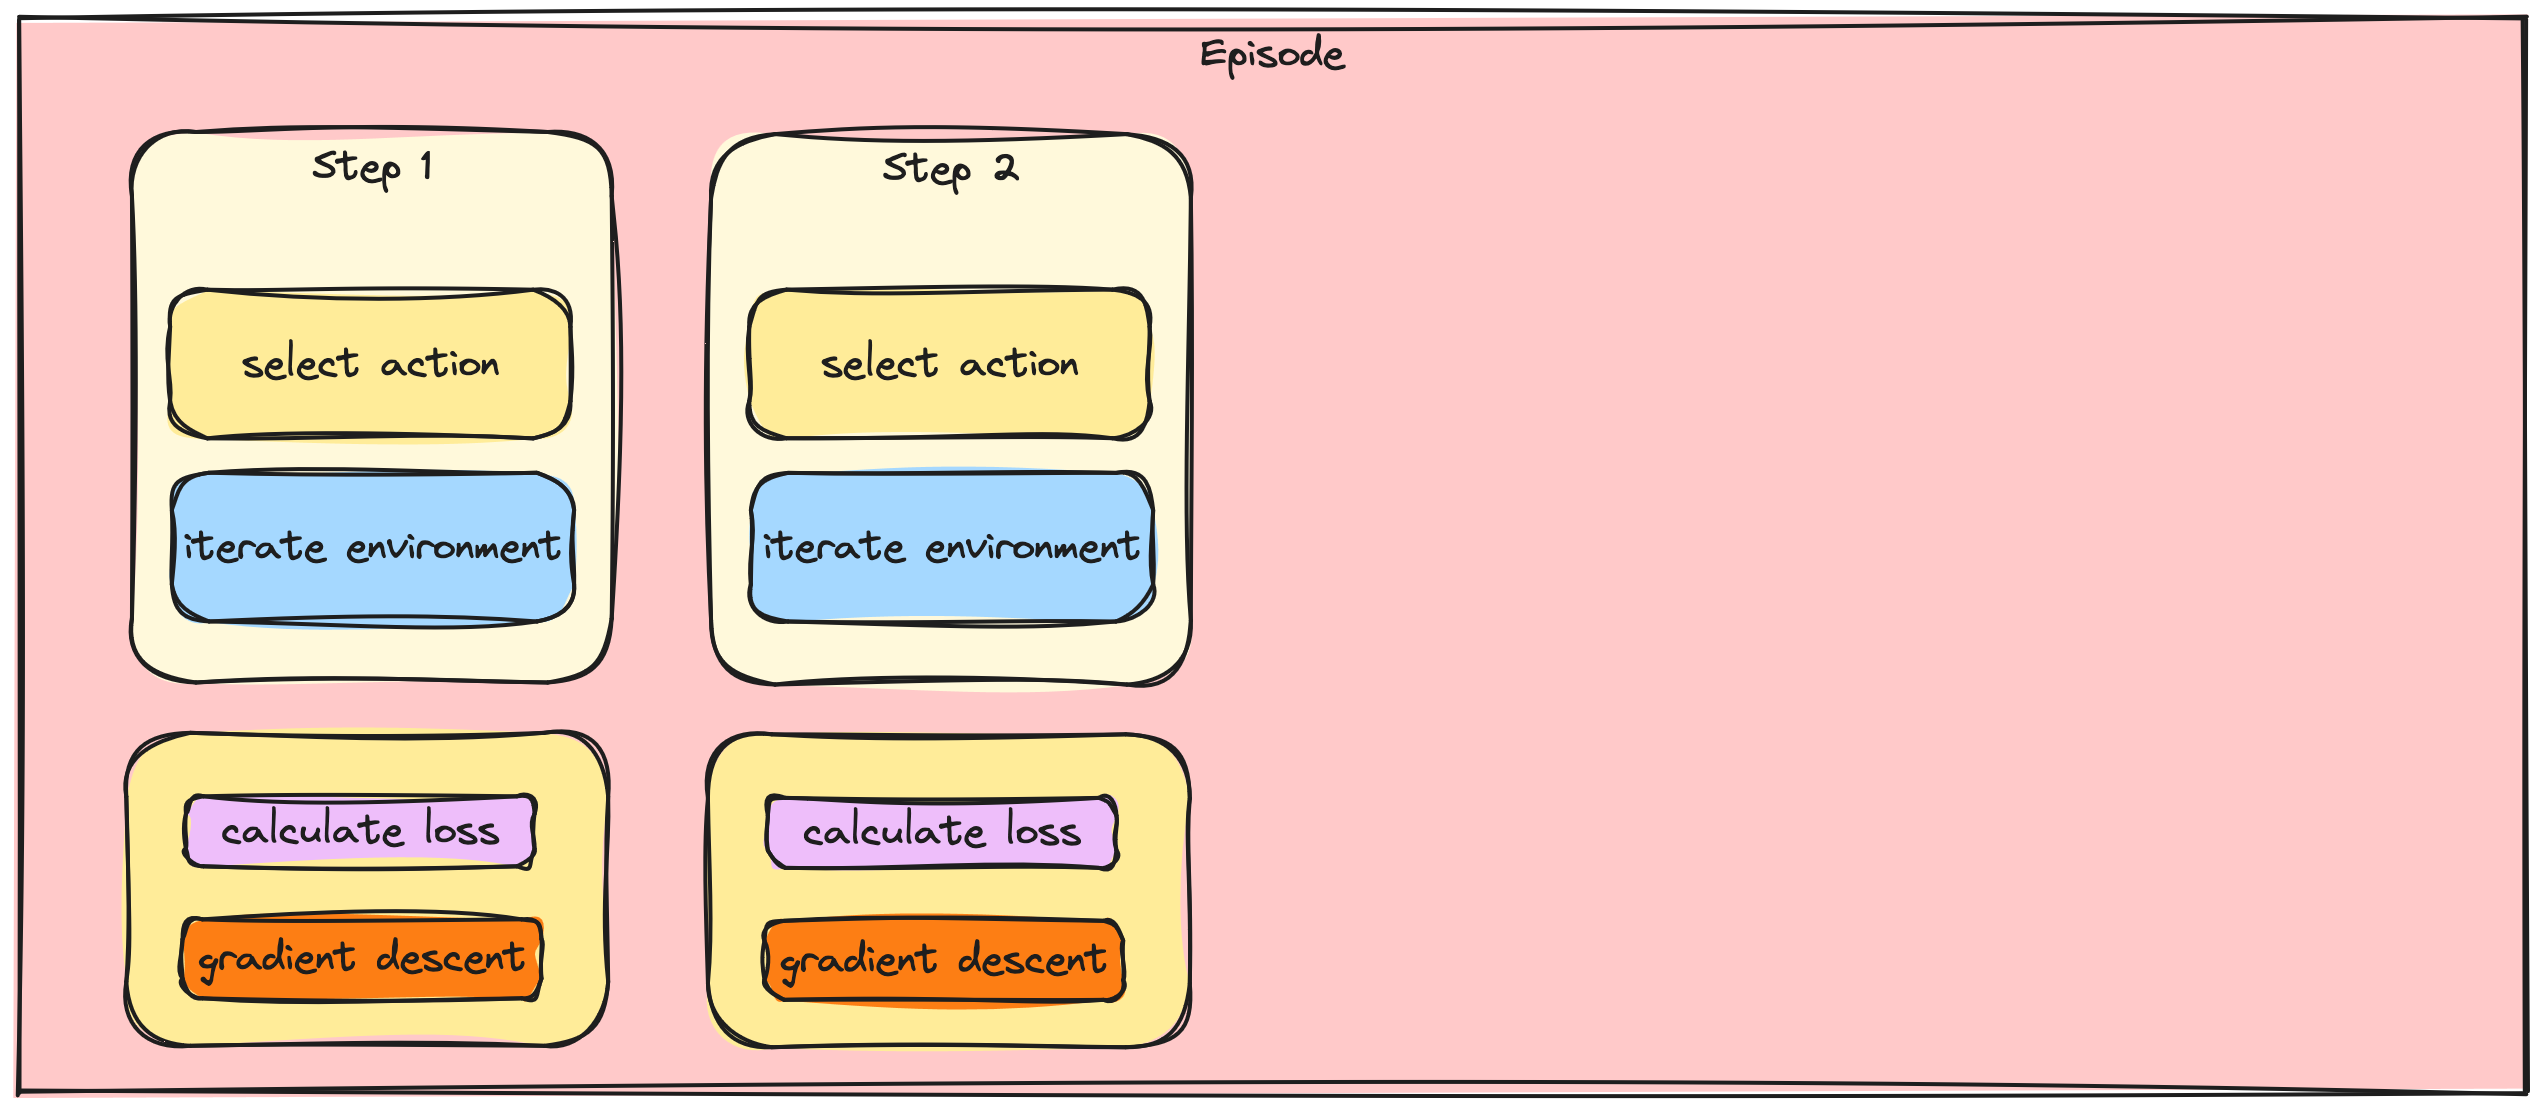
Surge um par idêntico de caixas para o segundo passo, com o mesmo conteúdo

Aprendizado por reforço profundo em Python

Atualizações de gradiente passo a passo vs. em lote
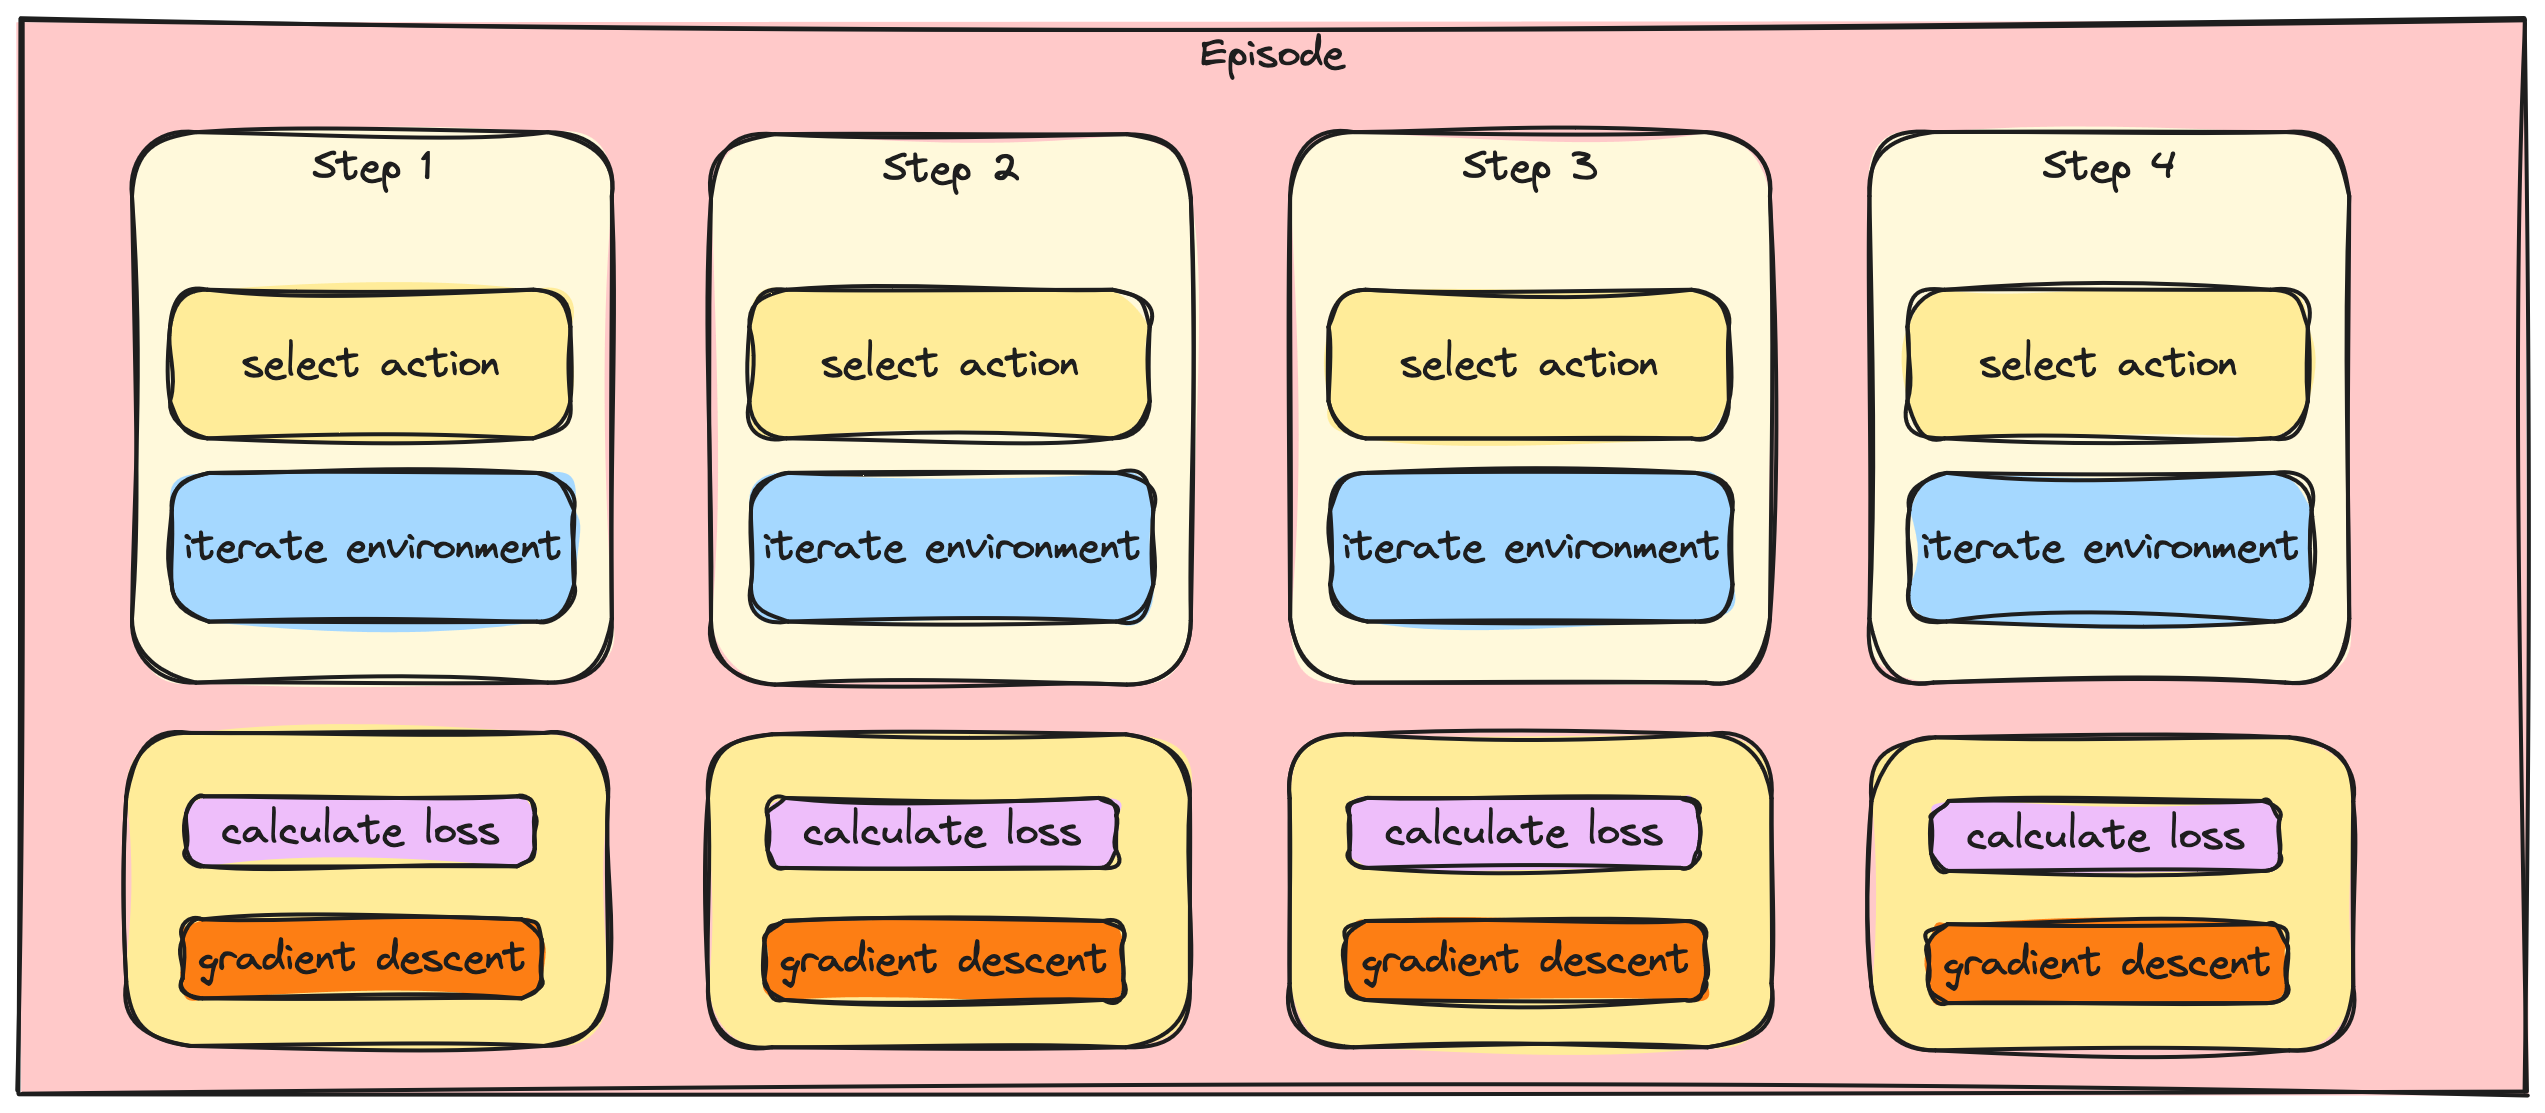
Os passos 3 e 4 também aparecem.

Aprendizado por reforço profundo em Python

Lotes nas atualizações do A2C / PPO

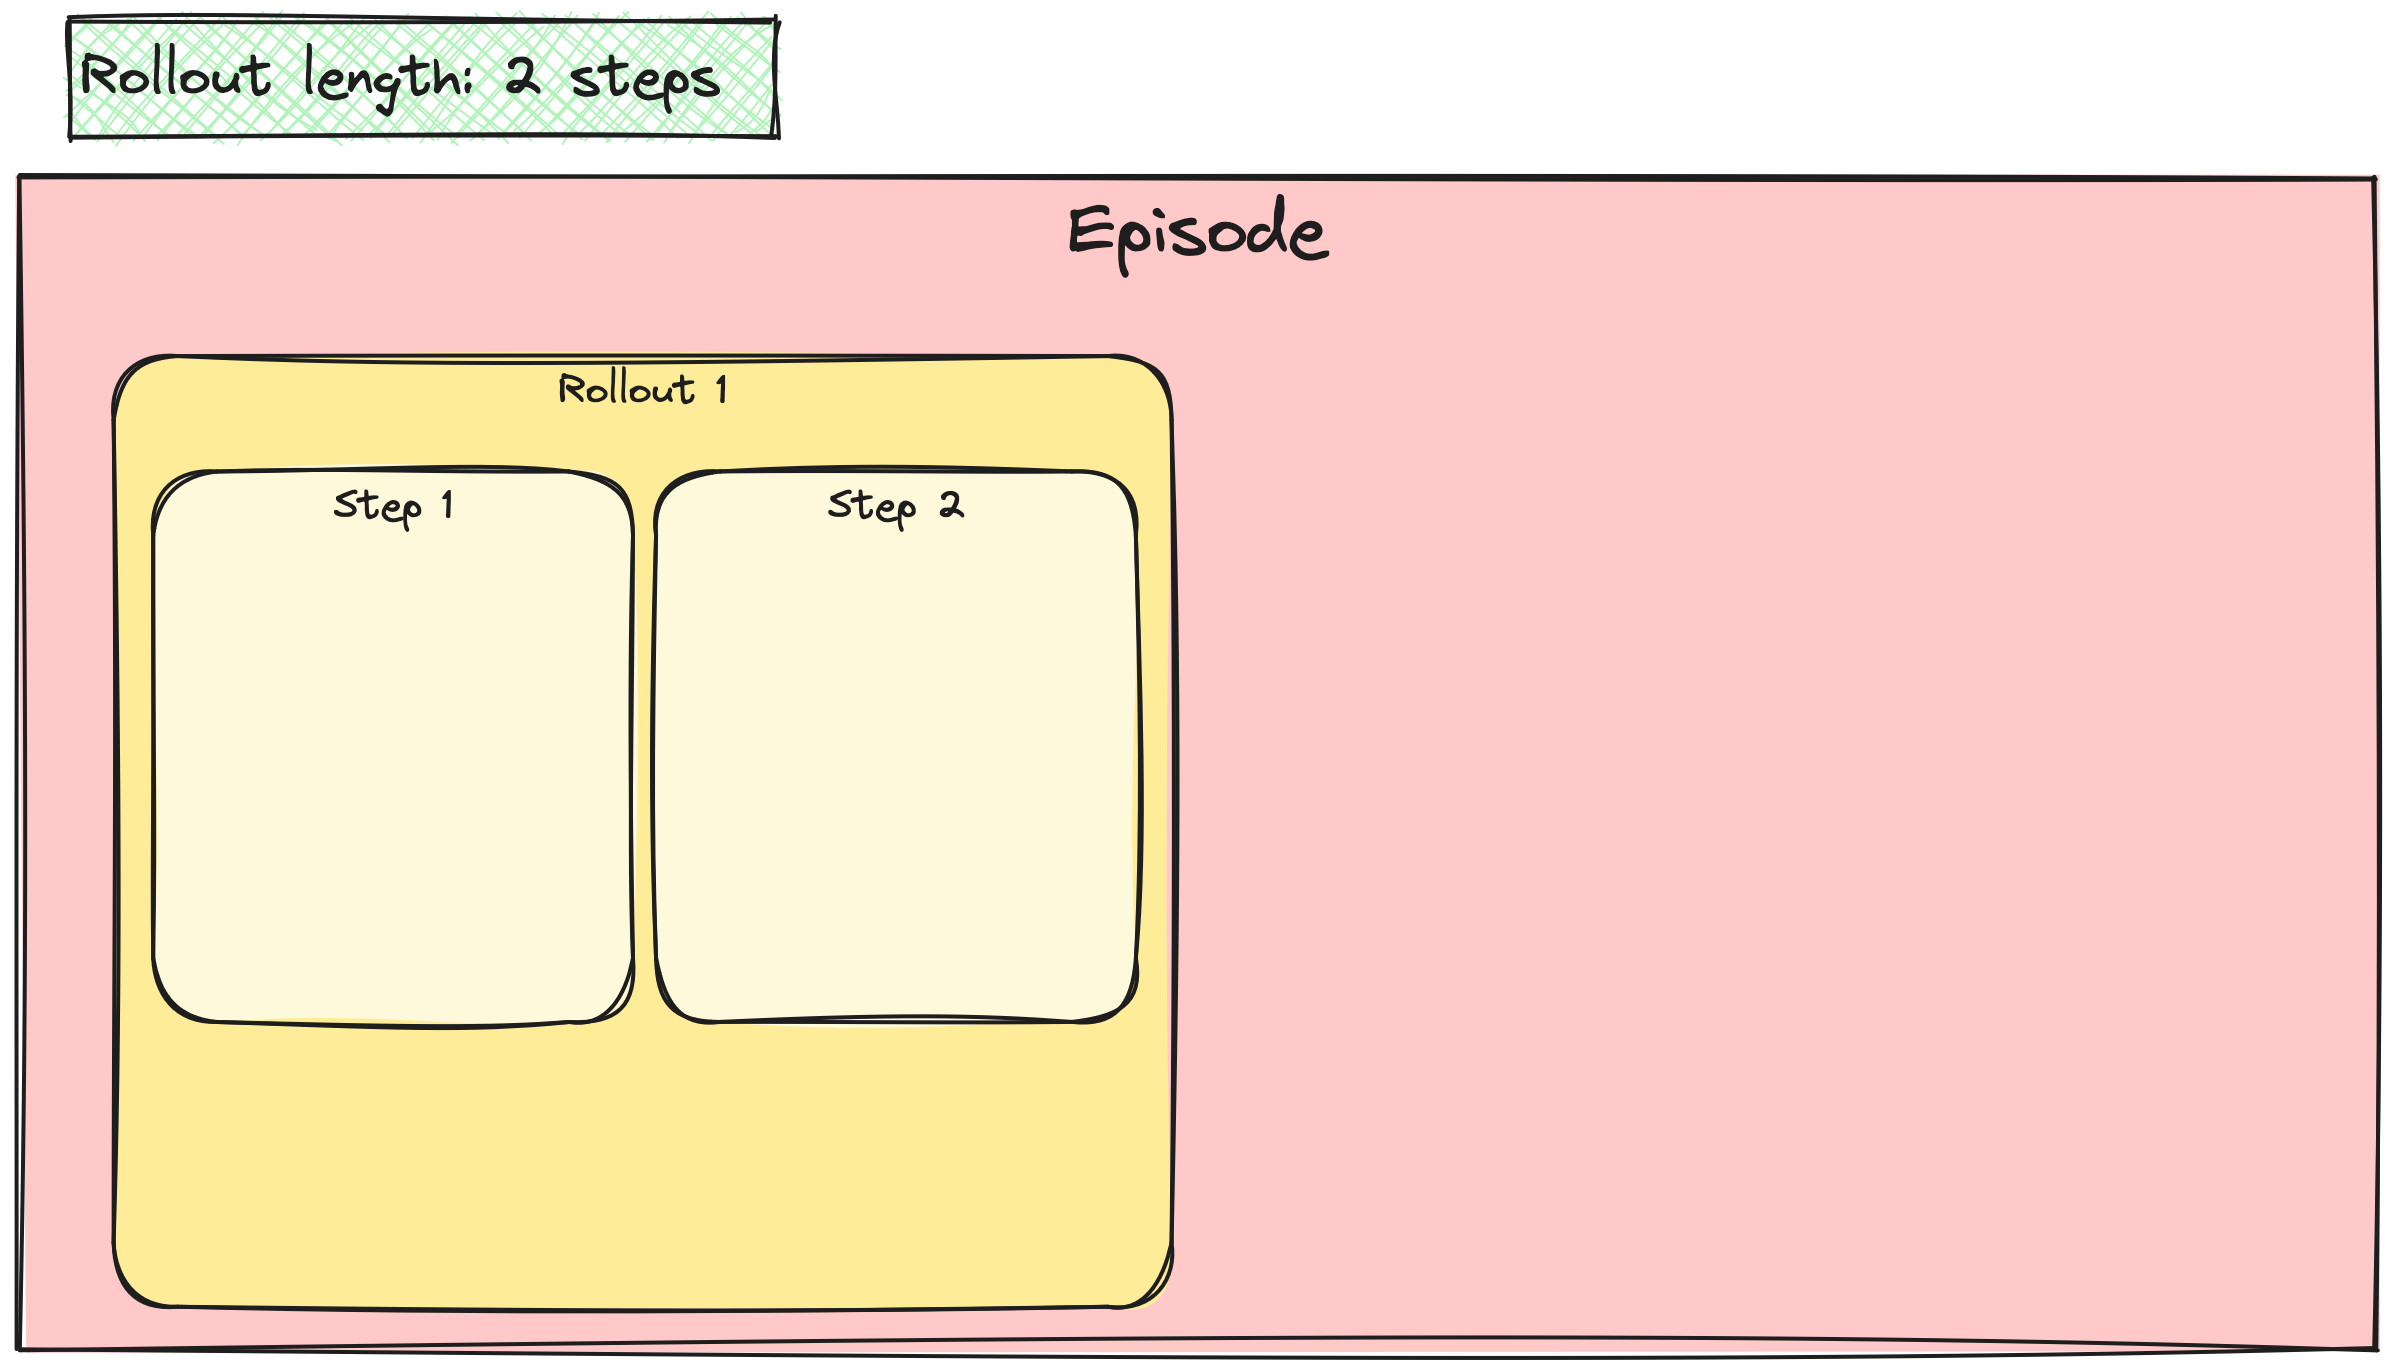
Uma grande caixa de episódio; ocupando metade da área, outra caixa chamada 'rollout 1'; dentro dela, duas caixas vazias chamadas 'step 1' e 'step 2'

Aprendizado por reforço profundo em Python

Lotes nas atualizações do A2C / PPO

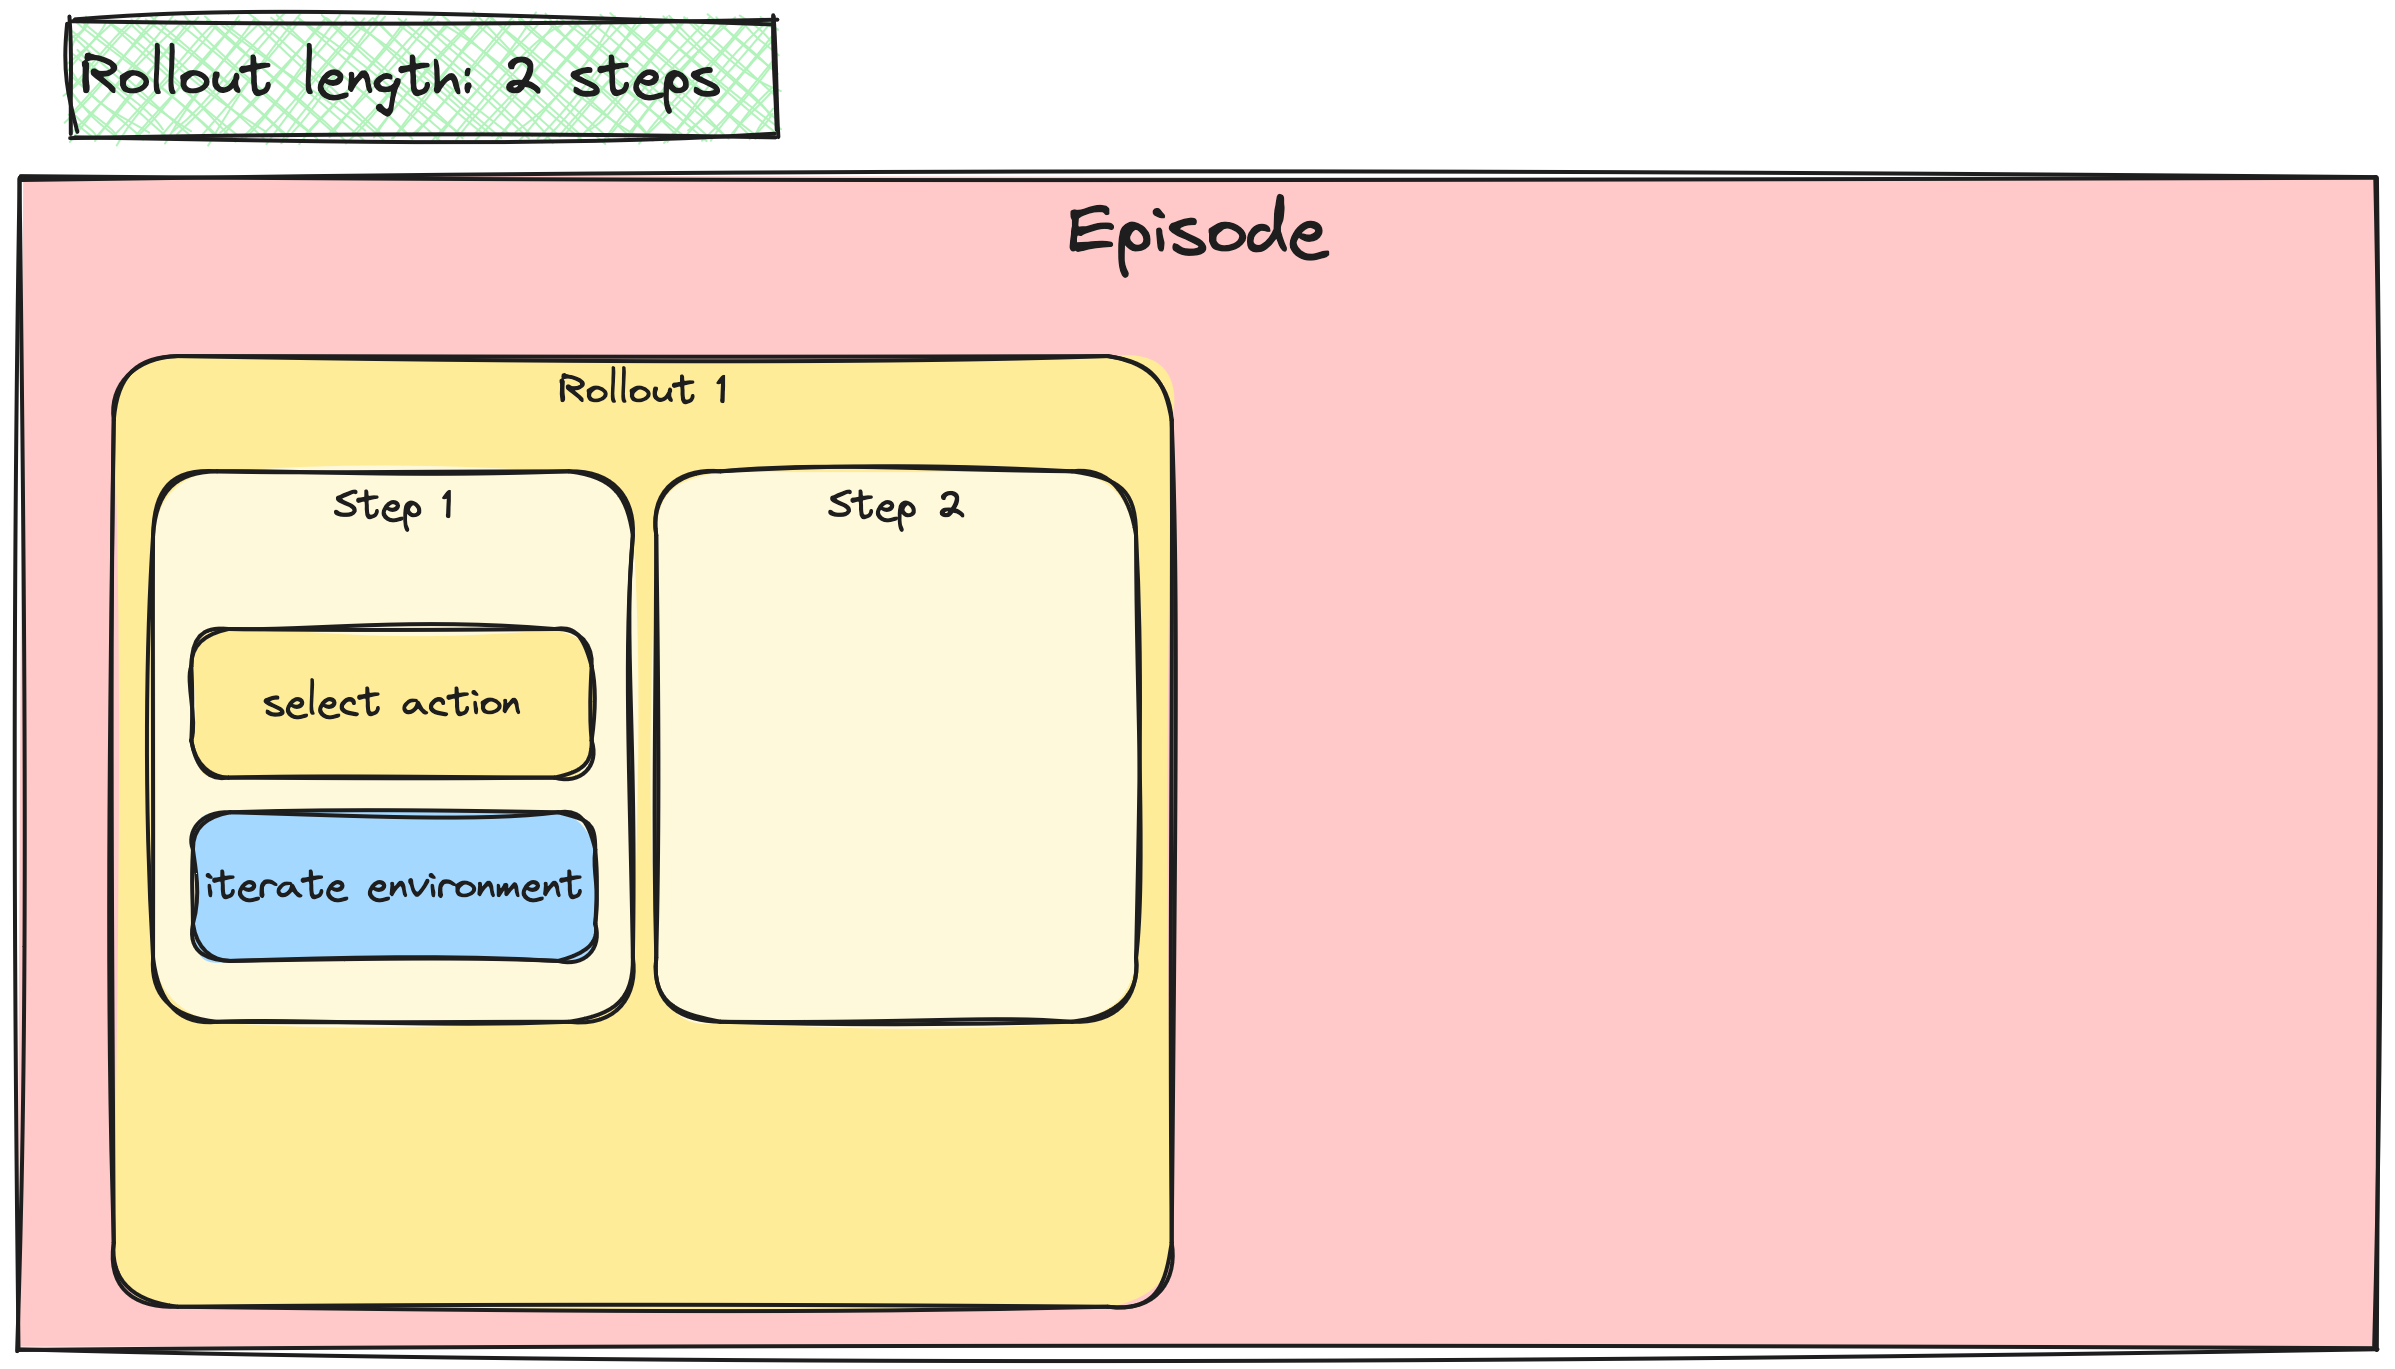
Na caixa do passo 1, aparecem os rótulos 'select action' e 'iterate environment'.

Aprendizado por reforço profundo em Python

Lotes nas atualizações do A2C / PPO

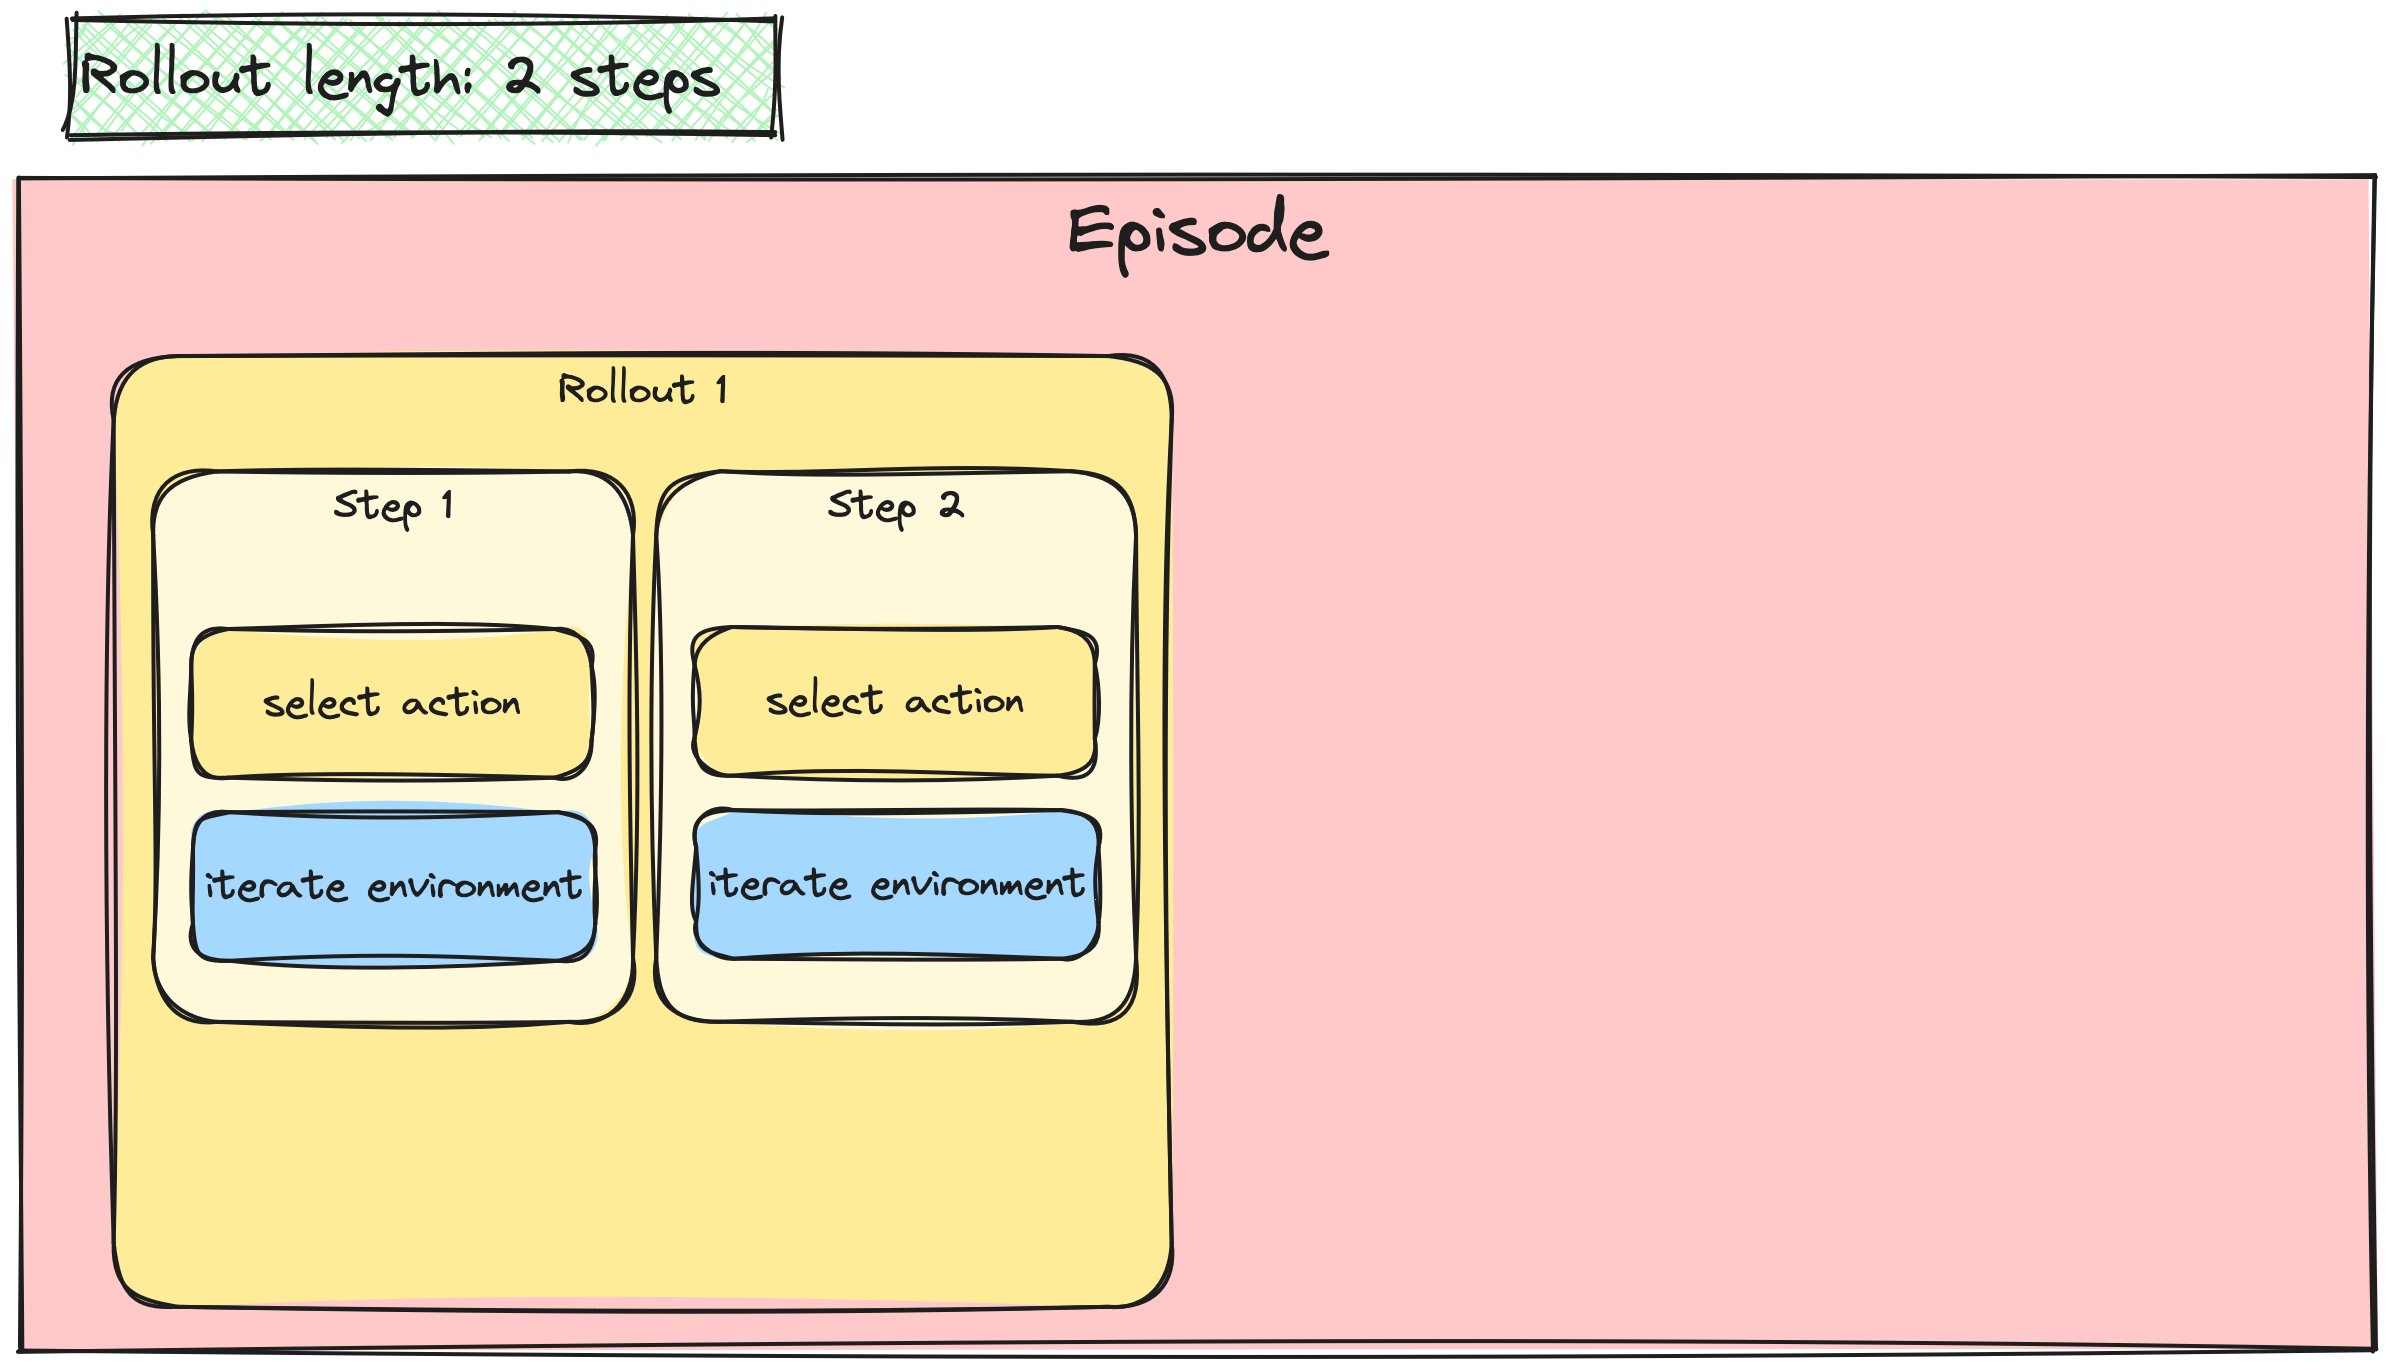
O mesmo para o passo 2.

Aprendizado por reforço profundo em Python

Lotes nas atualizações do A2C / PPO

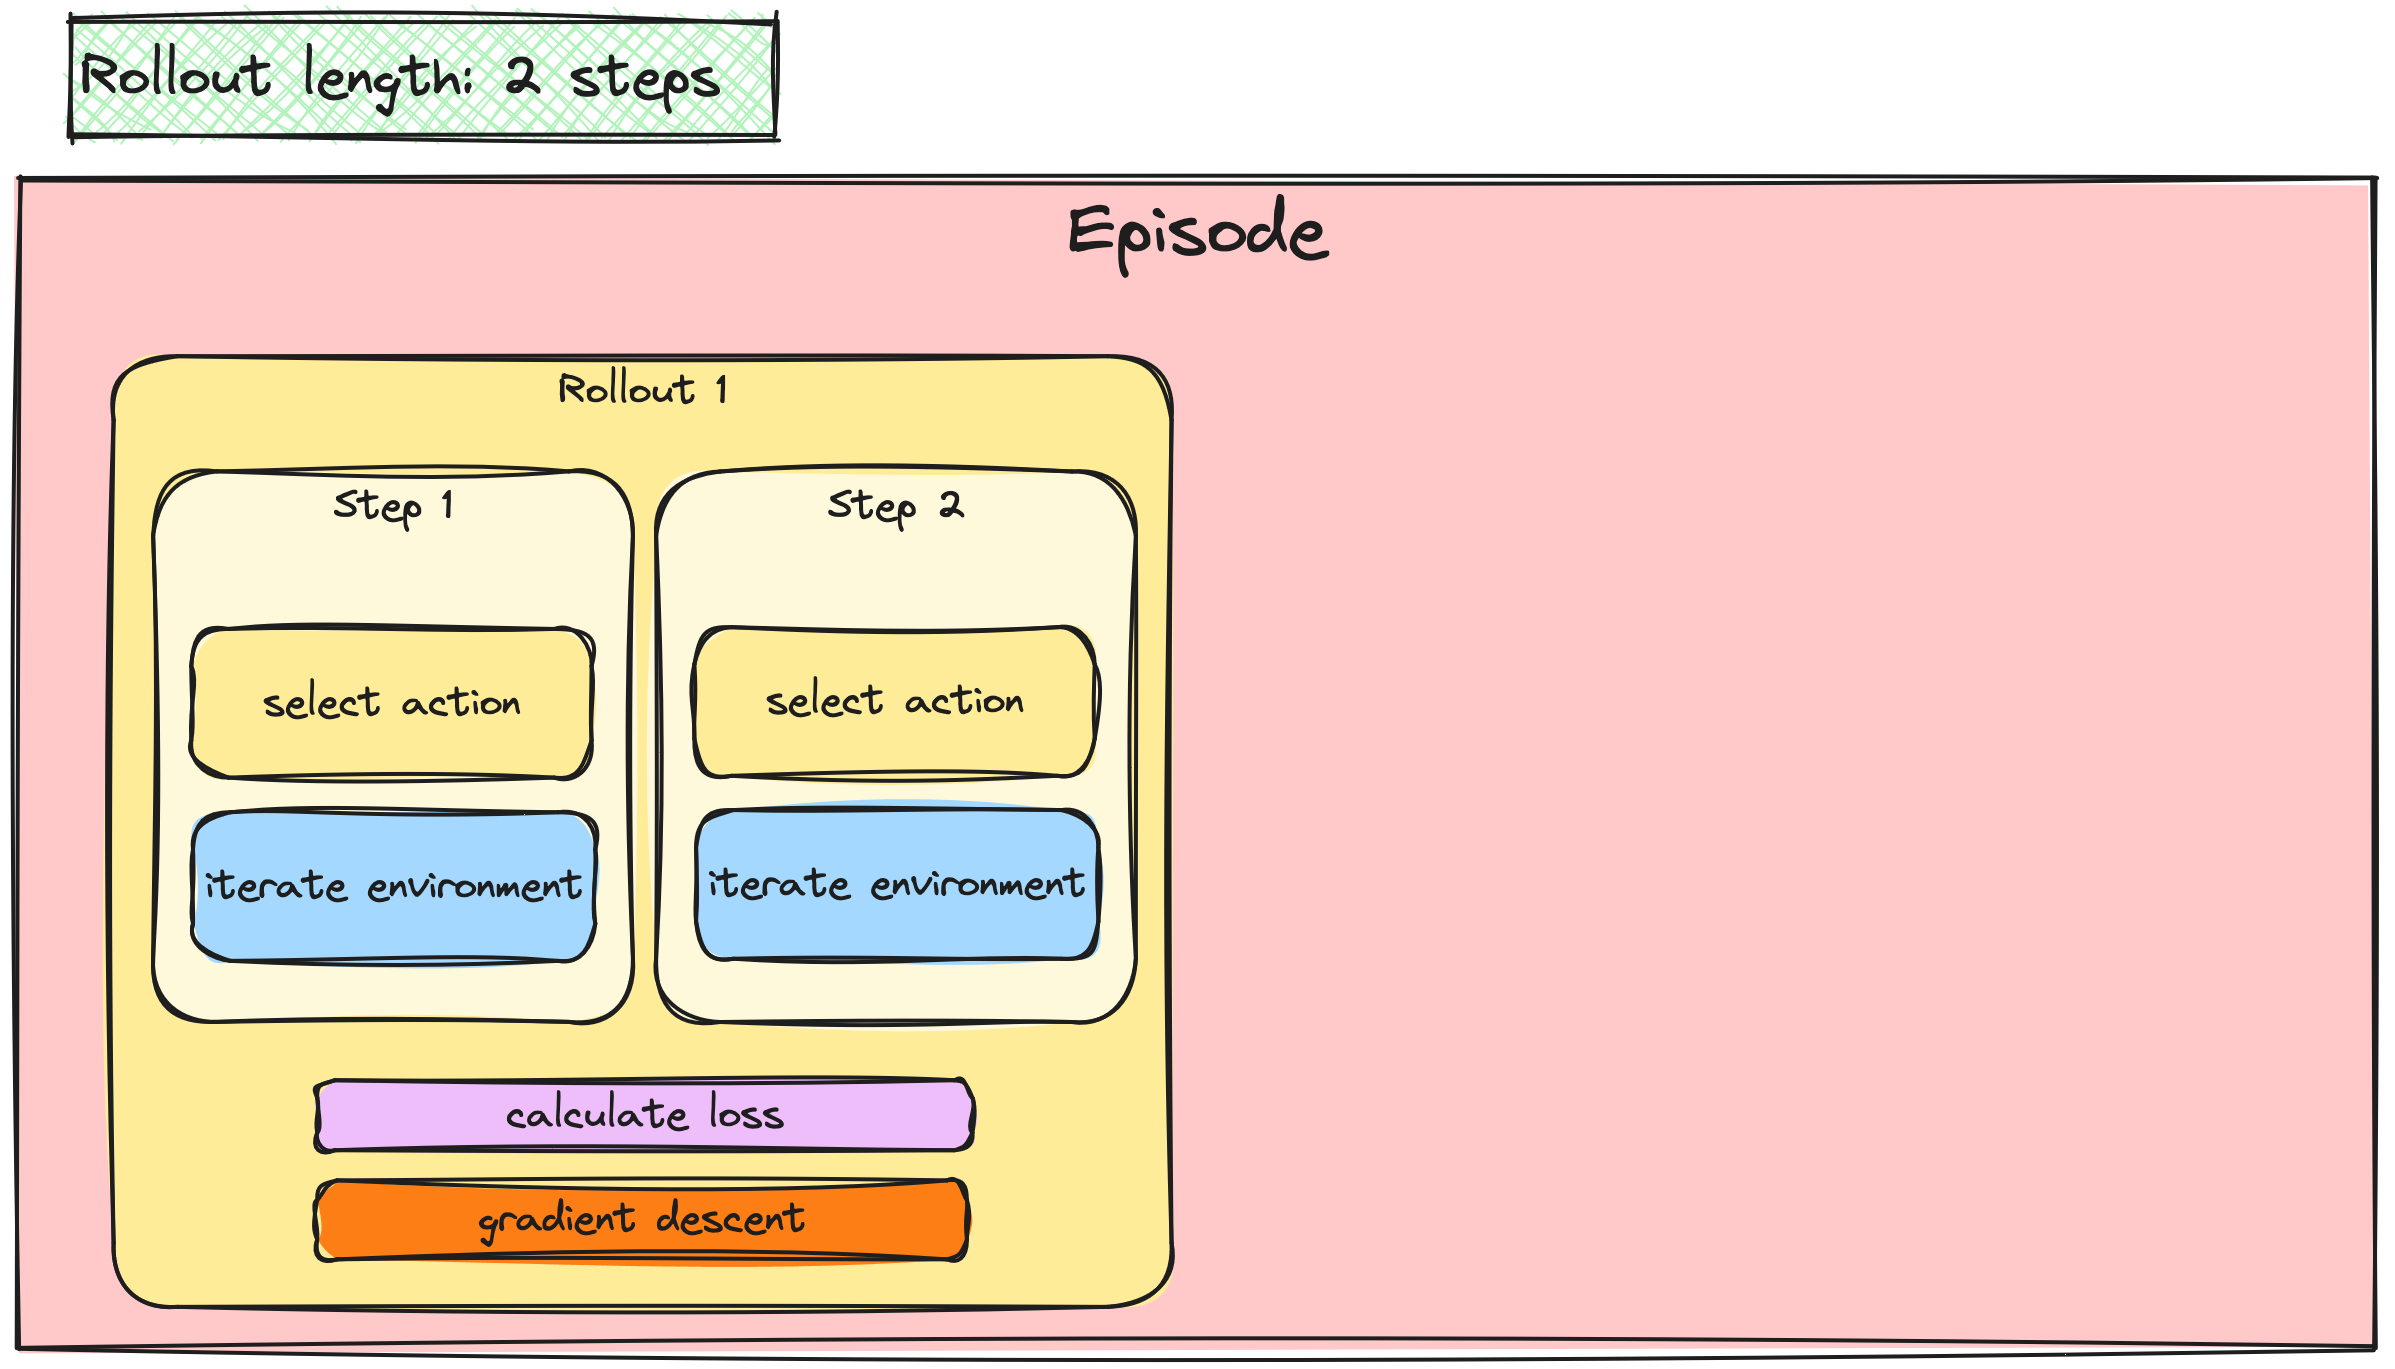
Abaixo das caixas dos passos 1 e 2, aparece um único rótulo 'calculate loss' e um único 'gradient descent'.

Aprendizado por reforço profundo em Python

Lotes nas atualizações do A2C / PPO

A metade restante da área do episódio agora é ocupada por outro rollout idêntico com dois passos, chamado 'rollout 2'.

Aprendizado por reforço profundo em Python

Loop de treino do A2C com atualizações em lote


# Set rollout length
rollout_length = 10

# Initiate loss batches
actor_losses = torch.tensor([]) critic_losses = torch.tensor([])
  • Iniciar lotes de perdas
  • Iterar por episódios e passos como de costume


for episode in range(10):
  state, info = env.reset()
  done = False
  while not done:
    action, action_log_prob = select_action(actor, 
                                            state)                
    next_state, reward, terminated, truncated, _ = (
                                   env.step(action))
    done = terminated or truncated    
    actor_loss, critic_loss = calculate_losses(
        critic, action_log_prob, 
        reward, state, next_state, done)
    ...
Aprendizado por reforço profundo em Python

Loop de treino do A2C com atualizações em lote

  ...
  actor_losses = torch.cat((actor_losses, actor_loss))
  critic_losses = torch.cat((critic_losses, critic_loss))

# If rollout is full, update the networks if len(actor_losses) >= rollout_length:
actor_loss_batch = actor_losses.mean() critic_loss_batch = critic_losses.mean()
actor_optimizer.zero_grad() actor_loss_batch.backward() actor_optimizer.step() critic_optimizer.zero_grad() critic_loss_batch.backward() critic_optimizer.step()
actor_losses = torch.tensor([]) critic_losses = torch.tensor([])
state = next_state


  • Anexar a perda do passo aos lotes de perdas
  • Quando o rollout encher:
    • Tirar a média do lote com .mean()
    • Executar o gradiente descendente
    • Reinicializar as perdas do lote
Aprendizado por reforço profundo em Python

A2C / PPO com múltiplos agentes


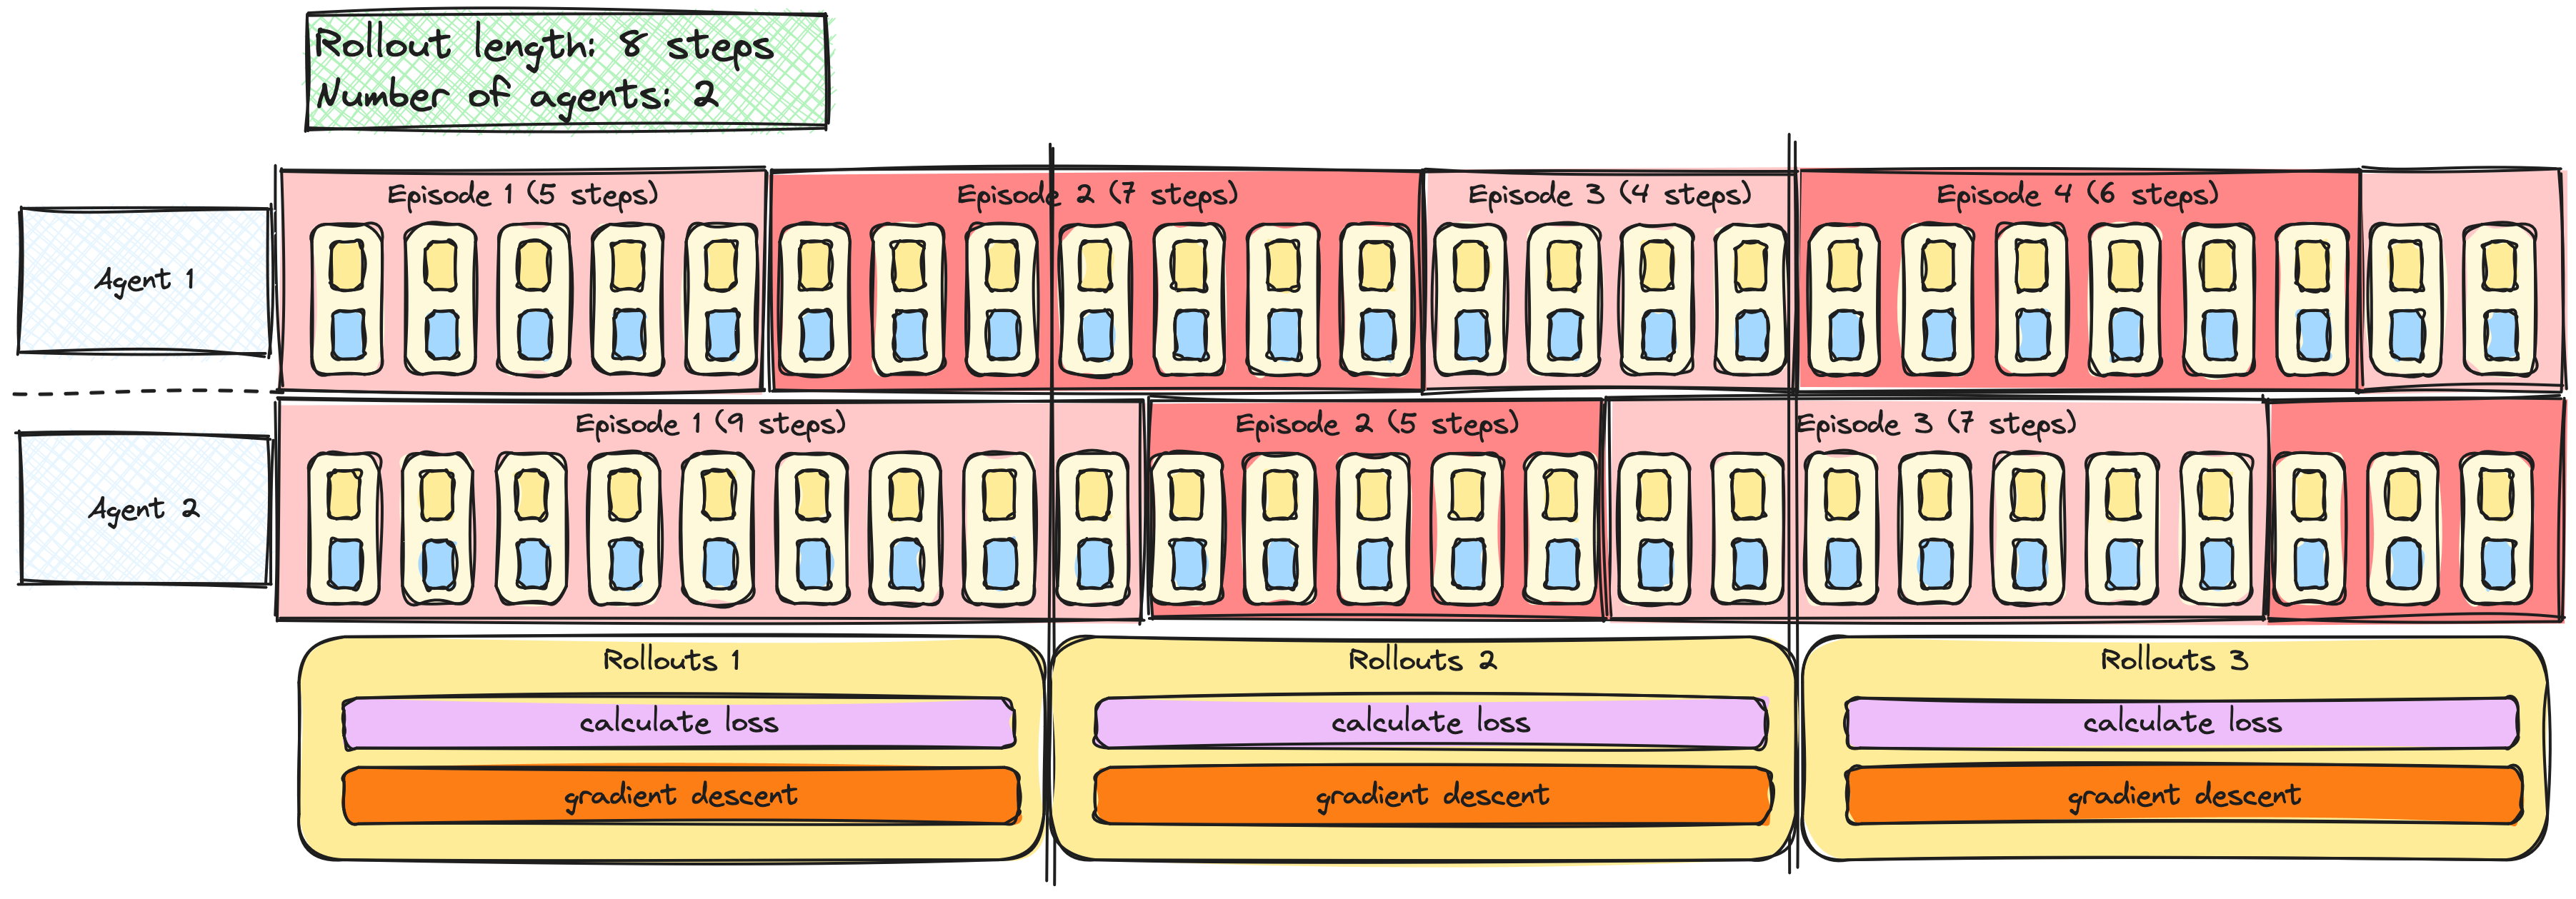
Duas faixas horizontais representam o agente 1 e o agente 2. Cada agente vive, respectivamente, 4 e 3 episódios de durações variadas. Em cada episódio, caixas de passos aparecem como nas cenas anteriores. Sob as duas faixas, três caixas de rollout aparecem, cada uma cobrindo um intervalo de 8 passos. Em cada rollout, há os rótulos 'calculate loss' e 'gradient descent'. No topo, uma legenda indica "rollout length: 8 steps; number of agents: 2"

Aprendizado por reforço profundo em Python

Rollouts e minibatches

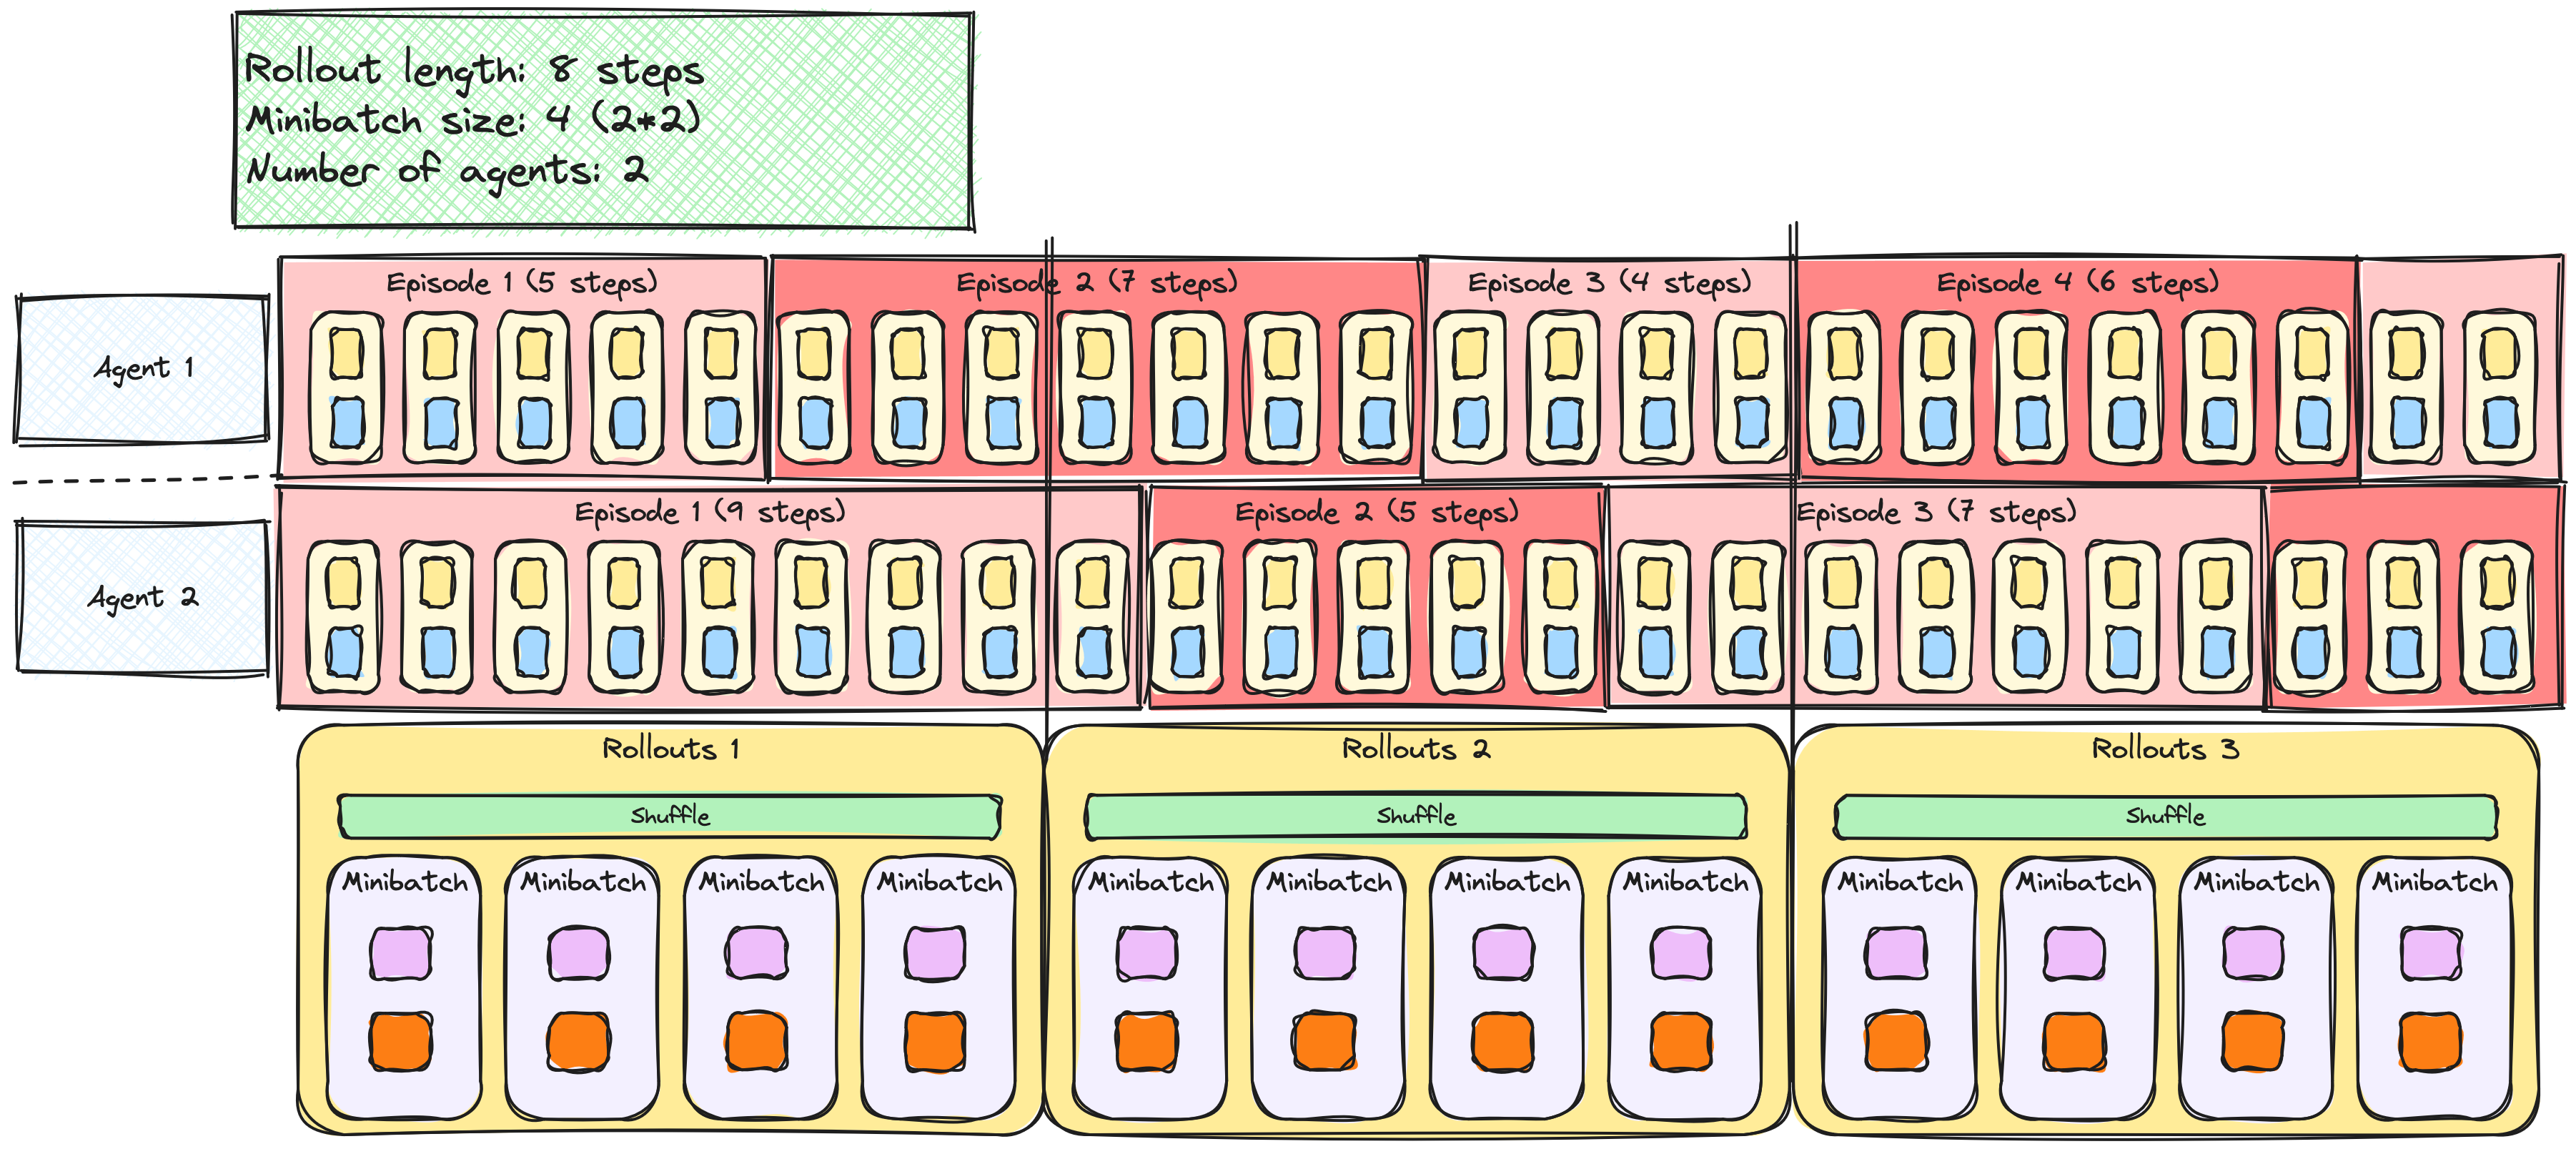
Duas faixas de agentes idênticas à do slide anterior. Abaixo, 3 caixas de rollout novamente visíveis, mas com conteúdo diferente. Agora, no topo, há uma caixa longa 'shuffle'. Abaixo, cada uma é dividida ao longo em 4 caixas 'minibatch'; em cada minibatch há 'calculate loss' e 'gradient descent'. No topo, a legenda indica: 'Rollout length: 8 steps; minibatch size: 4 (2x2); number of agents: 2'

Aprendizado por reforço profundo em Python

PPO com múltiplas épocas

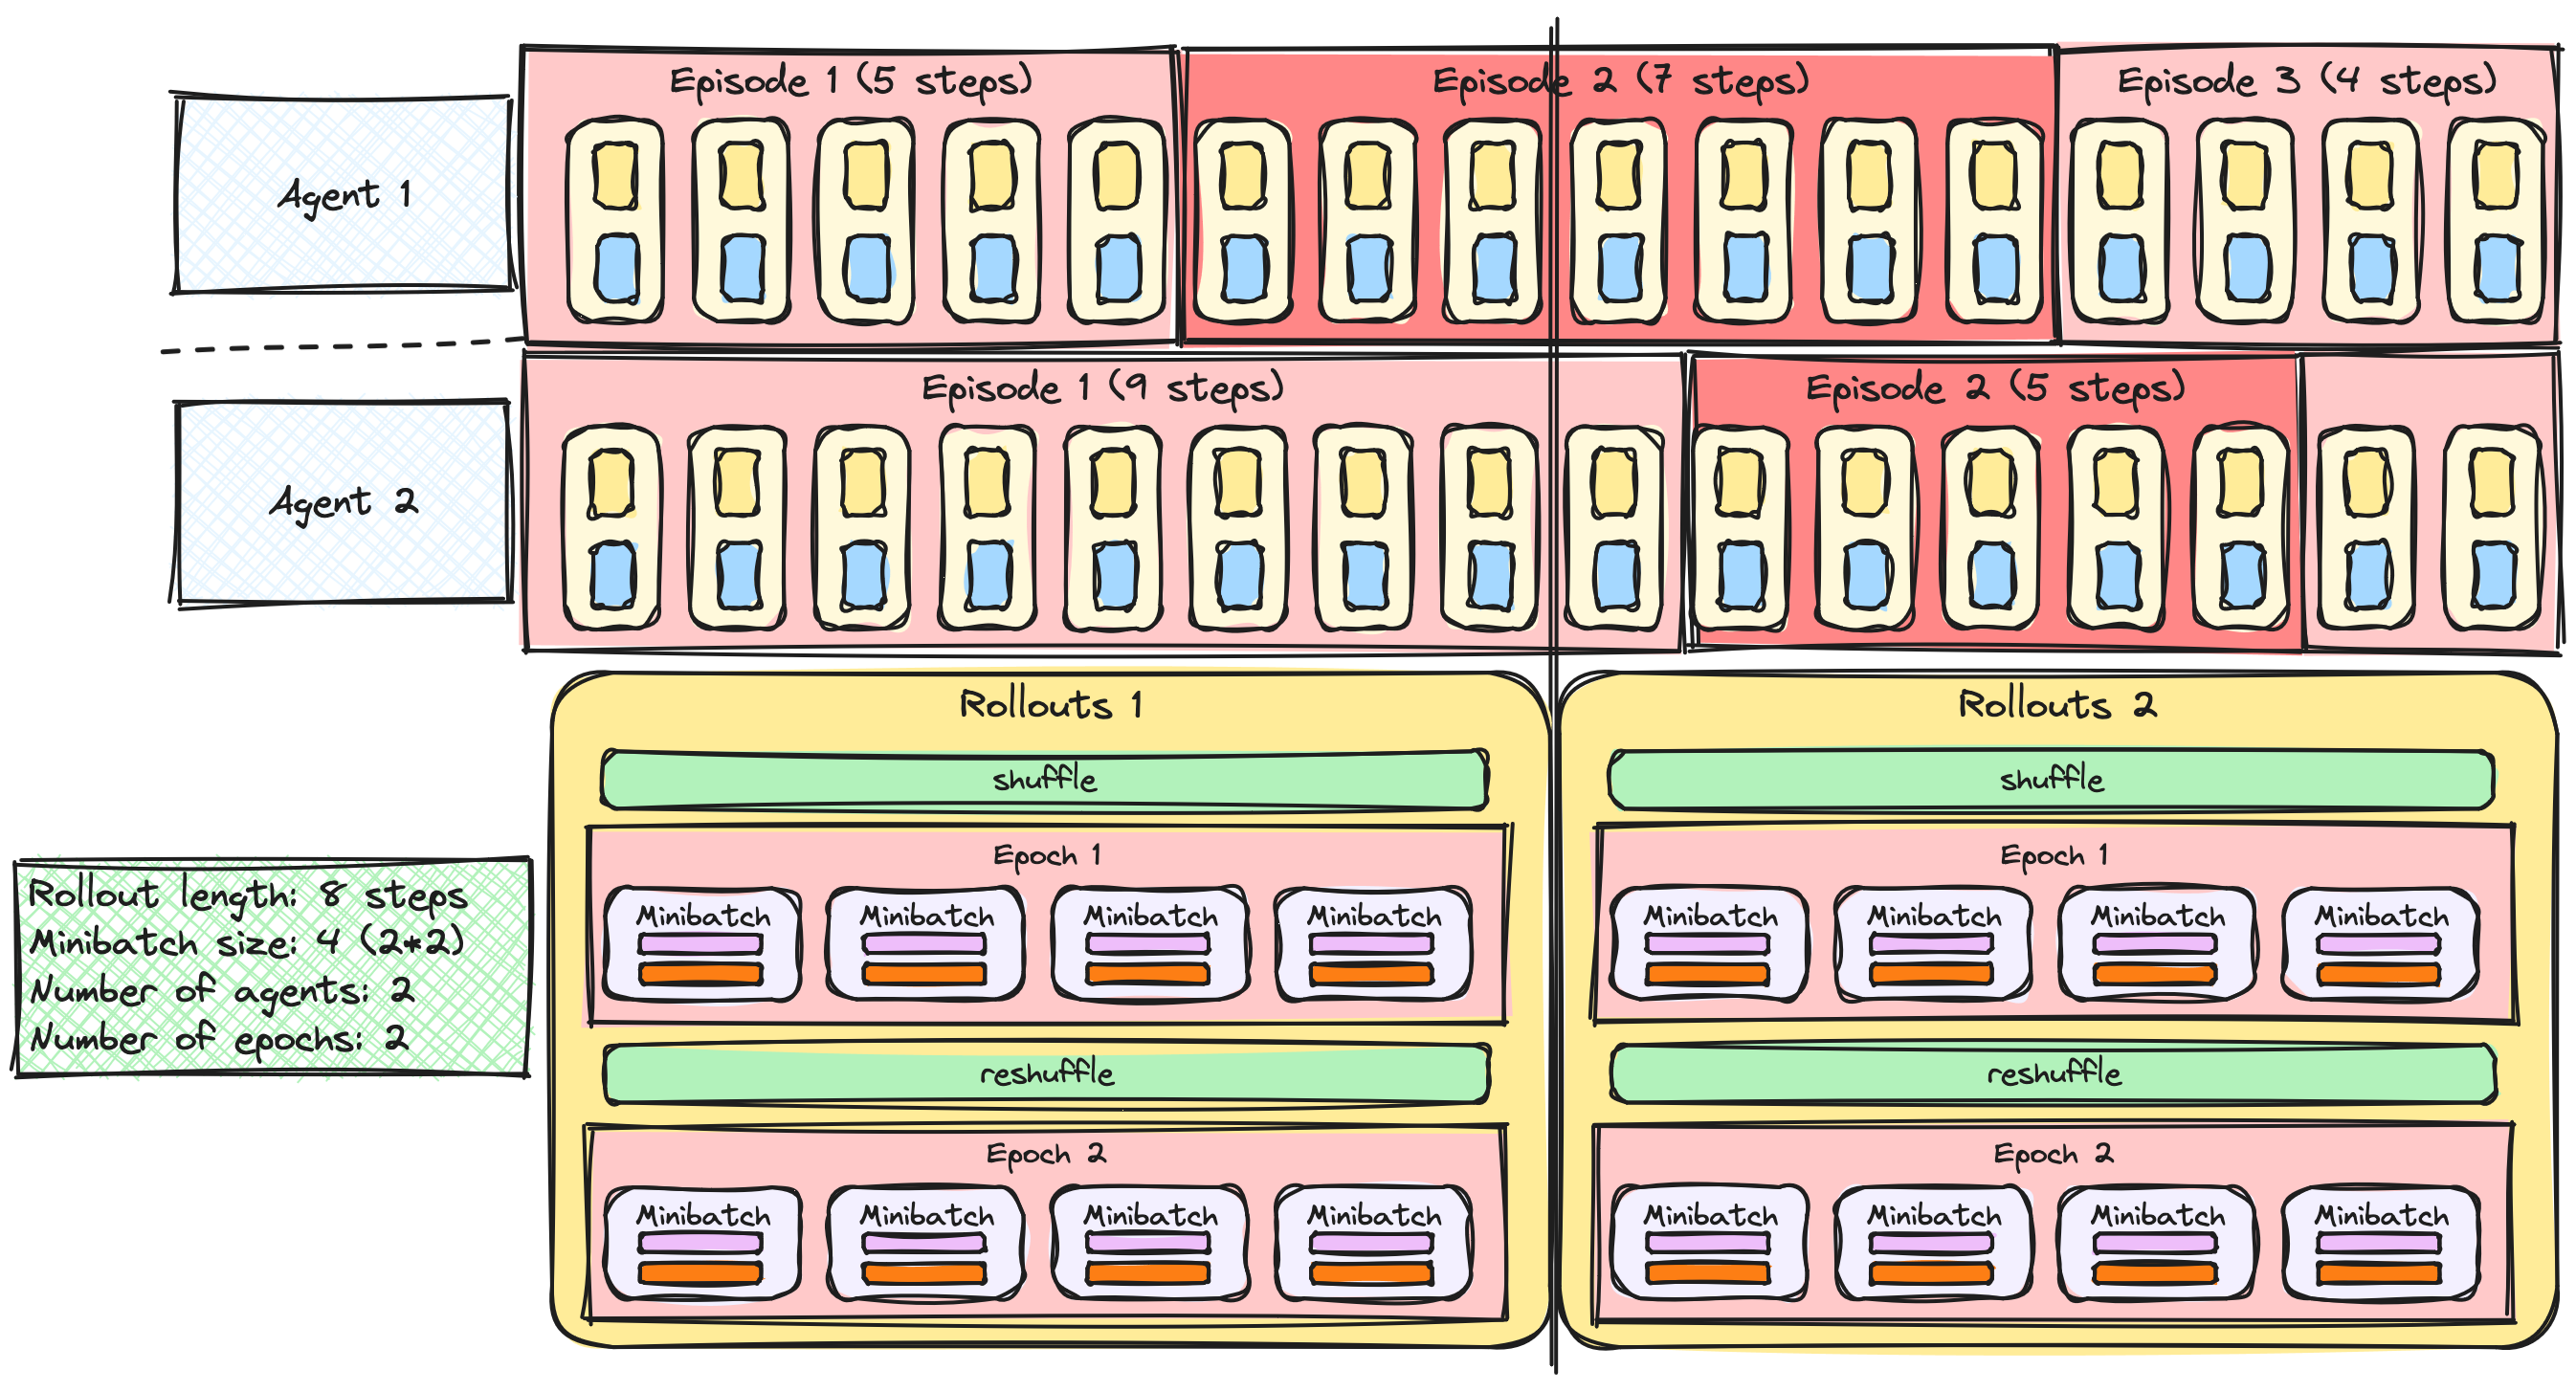
Um desenho muito parecido com o anterior, exceto pelos lotes de rollout que agora também são divididos verticalmente em 4 áreas: a de cima é 'shuffle'; a segunda é uma caixa grande 'epoch 1' contendo 4 minibatches ao longo; a terceira é 'reshuffle'; a última é 'epoch 2', também com 4 minibatches. A legenda diz: 'Rollout length: 8 steps; minibatch size: 4 (2x2); number of agents: 2; number of epochs: 2'.

Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...