Double DQN

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Double Q-learning

  • Q-learning superestima Q-values, prejudicando a eficiência do aprendizado
  • Isso ocorre por viés de maximização
  • Double Q-Learning elimina o viés ao separar seleção de ação e estimação de valor
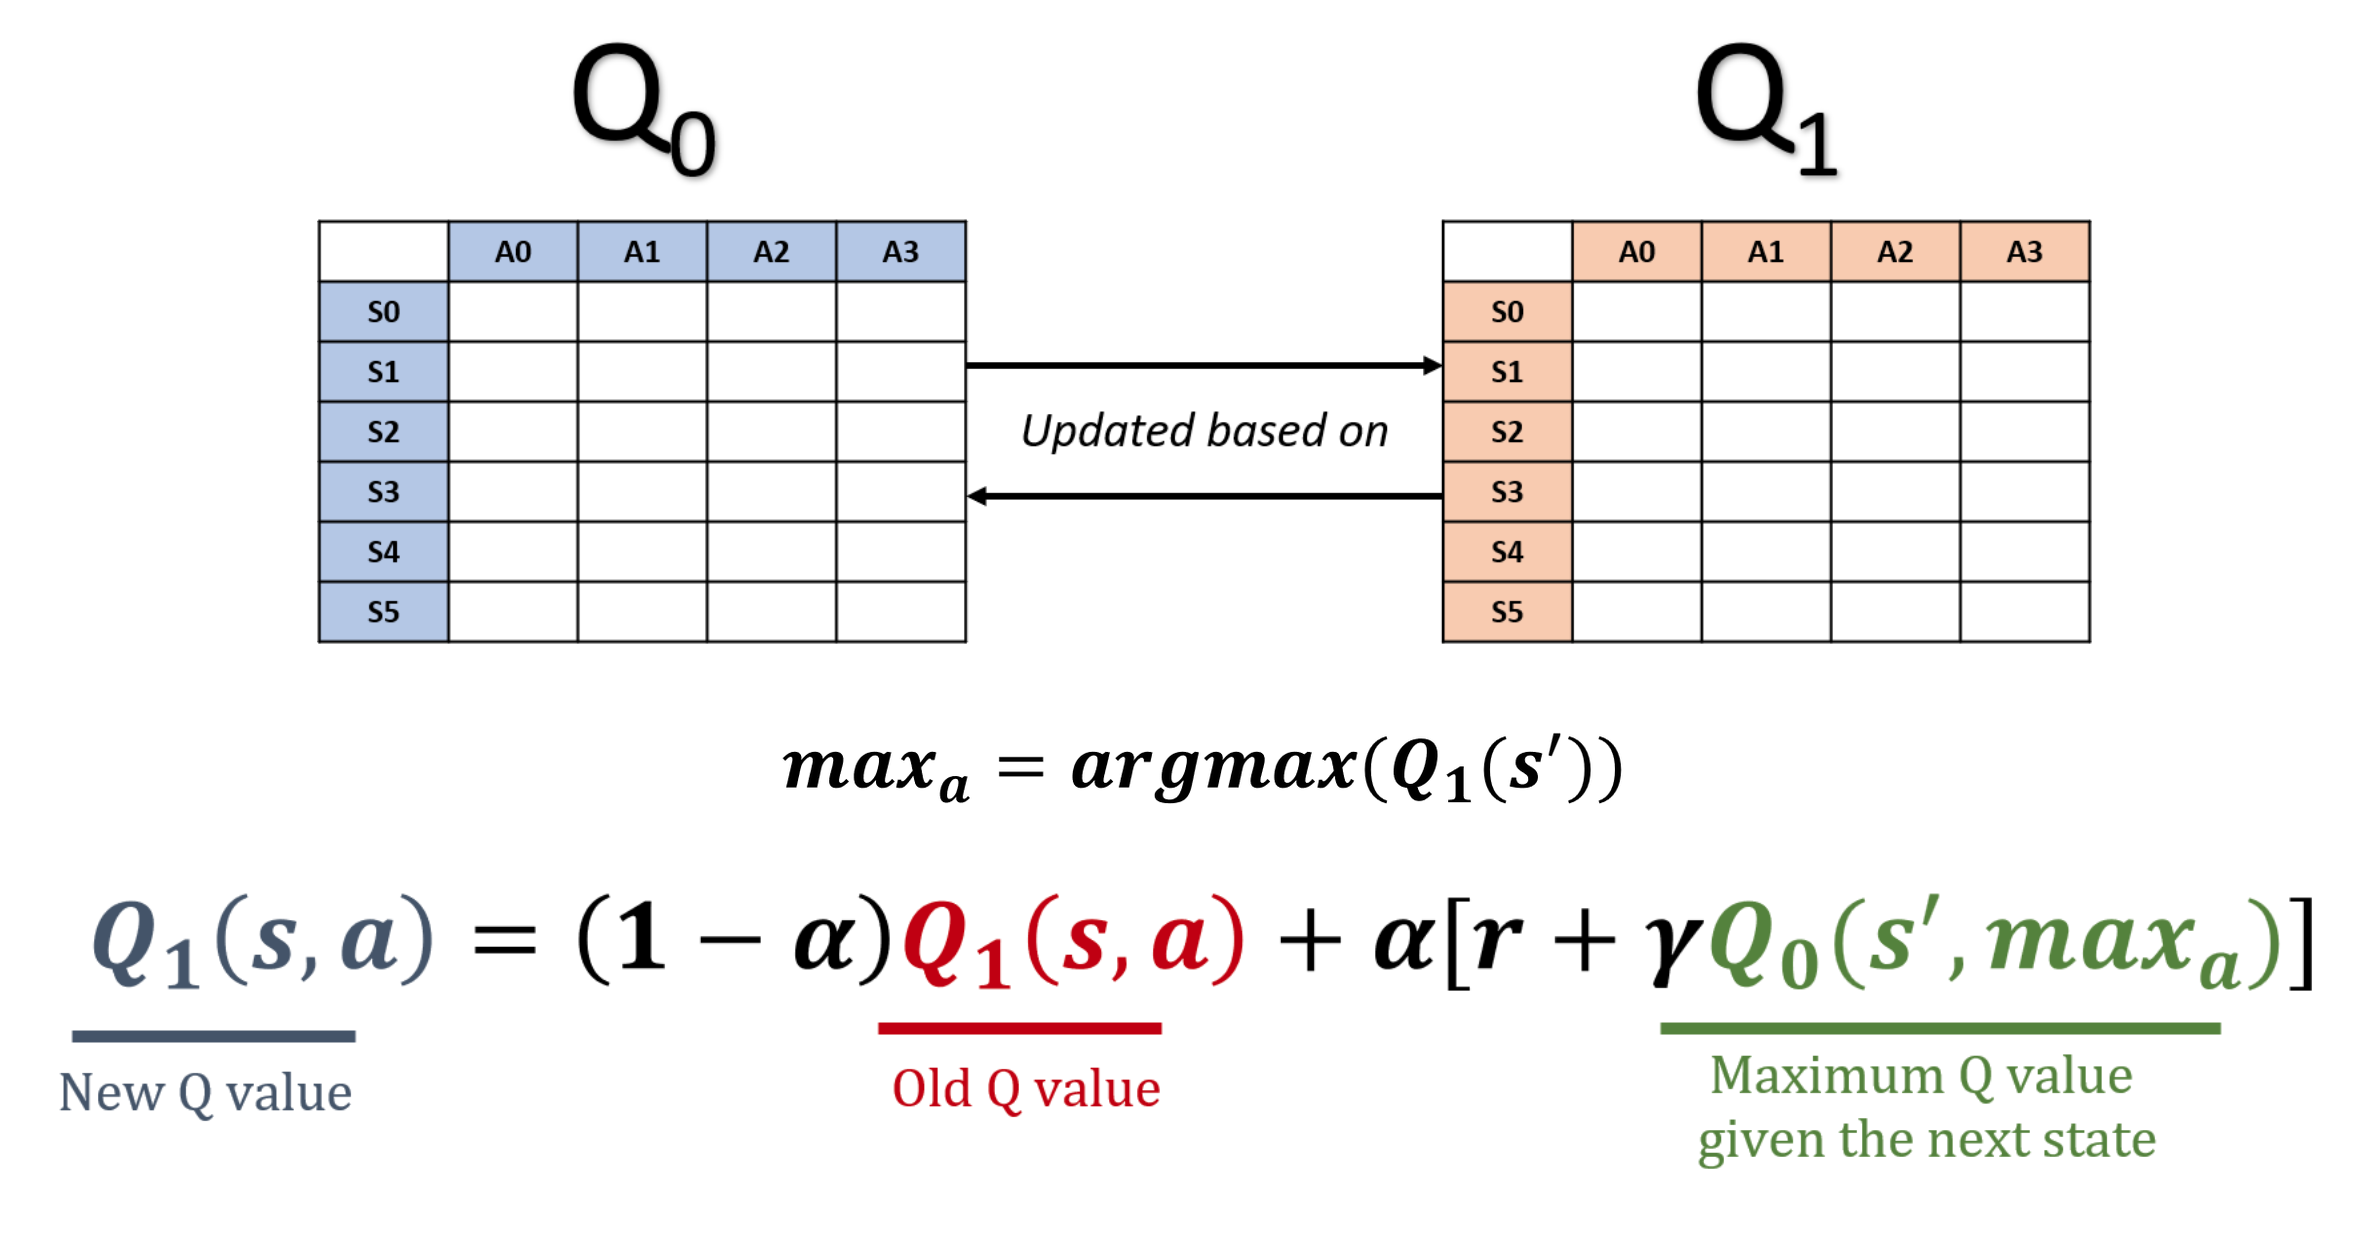
Duas Q-tables (ilustração do curso Reinforcement Learning with Gymnasium using Python); double Q-learning usa cada uma alternadamente

Aprendizado por reforço profundo em Python

A ideia por trás do DDQN

  • Comece do DQN completo (com Q-targets fixos)
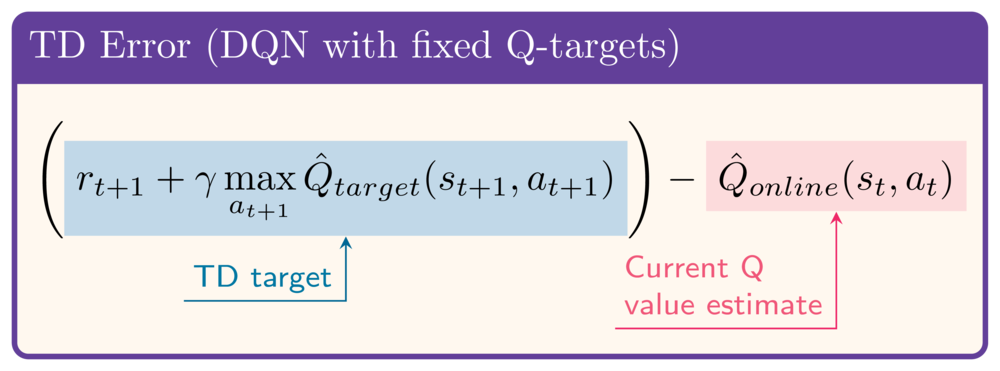
  • No alvo TD do DQN:
    • Seleção de ação: rede alvo
    • Estimação de valor: rede alvo
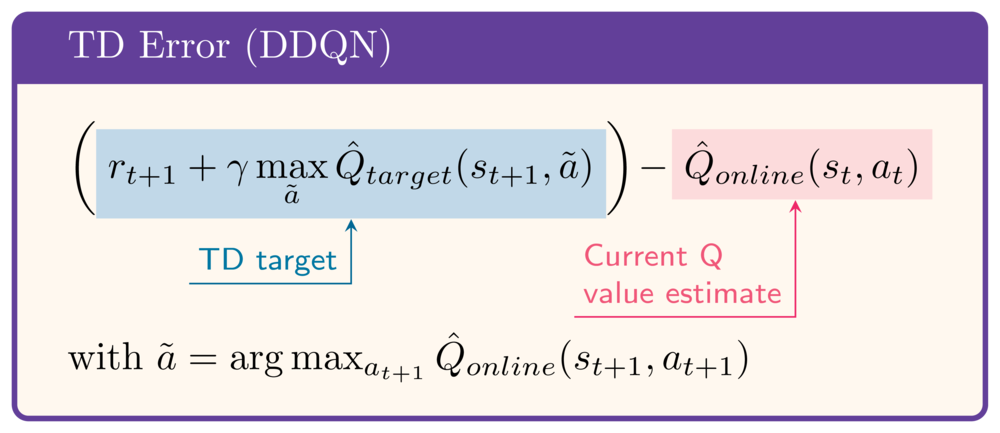
  • No alvo TD do DDQN:
    • Seleção de ação: rede online
    • Estimação de valor: rede alvo
  • Não é exatamente double Q-learning (sem alternar redes Q)
  • Quase todo o ganho, com mudança mínima

Erro de Bellman (DQN com Q-targets fixos): Q_online(s_t, a_t) - (r_t+1 + gamma max(Q_target(s_t+1, a)))

Erro de Bellman (DDQN com Q-targets fixos): Q_online(s_t, a_t) - (r_t+1 + gamma Q_target(s_t+1, tilde a)) com tilde a = argmax_a(Q_online(s_t+1, a))

Aprendizado por reforço profundo em Python

Implementação de Double DQN

DQN:

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():
# # next_q_values = (target_network(next_states) .amax(1))
target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update

DDQN:

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():

target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update
Aprendizado por reforço profundo em Python

Implementação de Double DQN

DQN:

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():
next_actions = (target_network(next_states) .argmax(1).unsqueeze(1))
next_q_values = (target_network(next_states) .gather(1, next_actions).squeeze(1))
target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update

DDQN:

... # instantiate online and target networks
q_values = (online_network(states)
            .gather(1, actions).squeeze(1))

with torch.no_grad():
next_actions = (online_network(next_states) .argmax(1).unsqueeze(1))
next_q_values = (target_network(next_states) .gather(1, next_actions).squeeze(1))
target_q_values = (rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(q_values, target_q_values) ... # gradient descent ... # target network update
Aprendizado por reforço profundo em Python

Desempenho do DDQN


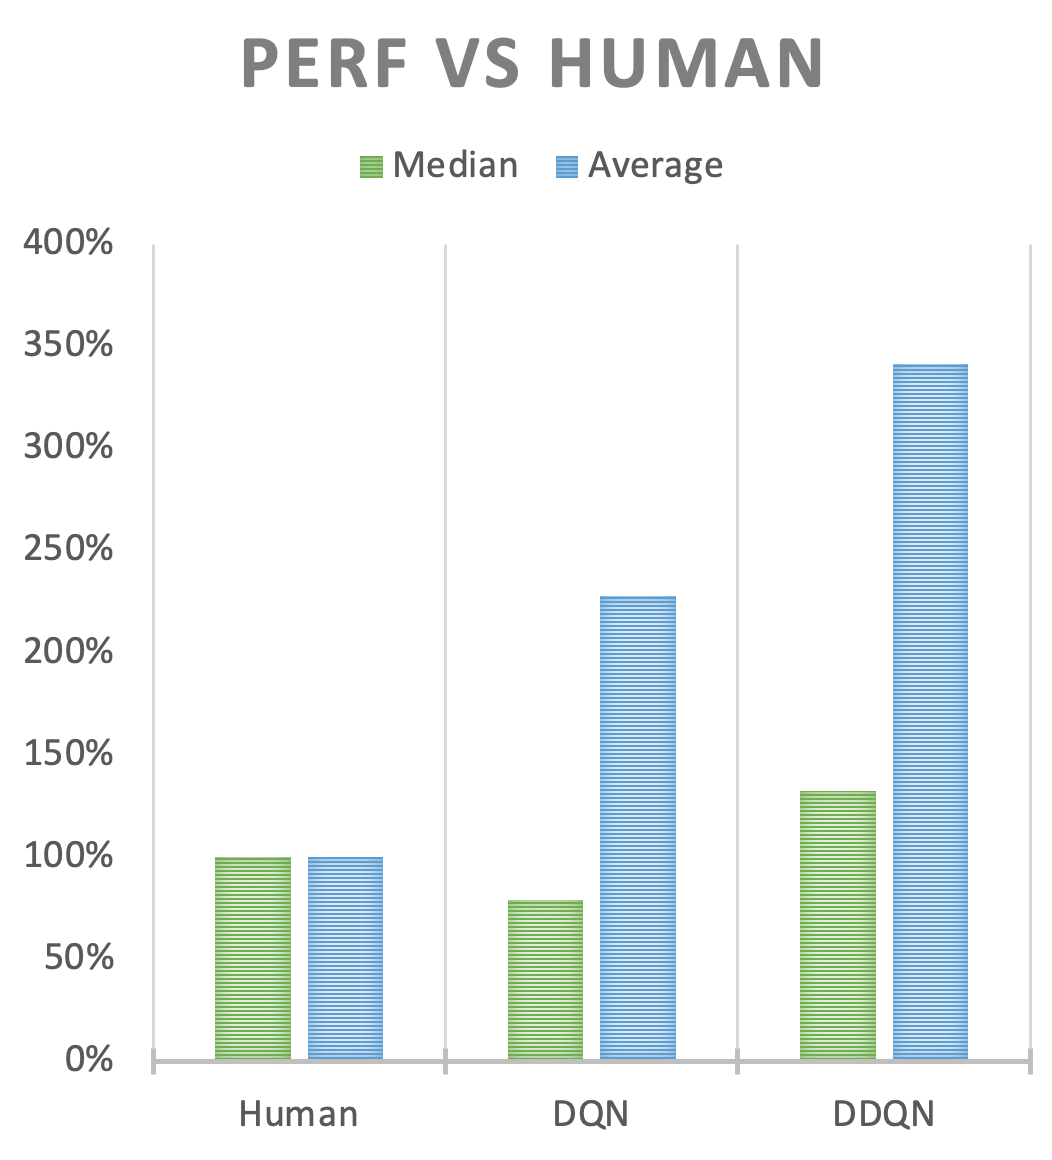
  • Compare o desempenho de DDQN, DQN e humanos em jogos Atari
  • DDQN: pontuações maiores que o DQN original
  • Pode não ser sempre assim -> teste ambos

Gráfico de barras mostrando que o DQN quase iguala humanos no jogo mediano e tem médias sobre-humanas; e o DDQN supera humanos e DQN na mediana e na média.

1 https://arxiv.org/abs/2303.11634
Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...