Advantage Actor Critic

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Por que actor critic?
 

  • Limitações do REINFORCE:

    • Alta variância
    • Baixa eficiência de amostras
  • Métodos Actor Critic inserem uma rede crítica, permitindo aprendizado por Diferença Temporal

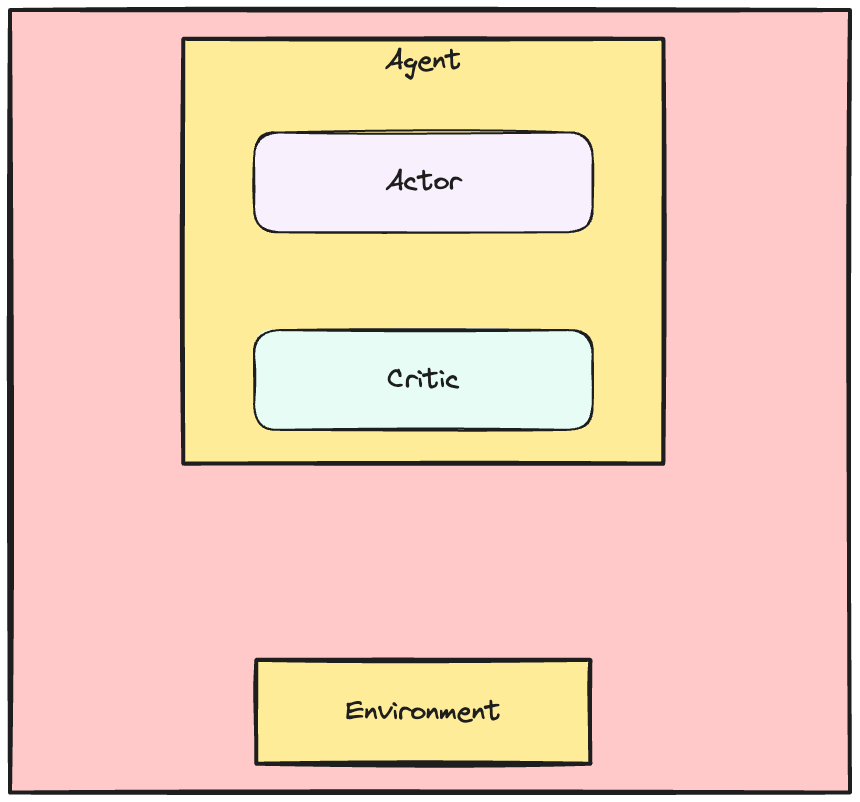
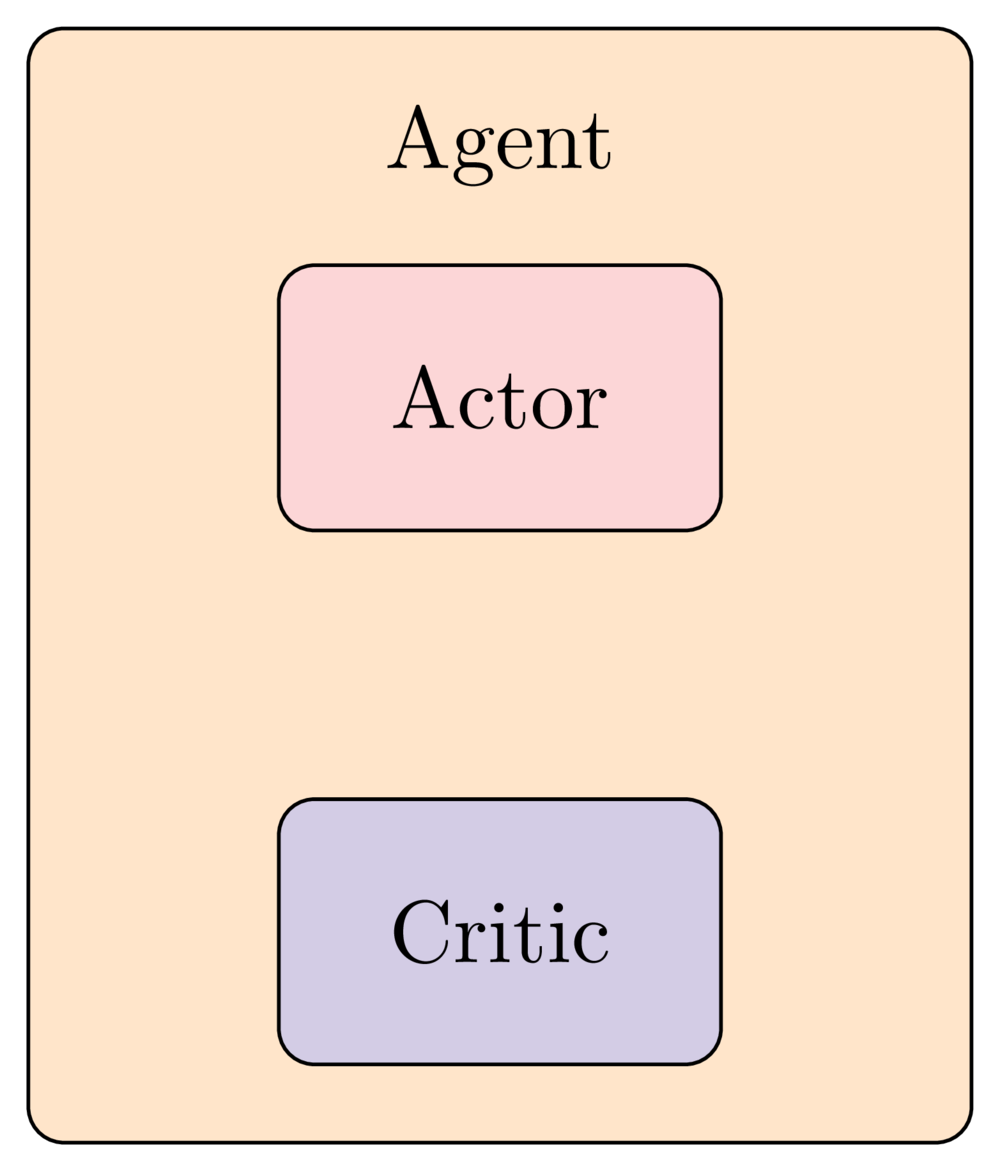
Um grande retângulo chamado 'agente'; dentro dele, dois retângulos menores chamados 'ator' e 'crítico'.

Aprendizado por reforço profundo em Python

A intuição por trás de Actor Critic

Estudantes conversando ao redor de uma mesa, com livros e canetas espalhados.


  • Rede do ator:

    • Toma decisões
    • Não consegue avaliá-las
  • Rede do crítico:

    • Dá feedback ao ator a cada passo
Aprendizado por reforço profundo em Python

A rede Crítico


  • O crítico aproxima a função valor de estado
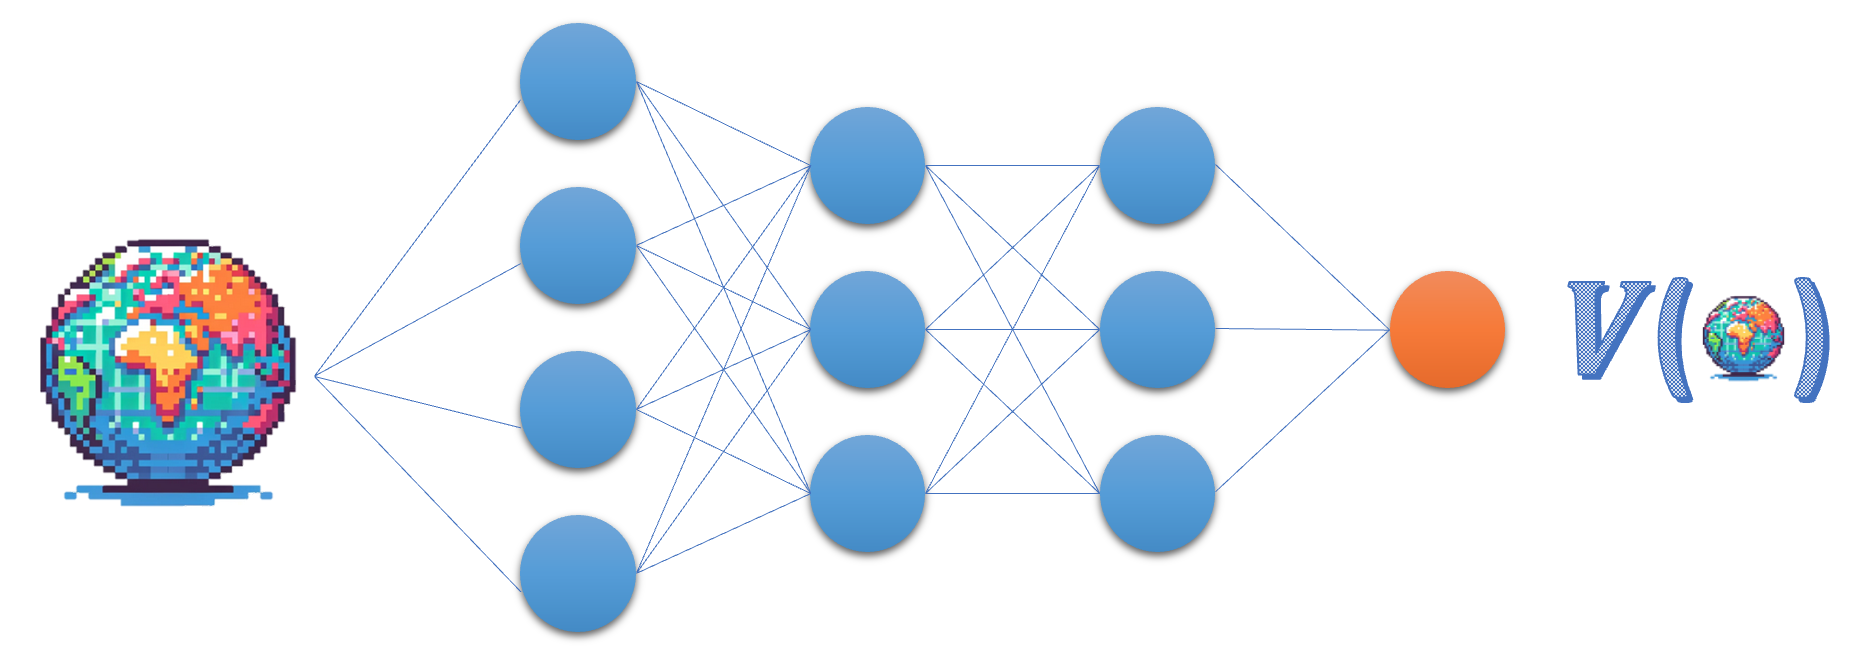
Uma representação da rede do crítico, com o estado como entrada e a função Valor como saída; assim, ela tem apenas um nó de saída.

  • Julga a ação $a_t$ com base na vantagem ou no erro TD


class Critic(nn.Module):
    def __init__(self, state_size):
        super(Critic, self).__init__()
        self.fc1 = nn.Linear(state_size, 64)
        self.fc2 = nn.Linear(64, 1)

def forward(self, state): x = torch.relu(self.fc1(torch.tensor(state))) value = self.fc2(x) return value
critic_network = Critic(8)
Aprendizado por reforço profundo em Python

A dinâmica Actor Critic


  • A cada passo:
    • O ator escolhe a ação (igual à rede de política no REINFORCE)

Em cima: um grande retângulo chamado 'agente'; dentro dele, dois retângulos menores chamados 'ator' e 'crítico'. Embaixo: um retângulo separado chamado 'ambiente'.

Aprendizado por reforço profundo em Python

A dinâmica Actor Critic


  • A cada passo:
    • O ator escolhe a ação (igual à rede de política no REINFORCE)
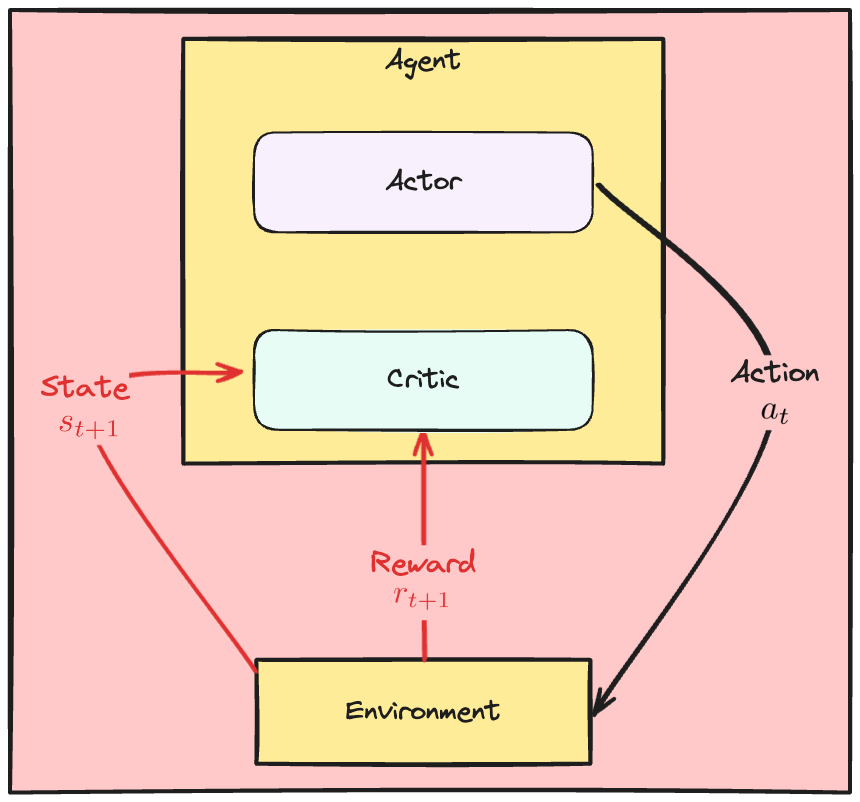
    • O crítico observa a recompensa e o estado

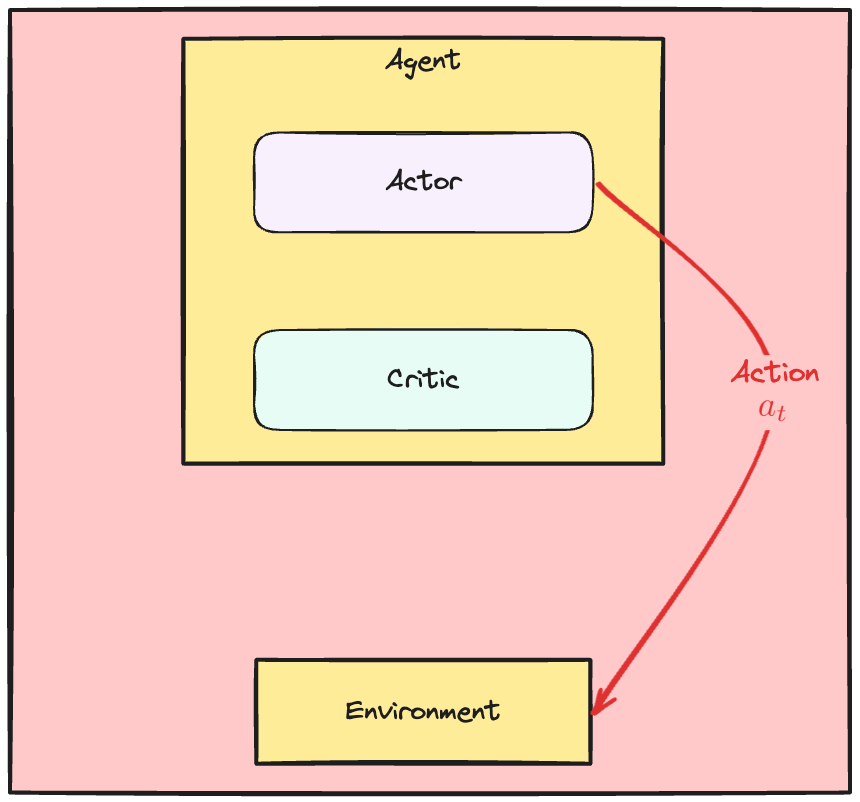
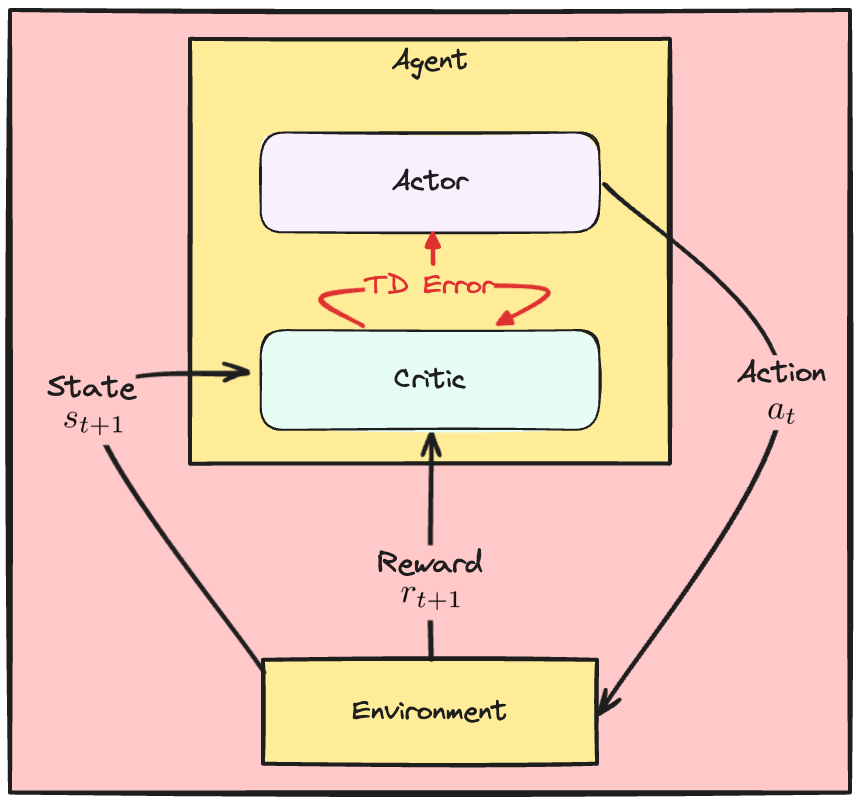
Uma seta vermelha chamada 'ação' vai do ator para o ambiente.

Aprendizado por reforço profundo em Python

A dinâmica Actor Critic


  • A cada passo:
    • O ator escolhe a ação (igual à rede de política no REINFORCE)
    • O crítico observa a recompensa e o estado
    • O crítico calcula o erro TD
    • Ator e crítico usam o erro TD para atualizar os pesos

Duas setas vermelhas, chamadas 'Estado' e 'Recompensa', vão do ambiente para o Crítico.

Aprendizado por reforço profundo em Python

A dinâmica Actor Critic


  • A cada passo:
    • O ator escolhe a ação (igual à rede de política no REINFORCE)
    • O crítico observa a recompensa e o estado
    • O crítico calcula o erro TD
    • Ator e crítico usam o erro TD para atualizar os pesos
    • O ator atualizado observa o novo estado

Uma seta chamada 'erro TD' vai do Crítico para o Ator.

Aprendizado por reforço profundo em Python

A dinâmica Actor Critic


  • A cada passo:
    • O ator escolhe a ação (igual à rede de política no REINFORCE)
    • O crítico observa a recompensa e o estado
    • O crítico calcula o erro TD
    • Ator e crítico usam o erro TD para atualizar os pesos
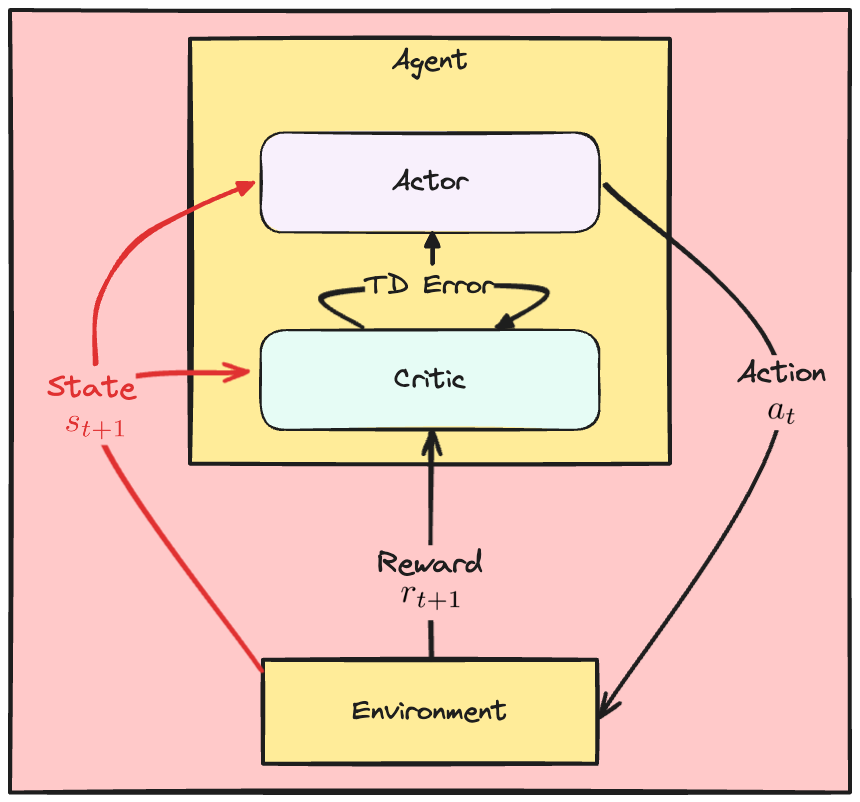
    • O ator atualizado observa o novo estado
  • ... recomeça

A seta de Estado agora vai também para o Ator.

Aprendizado por reforço profundo em Python

As perdas do A2C


Crítico

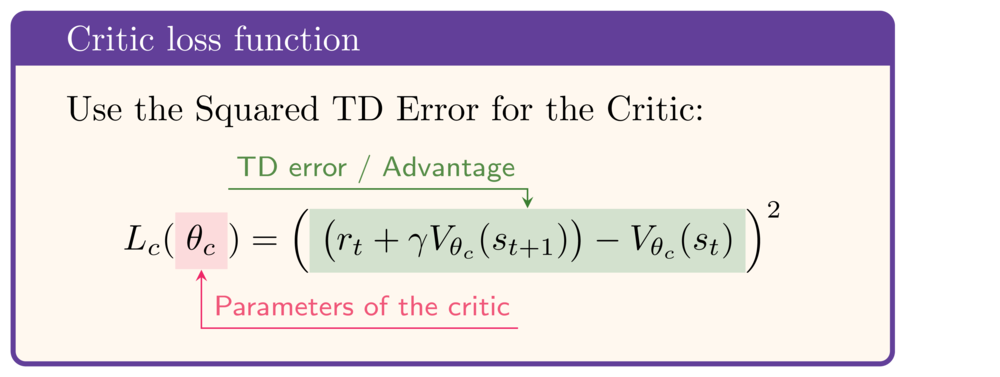
A função de perda do crítico. Use o erro TD ao quadrado para o crítico: Lc(theta c) = ((r_t + gamma * V theta c (s t + 1)) - V theta c) ao quadrado

  • Perda do crítico: erro TD ao quadrado


Ator
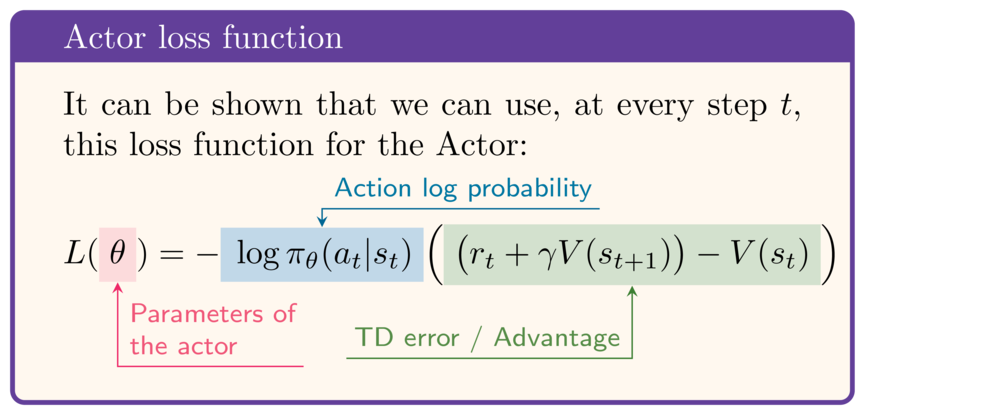
A função de perda do ator. Pode-se mostrar que, a cada passo t, podemos usar a seguinte perda para o ator: L(theta) igual a menos o log da probabilidade da ação vezes o erro TD ou vantagem.

  • O erro TD reflete a avaliação do crítico
  • Aumentar a probabilidade de ações com erro TD positivo
Aprendizado por reforço profundo em Python

Calculando as perdas


def calculate_losses(critic_network, action_log_prob, 
                     reward, state, next_state, done):

# Critic provides the state value estimates value = critic_network(state)
next_value = critic_network(next_state)
td_target = (reward + gamma * next_value * (1-done))
td_error = td_target - value
# Apply formulas for actor and critic losses actor_loss = -action_log_prob * td_error.detach()
critic_loss = td_error ** 2
return actor_loss, critic_loss


  • Calcular o erro TD
  • Calcular a perda do ator
    • Use .detach() para impedir a propagação do gradiente para os pesos do crítico
  • Calcular a perda do crítico
Aprendizado por reforço profundo em Python

O loop de treino Actor Critic

for episode in range(10):
  state, info = env.reset()
  done = False
  while not done:

# Select action action, action_log_prob = select_action(actor, state)
next_state, reward, terminated, truncated, _ = env.step(action) done = terminated or truncated
# Calculate losses actor_loss, critic_loss = calculate_losses(critic, action_log_prob, reward, state, next_state, done)
# Update actor actor_optimizer.zero_grad(); actor_loss.backward(); actor_optimizer.step()
# Update critic critic_optimizer.zero_grad(); critic_loss.backward(); critic_optimizer.step()
state = next_state
Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...