Introdução ao deep reinforcement learning

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Por que Deep Reinforcement Learning
 

  • RL tradicional serve para tarefas de baixa dimensão


  • Muitas aplicações têm estados e/ou ações de alta dimensão


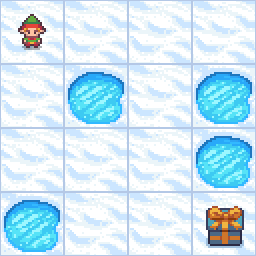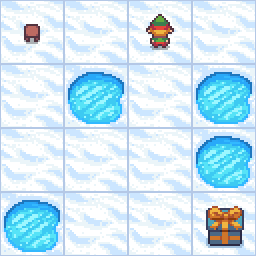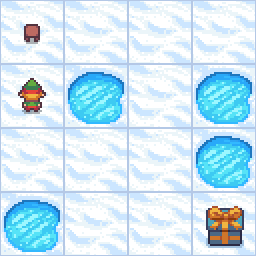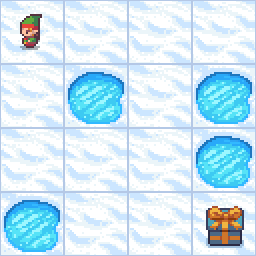
Um agente explorando o ambiente Frozen Lake

Um agente jogando o clássico videogame Space Invaders

Aprendizado por reforço profundo em Python

Os ingredientes do DRL


  1. Conceitos de Reinforcement Learning
  2. Deep Learning e PyTorch


  • DRL usa esses conceitos com redes neurais profundas


Ilustração em pixel art de um cozinheiro misturando ingredientes

Aprendizado por reforço profundo em Python

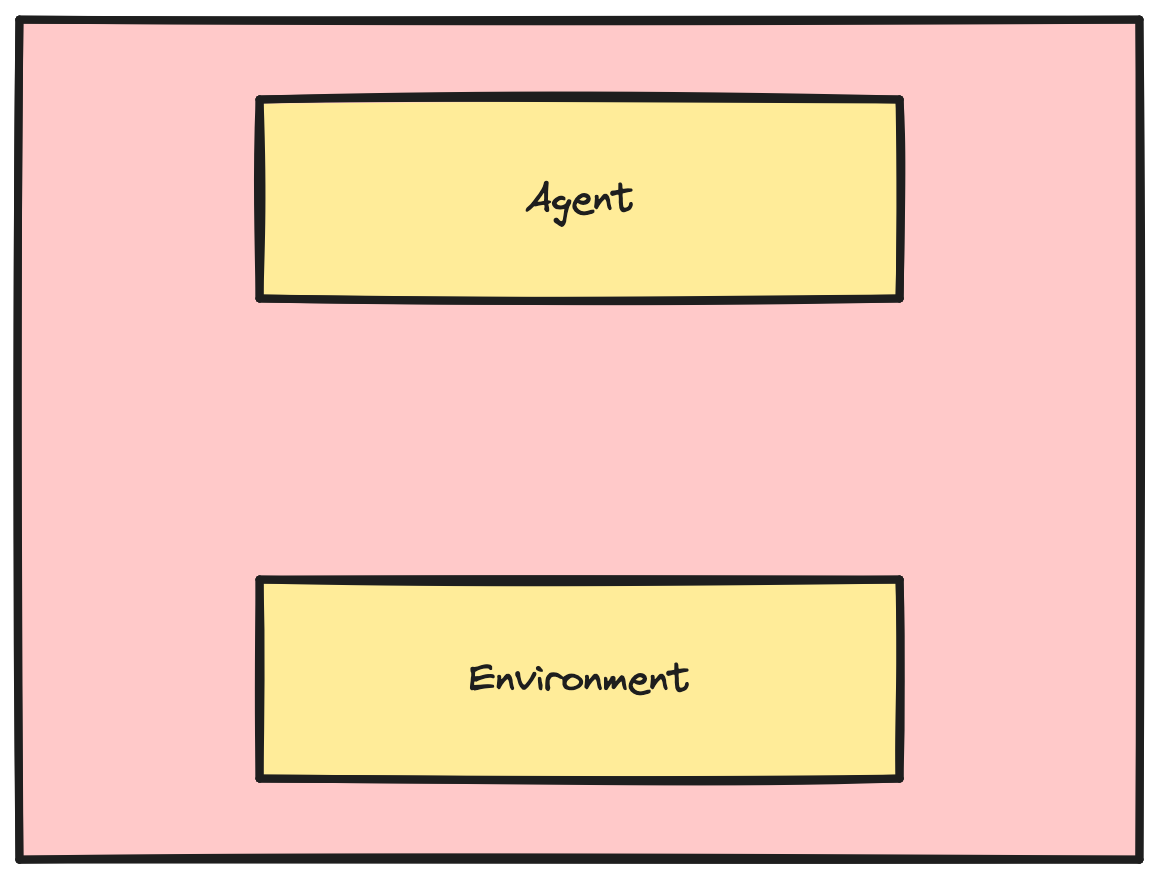
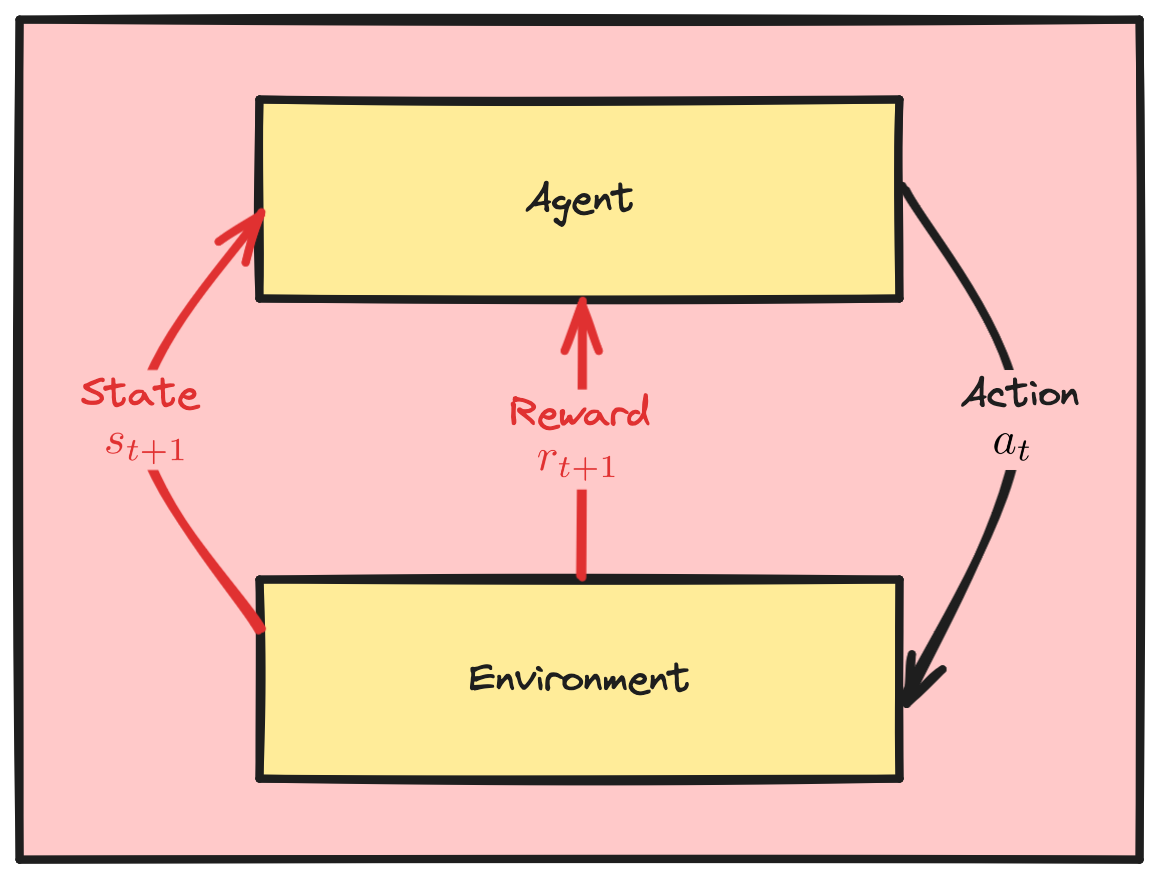
O framework de RL


  • Passo t:


Uma caixa grande com duas menores dentro, rotuladas "Agent" e "Environment"

Aprendizado por reforço profundo em Python

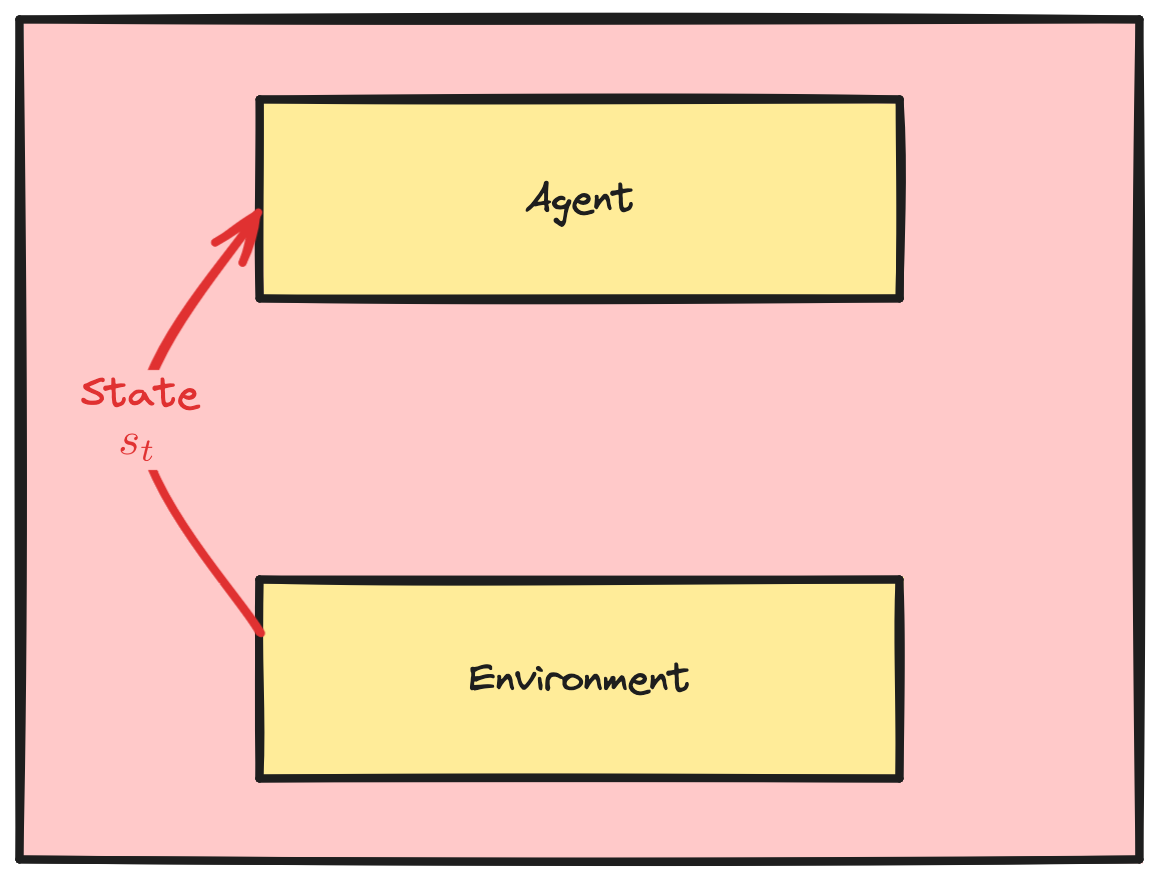
O framework de RL


  • Passo t:
    • O agente observa o estado $s_t$


Uma seta vermelha com o rótulo State s_t vai do environment para o agent.

Aprendizado por reforço profundo em Python

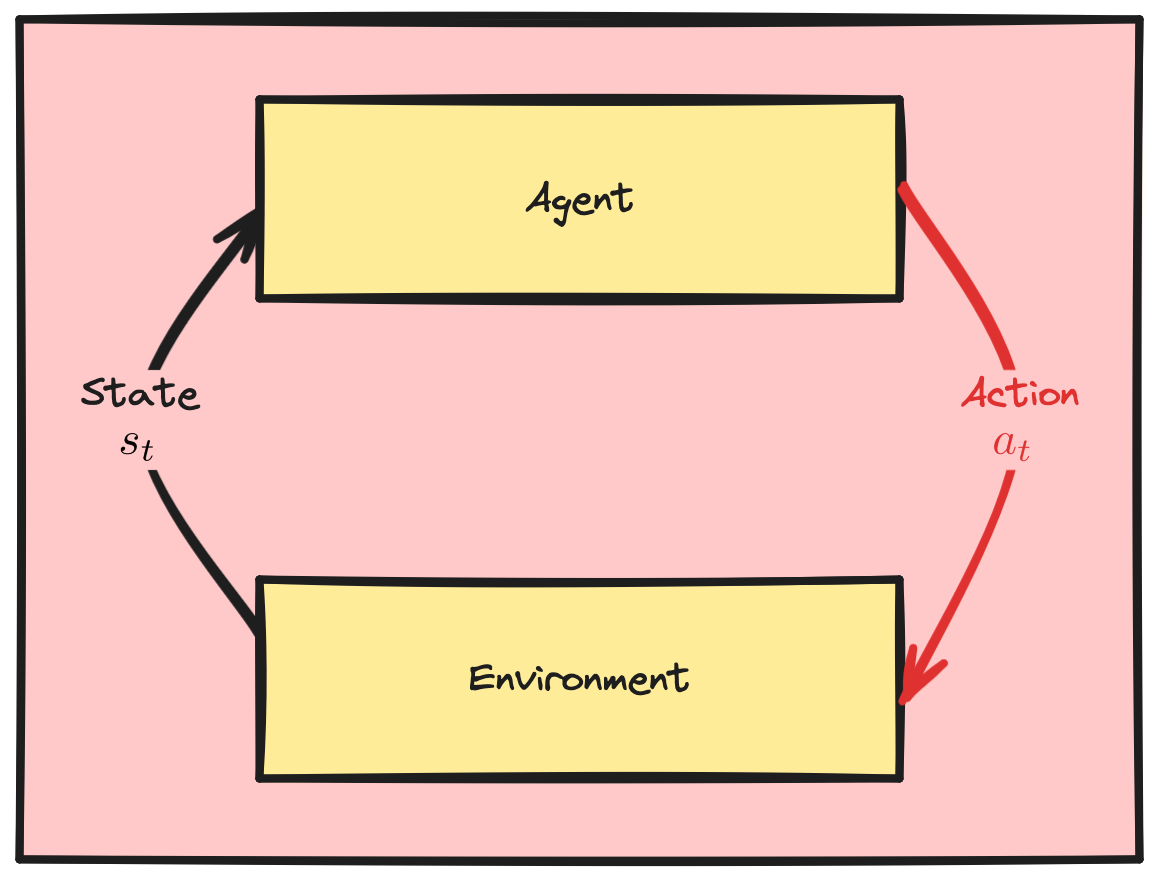
O framework de RL


  • Passo t:
    • O agente observa o estado $s_t$
    • O agente executa a ação $a_t$


Uma seta vermelha com o rótulo action a_t vai do agent para o environment. A seta de estado agora está preta.

Aprendizado por reforço profundo em Python

O framework de RL


  • Passo t:
    • O agente observa o estado $s_t$
    • O agente executa a ação $a_t$
  • Passo t+1:
    • O ambiente dá a recompensa $r_t$
    • O estado evolui para $s_{t+1}$


A seta state s_t atualiza o rótulo para state s_t+1 e volta a ser vermelha. Uma nova seta vermelha rotulada reward r_t+1 vai do environment para o agent. A seta de ação agora está preta.

Aprendizado por reforço profundo em Python

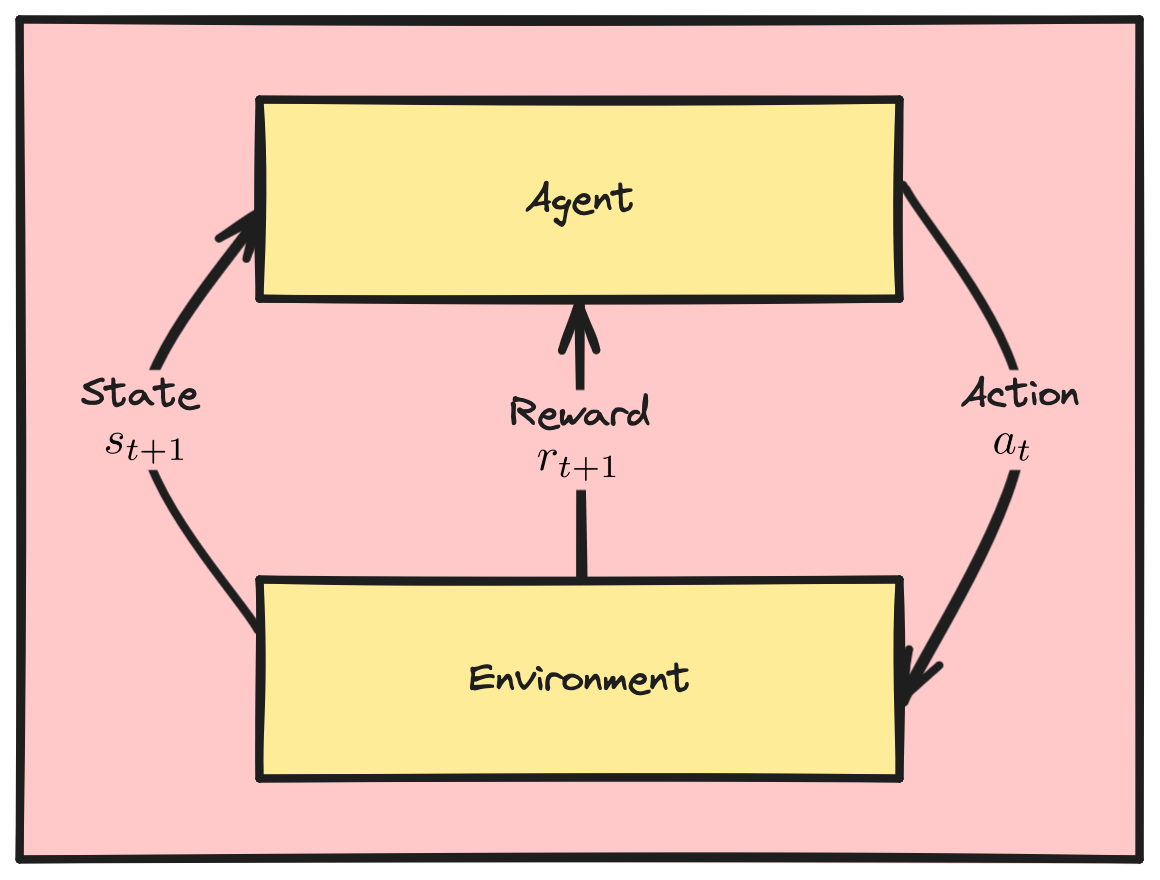
O framework de RL


  • Passo t:
    • O agente observa o estado $s_t$
    • O agente executa a ação $a_t$
  • Passo t+1:
    • O ambiente dá a recompensa $r_t$
    • O estado evolui para $s_{t+1}$
  • Repetir até o episódio terminar


A mesma imagem do slide anterior, mas todas as setas estão pretas.

Aprendizado por reforço profundo em Python

Política $\pi(s_t)$


  • Mapeamento de estado para ação, descrevendo como o agente se comporta em um estado $s_t$


  • Determinística:
    • Retorna a ação escolhida
  • Estocástica:
    • Retorna uma distribuição sobre ações
    • A política é uma distribuição de probabilidade sobre possíveis ações
Aprendizado por reforço profundo em Python

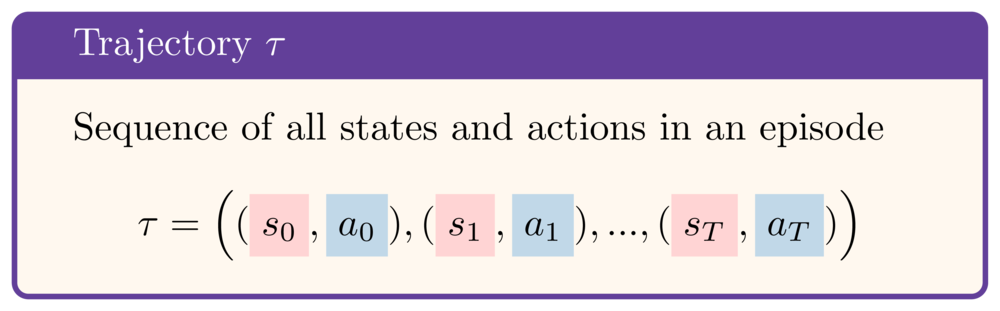
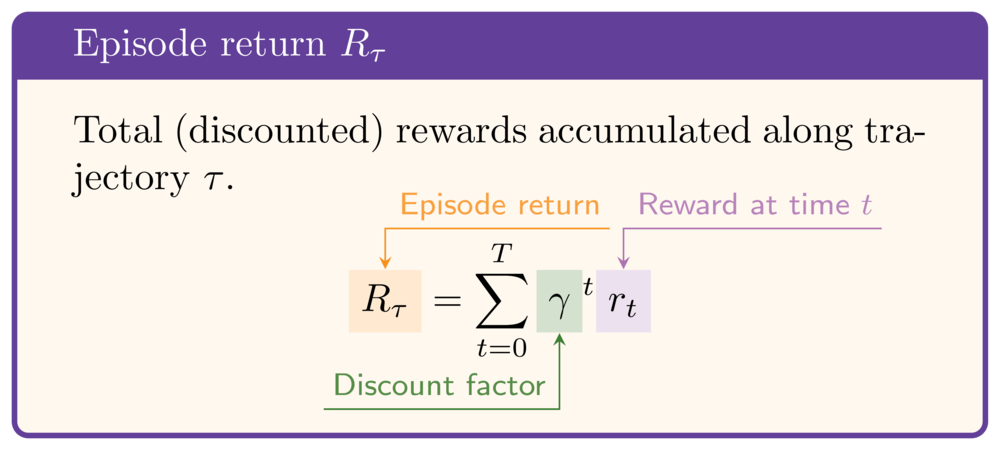
Trajetória e retorno do episódio


Trajetória tau: sequência de todos os estados e ações em um episódio; tau = ((s0, a0), (s1, a1), ... (sT, aT))


Retorno do episódio Rtau: recompensas totais (com desconto) acumuladas ao longo da trajetória tau. Rtau = soma em t de gamma elevado a t vezes r_t

Aprendizado por reforço profundo em Python

Configurando o ambiente

env = gym.make("ALE/SpaceInvaders-v5")

# Define neural network architecture class Network(nn.Module): def __init__(self, dim_inputs, dim_outputs): super(Network, self).__init__() self.linear = nn.Linear(dim_inputs, dim_outputs) def forward(self, x): return self.linear(x)
# Instantiate network network = Network(dim_inputs, dim_outputs)
# Instantiate optimizer optimizer = optim.Adam(network.parameters(), lr=0.0001)
Aprendizado por reforço profundo em Python

O loop básico

for episode in range(1000):
  state, info = env.reset()
  done = False

while not done:
action = select_action(network, state)
next_state, reward, terminated, truncated, _ = ( env.step(action)) done = terminated or truncated
loss = calculate_loss(network, state, action, next_state, reward, done) optimizer.zero_grad() loss.backward() optimizer.step()
state = next_state


  • Loop externo: iterar pelos episódios
  • Loop interno: iterar pelos passos
    • Selecionar uma ação
    • Observar novo estado e recompensa
    • Calcular a perda e atualizar a rede
    • Atualizar o estado
  • (Perda?)
Aprendizado por reforço profundo em Python

A seguir


  • DRL é poderoso!
  • Abordagens baseadas em valor e em política
  • DQN e aprimoramentos
  • Métodos de gradiente de política

Uma pessoa estudante da DataCamp mergulhando no mar para descobrir os segredos de Deep Reinforcement Learning

Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...