Policy gradient e REINFORCE

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Diferenças em relação ao DQN
  • REINFORCE: Monte Carlo, não Temporal Difference
    • Atualiza no fim do episódio, e não a cada passo
    • Pode atualizar após vários episódios
  • Sem função de valor
  • Sem rede-alvo
  • Sem epsilon-greediness
  • Sem replay de experiência

Imagens representando: a função valor de ação Q, replay de experiência, epsilon-greediness e q-alvos fixos, empilhadas e riscadas

Aprendizado por reforço profundo em Python

A estrutura do loop de treino do REINFORCE


for episode in range(num_episodes):

# 1. Initialize episode
while not done:
# 2. Select action
# 3. Play action and obtain next state and reward
# 4. Add (discounted) reward to return
# 5. Update state
# 6. Calculate loss
# 7. Update policy network by gradient descent
Aprendizado por reforço profundo em Python

Seleção de ação


from torch.distributions import Categorical

def select_action(policy_network, state):
  action_probs = policy_network(state)

action_dist = Categorical(action_probs)
action = action_dist.sample()
log_prob = action_dist.log_prob(action)
return action.item(), log_prob.reshape(1)
action, log_prob = select_action( policy_network, state)


  • Obter probabilidades da rede
  • Amostrar uma ação
  • Retornar a ação e os log-probabilities correspondentes


Índice da ação amostrada: 1
Log probability da ação amostrada: -1.38
Aprendizado por reforço profundo em Python

Cálculo da perda


Lembre o teorema do policy gradient:
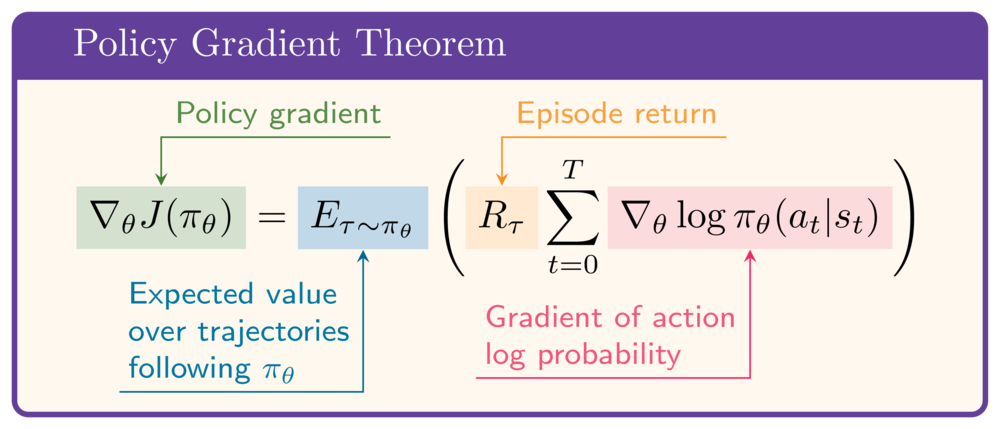
O teorema do policy gradient: o gradiente de J(pi_theta) em relação a theta é a esperança sobre trajetórias tau seguindo pi_theta do retorno do episódio multiplicado pela soma dos gradientes dos logs das probabilidades de ação, somada sobre todas as ações na trajetória.

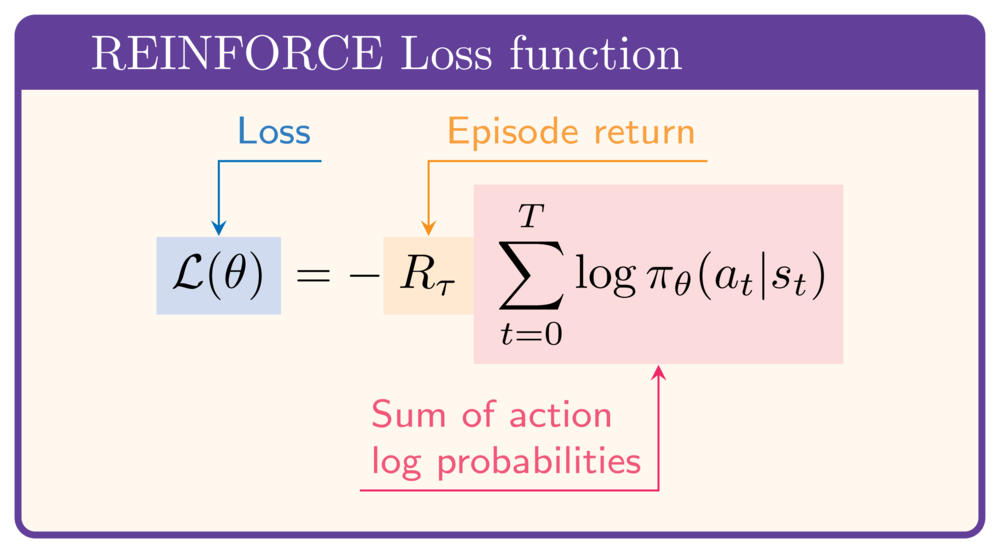
A função de perda do REINFORCE para um episódio: L(theta) é igual a menos o retorno do episódio vezes a soma dos logs das probabilidades de ação.

Em Python:

  • $R_{\tau}$ como episode_return
  • Vetor de $\log\pi_\theta(a_t|s_t)$ como episode_log_probs
loss = -episode_return * episode_log_probs.sum()
Aprendizado por reforço profundo em Python

O loop de treino do REINFORCE

for episode in range(50):
  state, info = env.reset(); done = False; step = 0;
  episode_log_probs = torch.tensor([])

R = 0
while not done: step += 1 action, log_prob = select_action(policy_network, state)
next_state, reward, terminated, truncated, _ = env.step(action) done = terminated or truncated
R += (gamma ** step) * reward
episode_log_probs = torch.cat((episode_log_probs, log_prob))
state = next_state
loss = - R * episode_log_probs.sum()
optimizer.zero_grad(); loss.backward(); optimizer.step()
Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...