Introdução ao policy gradient

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Introdução a métodos de Política em DRL


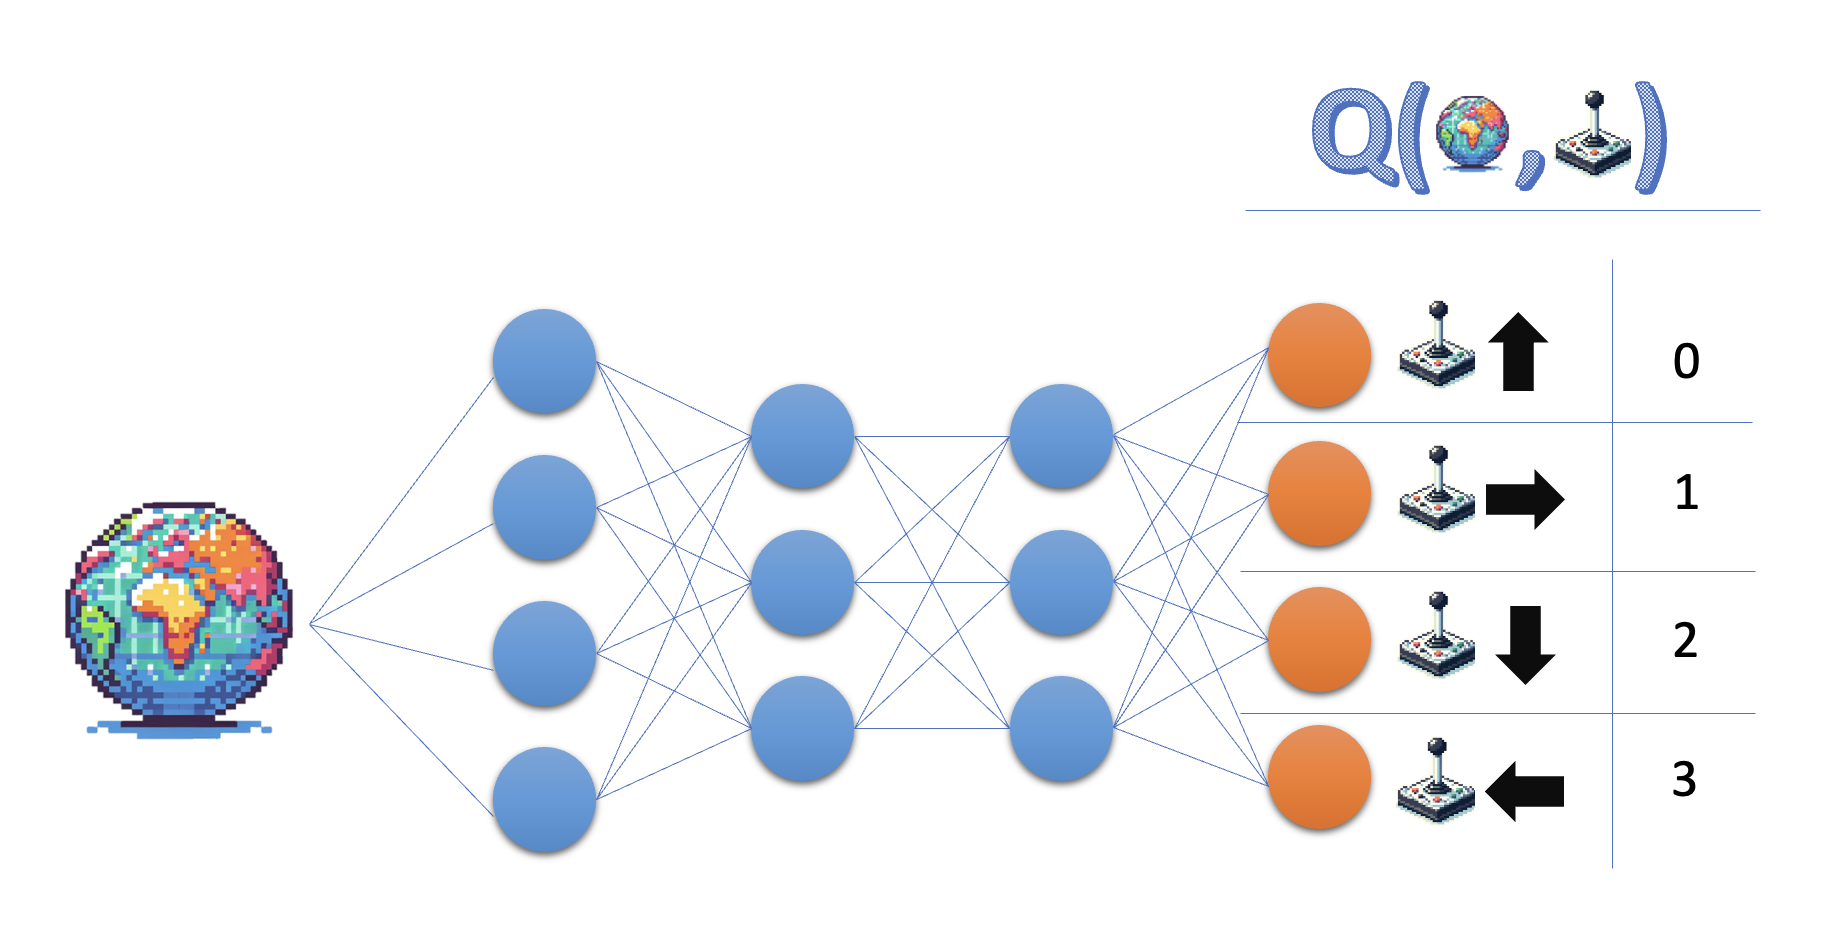
Q-learning:

  • Aprende a função valor de ação Q

Uma Q-network, com o estado como entrada e os valores das ações como saída

  • Política: seleciona a ação de maior valor


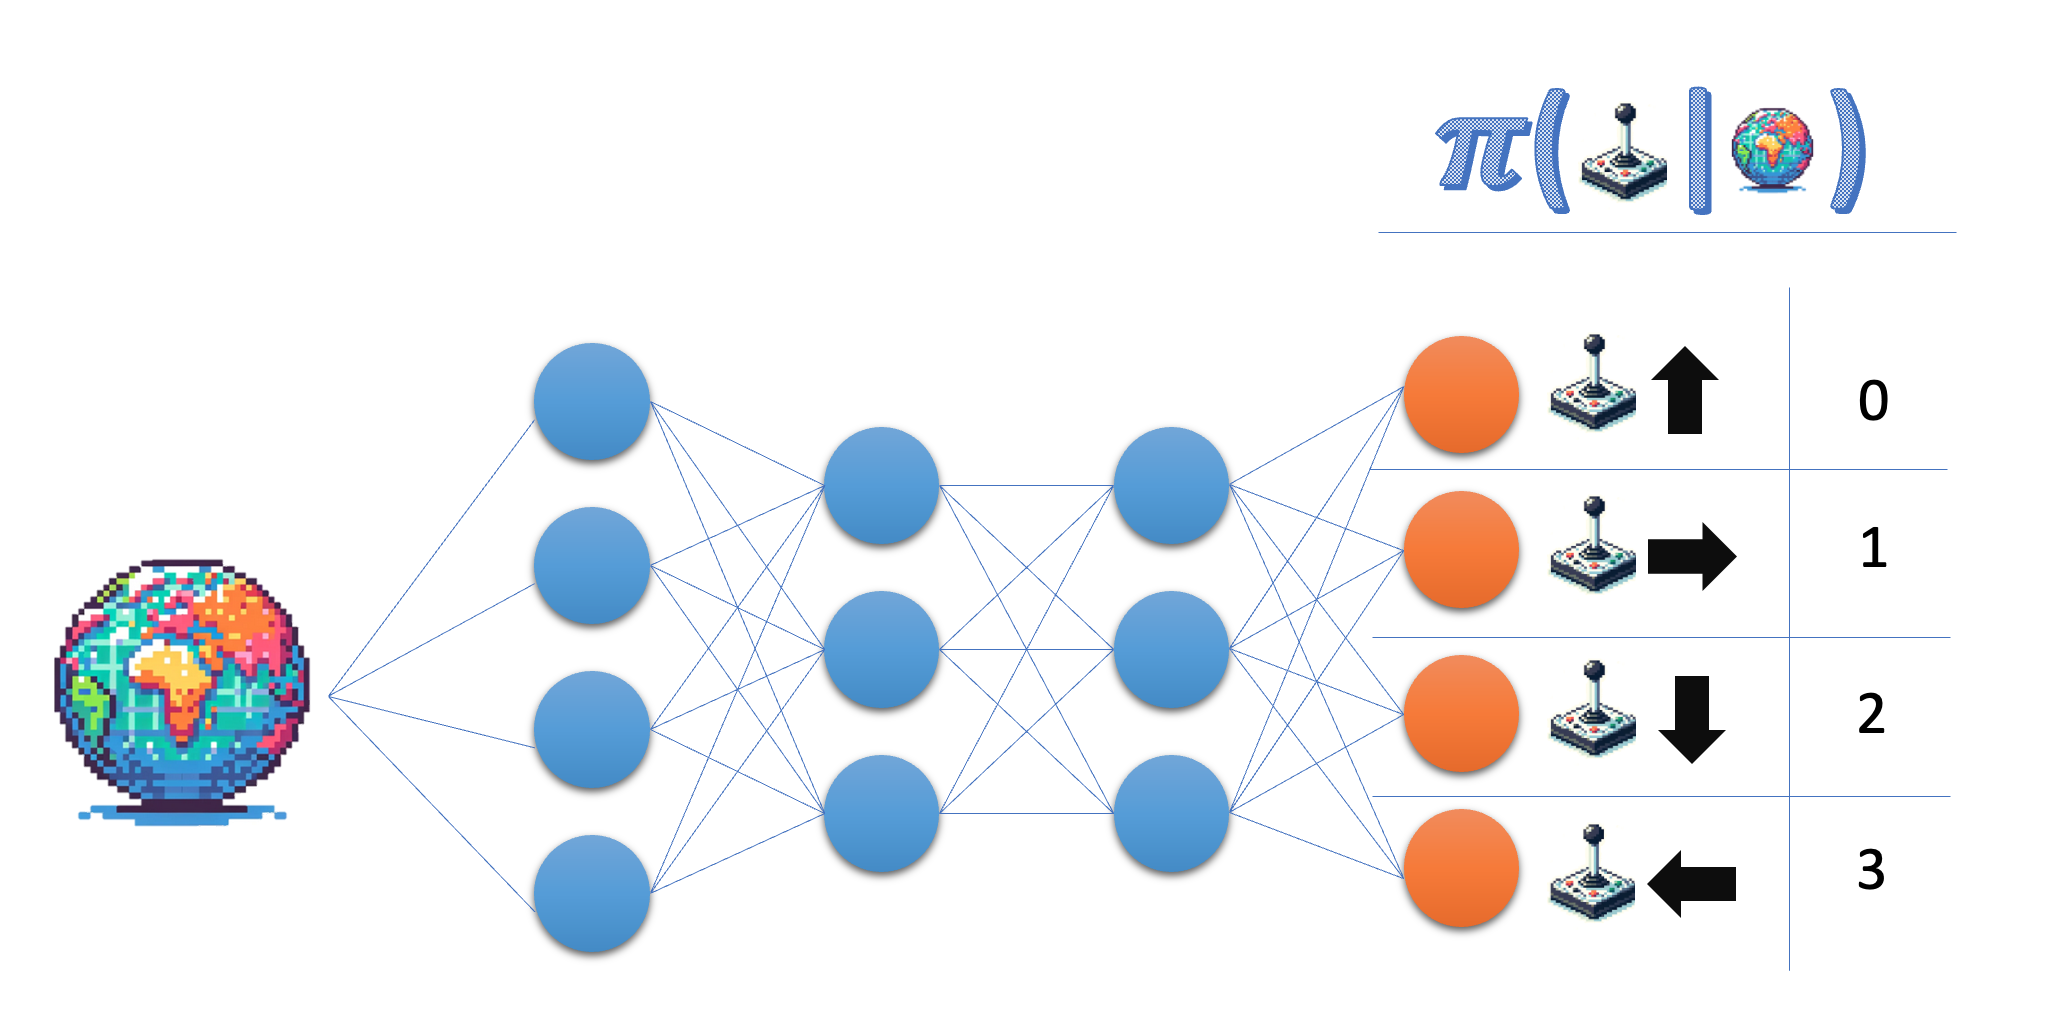
Aprendizado de política:

  • Aprende a política diretamente

Uma policy network, com o estado como entrada e as probabilidades das ações como saída

Aprendizado por reforço profundo em Python

Aprendizado de política


  • Pode ser estocástica
  • Lida com espaços contínuos
  • Otimiza o objetivo diretamente
  • Alta variância
  • Menos eficiente em amostras


  • Em Deep-Q learning: políticas são determinísticas


$\pi_\theta(a_t | s_t)$:

  • Distribuição de probabilidade de $a_t$ no estado $s_t$, com:
    • $a_t$, $s_t$: ação e estado no passo $t$
    • $\theta$: parâmetros da política (pesos da rede)
Aprendizado por reforço profundo em Python

A policy network (ações discretas)

class PolicyNetwork(nn.Module):
  def __init__(self, state_size, action_size):
    super(PolicyNetwork, self).__init__()
    self.fc1 = nn.Linear(state_size, 64)
    self.fc2 = nn.Linear(64, 64)
    self.fc3 = nn.Linear(64, action_size)

  def forward(self, state):
    x = torch.relu(self.fc1(torch.tensor(state)))
    x = torch.relu(self.fc2(x))
    action_probs = torch.softmax(self.fc3(x), dim=-1)
    return action_probs

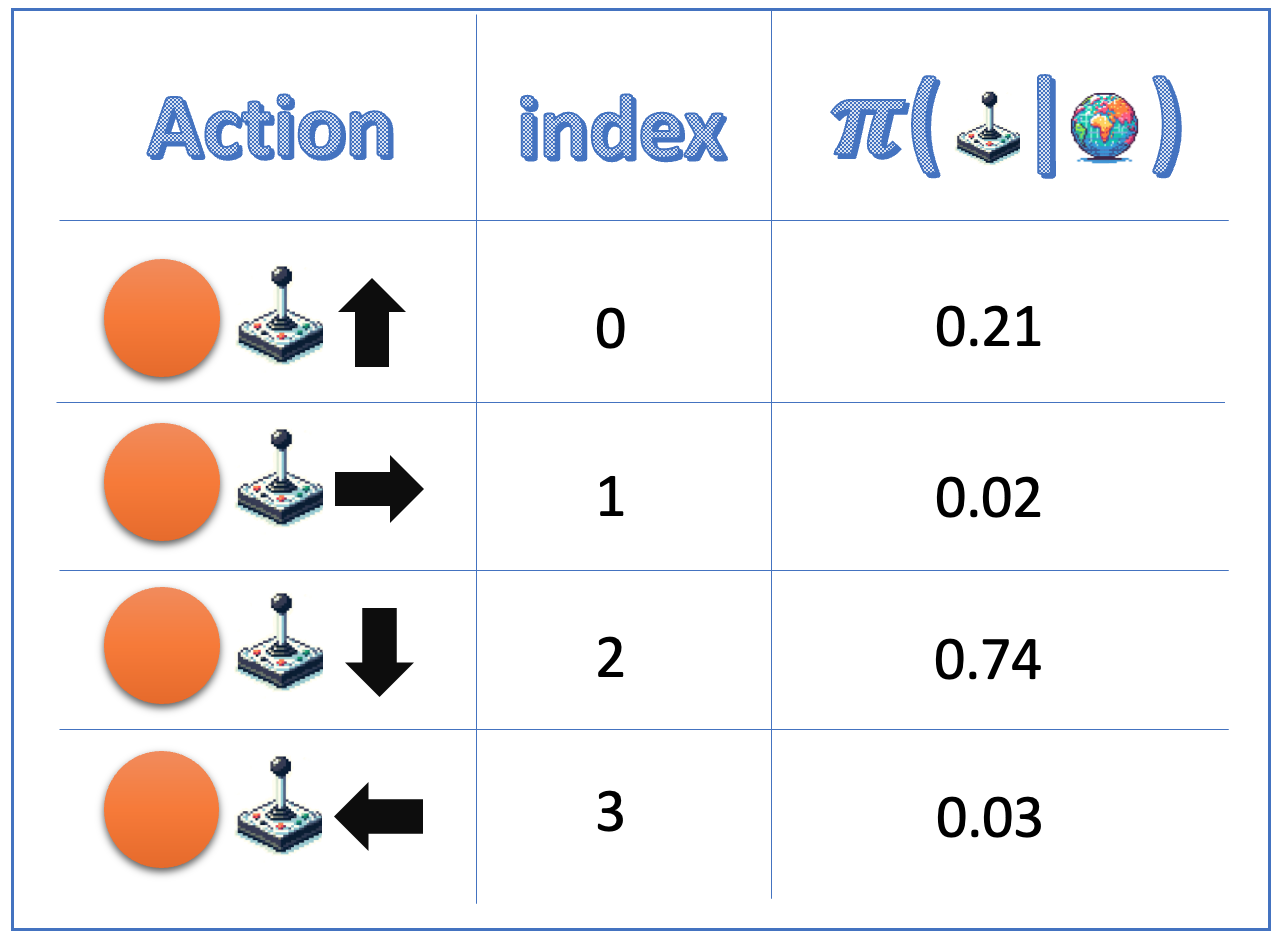
action_probs = policy_network(state) print('Action probabilities:', action_probs)
Action probabilities: tensor([0.21, 0.02, 0.74, 0.03])

Uma tabela mapeando cada uma das quatro ações possíveis para seu índice e probabilidade. A ação 'up' tem índice 0 e probabilidade 0,21; a ação 'right' tem índice 1 e probabilidade 0,02; a ação 'down' tem índice 2 e probabilidade 0,74; a ação 'left' tem índice 3 e probabilidade 0,03.

action_dist = (
    torch.distributions.Categorical(action_probs))

action = action_dist.sample()
Aprendizado por reforço profundo em Python

A função objetivo


  • A política deve maximizar os retornos esperados

    • Assumindo que o agente segue $\pi_\theta$
    • Otimizando o parâmetro $\theta$ da política
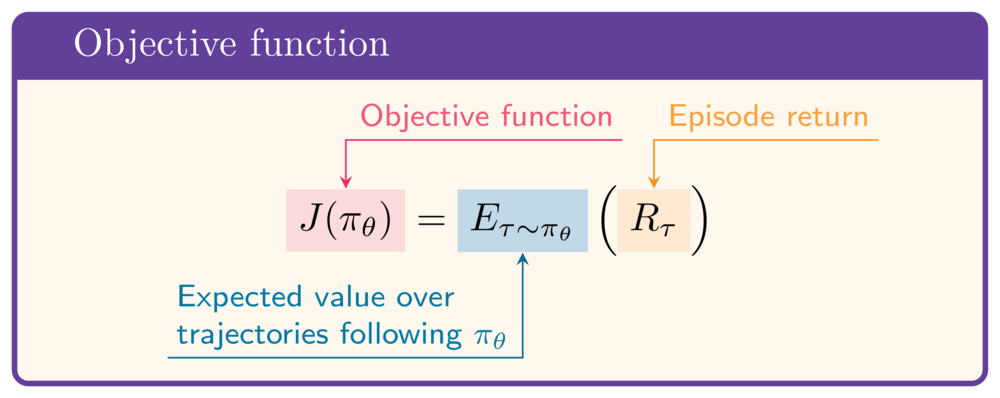
  • Função objetivo:

Uma equação: J(pi theta) = valor esperado sobre trajetórias tau seguindo pi theta de R_tau, onde R_tau é o retorno do episódio


  • Para maximizar $J$: precisa do gradiente em relação a $\theta$:
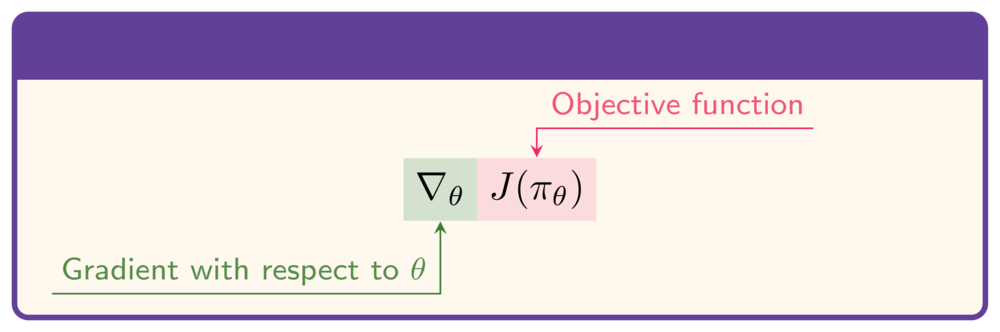
Gradiente de J(pi_theta) em relação a theta

Aprendizado por reforço profundo em Python

A função objetivo


  • A política deve maximizar os retornos esperados

    • Assumindo que o agente segue $\pi_\theta$
    • Otimizando o parâmetro $\theta$ da política
  • Função objetivo:

A definição de J(pi theta), igual à do slide anterior


  • Para maximizar $J$: precisa do gradiente em relação a $\theta$:
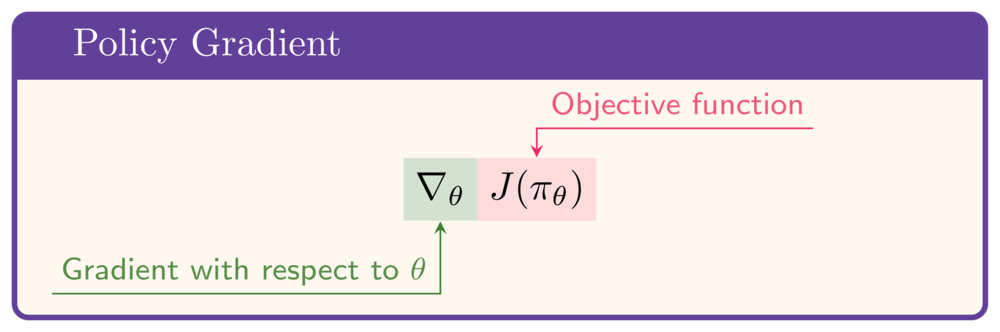
O gradiente de J(pi_theta) em relação a theta é chamado de policy gradient

Aprendizado por reforço profundo em Python

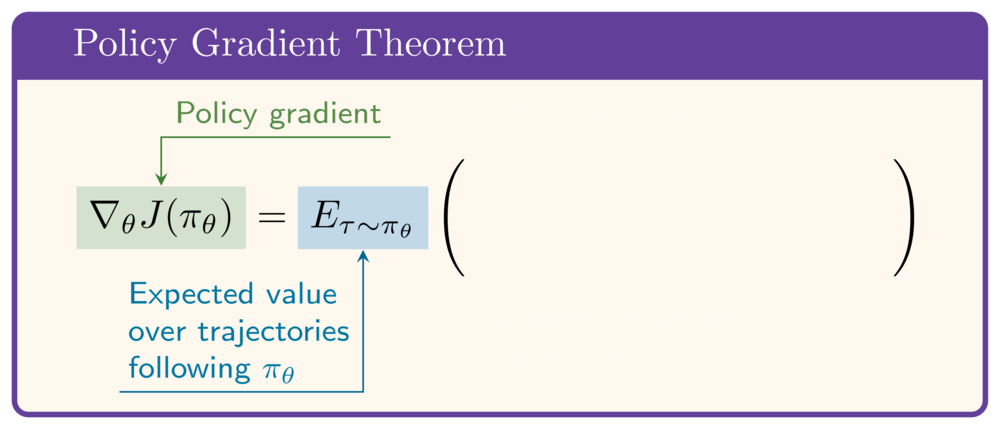
O teorema do policy gradient


  • Fornece uma expressão tratável para $\nabla_\theta J(\pi_\theta)$
  • Esperança sobre trajetórias seguindo $\pi_\theta$
    • Coletar trajetórias e observar os retornos


O teorema do policy gradient: O gradiente de J(pi_theta) em relação a theta é a esperança sobre trajetórias tau seguindo pi_theta de...

Aprendizado por reforço profundo em Python

O teorema do policy gradient


  • Fornece uma expressão tratável para $\nabla_\theta J(\pi_\theta)$
  • Esperança sobre trajetórias seguindo $\pi_\theta$
    • Coletar trajetórias e observar os retornos
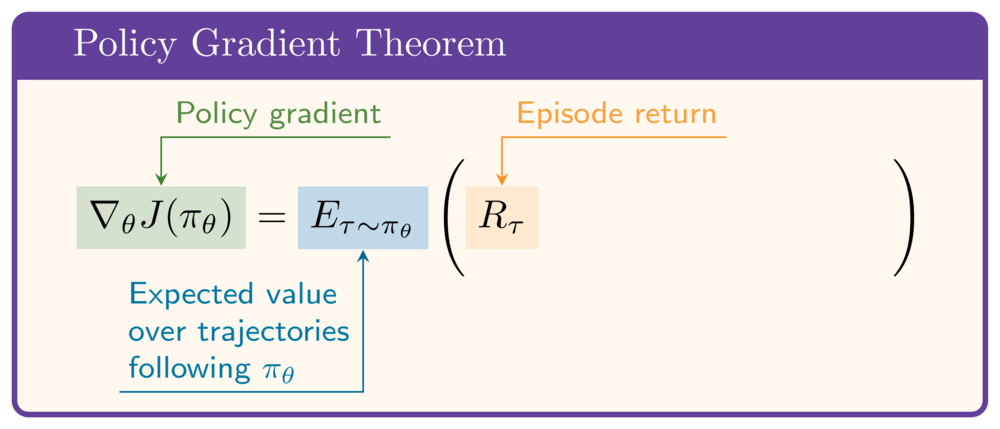
  • Para cada trajetória: considerar o retorno $R_\tau$


O teorema do policy gradient: O gradiente de J(pi_theta) em relação a theta é a esperança sobre trajetórias tau seguindo pi_theta do retorno do episódio multiplicado por...

Aprendizado por reforço profundo em Python

O teorema do policy gradient


  • Fornece uma expressão tratável para $\nabla_\theta J(\pi_\theta)$
  • Esperança sobre trajetórias seguindo $\pi_\theta$
    • Coletar trajetórias e observar os retornos
  • Para cada trajetória: considerar o retorno $R_\tau$
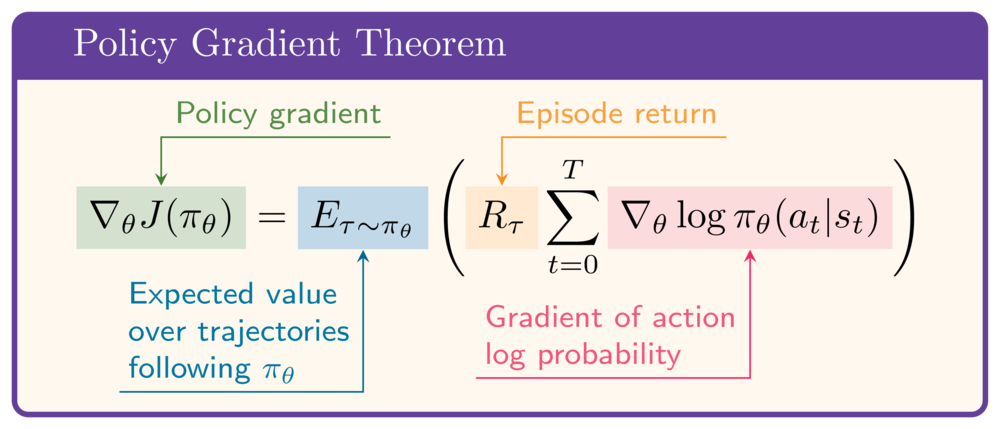
  • Multiplicar pela soma dos gradientes dos log-probabilidades das ações selecionadas
  • Intuição: ajustar theta para aumentar a probabilidade de todas as ações tomadas em um episódio "bom"


O teorema do policy gradient: O gradiente de J(pi_theta) em relação a theta é a esperança sobre trajetórias tau seguindo pi_theta do retorno do episódio multiplicado pela soma dos gradientes das log-probabilidades das ações, somados sobre todas as ações da trajetória.

Aprendizado por reforço profundo em Python


Um gif representando um jogo de Pong

Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...