Proximal policy optimization

Aprendizado por reforço profundo em Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

A2C

  • Atualizações de política no A2C:
    • Baseadas em estimativas voláteis
    • Podem ser grandes e instáveis
  • Podem prejudicar o desempenho

Um rover de Marte está quebrado após um acidente em terreno acidentado

PPO

  • PPO limita o tamanho de cada atualização de política
  • Melhora a estabilidade

Um rover de Marte segue feliz pela superfície marciana

Aprendizado por reforço profundo em Python

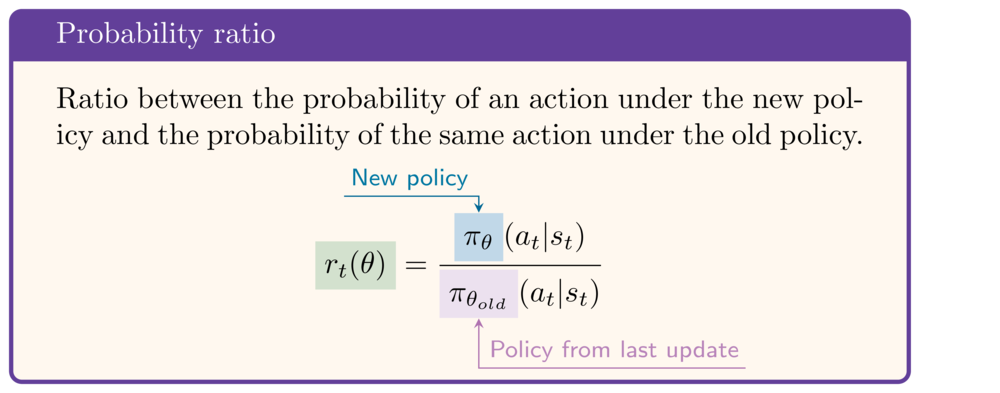
A razão de probabilidades

  • Principal inovação do PPO: uma nova função objetivo
  • No centro dela:

Razão de probabilidades: razão entre a probabilidade de uma ação sob a nova política e a probabilidade sob a antiga, denotada r_t

  • Quão mais provável é a ação $a_t$ com $\theta$ do que com $\theta_{old}$?


  ratio = action_log_prob.exp() / 
          old_action_log_prob.exp().detach()

# Or equivalently ratio = torch.exp(action_log_prob - old_action_log_prob.detach())
  • Faça detach do denominador para evitar propagação do gradiente
Aprendizado por reforço profundo em Python

Cortando a razão de probabilidades


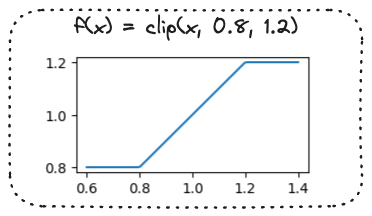
  • Função de corte (clip):

Um gráfico de clip(x, 0.8, 1.2) entre x=0.6 e x=1.4; a função vale 0,8 abaixo de x=0,8; x entre 0,8 e 1,2; 1,2 acima de 1,2.

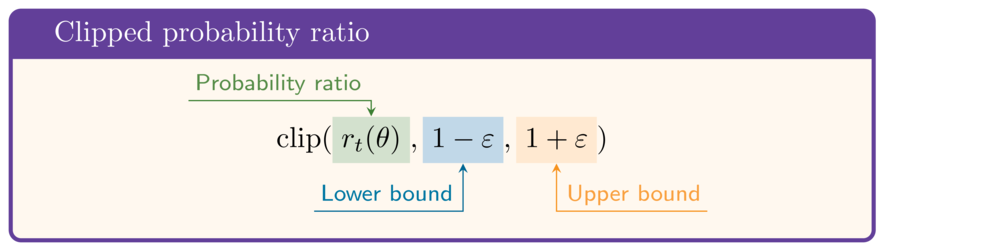
A razão de probabilidade com corte é clip(r_t, 1-epsilon, 1+epsilon)


clipped_ratio = torch.clamp(ratio,
                            1-epsilon, 
                            1+epsilon)
Aprendizado por reforço profundo em Python

A função calculate_ratios


def calculate_ratios(action_log_prob, action_log_prob_old, epsilon):

prob = action_log_prob.exp() prob_old = action_log_prob_old.exp() prob_old_detached = prob_old.detach() ratio = prob / prob_old_detached clipped_ratio = torch.clamp(ratio, 1-epsilon, 1+epsilon)
return (ratio, clipped_ratio)
Exemplo com epsilon = .2:

Razão: tensor(1.25)
Razão com corte: tensor(1.20)
Aprendizado por reforço profundo em Python

A função objetivo do PPO


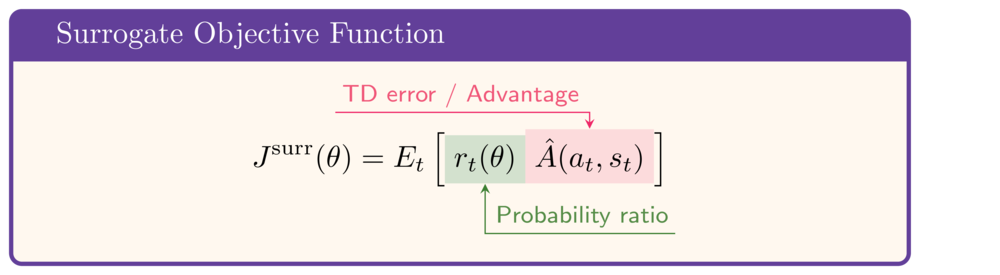
J surr = E_t(r_t * advantage)

surr1 = ratio * td_error.detach()

surr2 = clipped_ratio * td_error.detach()
objective = torch.min(surr1, surr2)


  • Substituto com razão cortada:

$$\mathrm{clip}(r_t(\theta),1-\varepsilon,1+\varepsilon)\hat{A}$$

  • Função objetivo do substituto com corte no PPO:
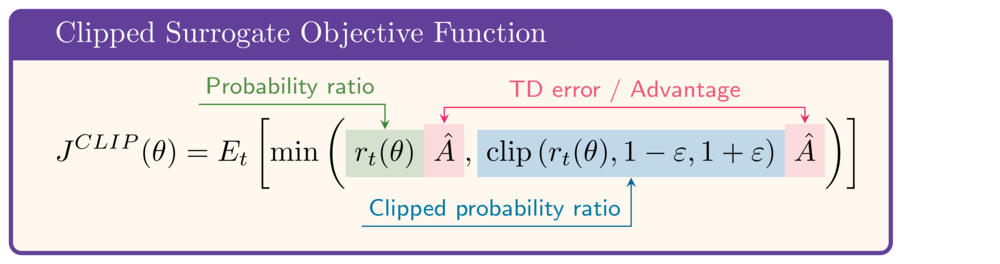
Função objetivo do substituto com corte: valor esperado do mínimo entre ratio * advantage e clipped ratio * advantage.

  • Mais estável que A2C
Aprendizado por reforço profundo em Python

Cálculo das perdas no PPO


def calculate_losses(critic_network, 
                     action_log_prob,                                        
                     action_log_prob_old,
                     reward, state, next_state,
                     done
                     ):

    # calculate TD error (same as A2C)
    value = critic_network(state)
    next_value = critic_network(next_state)
    td_target = (reward + 
                 gamma * next_value * (1-done))
    td_error = td_target - value
    ...


    ...
    ratio, clipped_ratio = 
            calculate_ratios(action_log_prob, 
                             action_log_prob_old,
                             epsilon)

surr1 = ratio * td_error.detach()
surr2 = clipped_ratio * td_error.detach()
objective = torch.min(surr1, surr2)
actor_loss = -objective
critic_loss = td_error ** 2 return actor_loss, critic_loss
Aprendizado por reforço profundo em Python

Vamos praticar!

Aprendizado por reforço profundo em Python

Preparing Video For Download...