ETL und ELT in Python
Jake Roach
Data Engineer
Daten müssen passend transformiert werden, damit nachgelagerte Nutzer Mehrwert erhalten
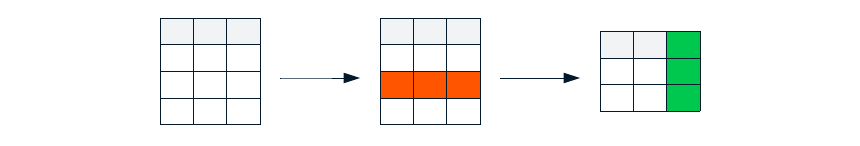
pandas bietet starke Tools, um Tabellendaten zu transformieren
.loc[].to_datetime()Mit .loc[] kannst du beide Dimensionen eines DataFrame transformieren
# Behalte nur Einträge ungleich 0
cleaned = raw_stock_data.loc[raw_stock_data["open"] > 0, :]
# Überflüssige Spalten entfernen
cleaned = raw_stock_data.loc[:, ["timestamps", "open", "close"]]
# In einem Schritt kombinieren
cleaned = raw_stock_data.loc[raw_stock_data["open"] > 0, ["timestamps", "open", "close"]]
.iloc[] filtert DataFrames per Integer-Index
cleaned = raw_stock_data.iloc[[0:50], [0, 1, 2]]
Datentypen müssen oft für nachgelagerte Use Cases konvertiert werden
.to_datetime()# Spalte "timestamps" sieht derzeit so aus: "20230101085731"
# Spalte "timestamps" in Typ datetime konvertieren
cleaned["timestamps"] = pd.to_datetime(cleaned["timestamps"], format="%Y%m%d%H%M%S")
Timestamp('2023-01-01 08:57:31')
# Spalte "timestamps" sieht derzeit so aus: 1681596000011
# Spalte "timestamps" in Typ datetime konvertieren
cleaned["timestamps"] = pd.to_datetime(cleaned["timestamps"], unit="ms")
Timestamp('2023-04-15 22:00:00.011000')
Daten zu transformieren birgt Risiken:
# Mehrere Wege, ein DataFrame zu untersuchen
cleaned = raw_stock_data.loc[raw_stock_data["open"] > 0, ["timestamps", "open", "close"]]
print(cleaned.head())
# Kleinste und größte Einträge zurückgeben
print(cleaned.nsmallest(10, ["timestamps"]))
print(cleaned.nlargest(10, ["timestamps"]))
ETL und ELT in Python