Preparação de dados para análise de clusters

Análise de cluster em Python

Shaumik Daityari

Business Analyst

Por que preparar os dados para clusterização?

  • Variáveis com unidades incomparáveis (dimensões em cm, preço em $)
  • Mesmas unidades, mas escalas/variâncias muito diferentes (gastos com cereais, viagens)
  • Dados brutos podem enviesar a clusterização
  • Clusters podem depender demais de uma variável
  • Solução: normalizar cada variável
Análise de cluster em Python

Normalização de dados

Normalização: reescalonar os dados para desvio padrão igual a 1

x_new = x / std_dev(x)

from scipy.cluster.vq import whiten
data = [5, 1, 3, 3, 2, 3, 3, 8, 1, 2, 2, 3, 5]
scaled_data = whiten(data)
print(scaled_data)
[2.73, 0.55, 1.64, 1.64, 1.09, 1.64, 1.64, 4.36, 0.55, 1.09, 1.09, 1.64, 2.73]
Análise de cluster em Python

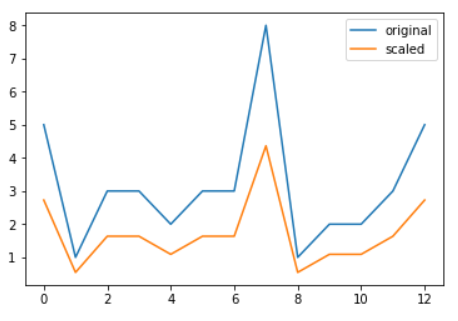
Ilustração: normalização de dados

# Import plotting library
from matplotlib import pyplot as plt

# Initialize original, scaled data
plt.plot(data, 
         label="original")
plt.plot(scaled_data, 
         label="scaled")
# Show legend and display plot
plt.legend()
plt.show()

Análise de cluster em Python

A seguir: exercícios práticos

Análise de cluster em Python

Preparing Video For Download...