Agrupamento de documentos

Análise de cluster em Python

Shaumik Daityari

Business Analyst

Agrupamento de documentos: conceitos

  1. Limpe os dados antes do processamento
  2. Determine a importância dos termos no documento (na matriz TF-IDF)
  3. Faça o clustering da matriz TF-IDF
  4. Encontre termos e documentos principais em cada cluster
Análise de cluster em Python

Limpar e tokenizar dados

  • Converta o texto em partes menores (tokens) e limpe os dados
from nltk.tokenize import word_tokenize
import re

def remove_noise(text, stop_words = []):
    tokens = word_tokenize(text)

cleaned_tokens = [] for token in tokens: token = re.sub('[^A-Za-z0-9]+', '', token)
if len(token) > 1 and token.lower() not in stop_words: # Get lowercase cleaned_tokens.append(token.lower()) return cleaned_tokens
remove_noise("It is lovely weather we are having. I hope the weather continues.")
['lovely', 'weather', 'hope', 'weather', 'continues']
Análise de cluster em Python

Matriz termo-documento e matrizes esparsas

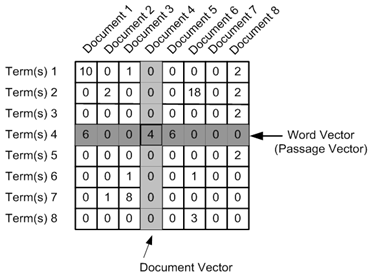
  • Matriz termo-documento formada
  • A maioria dos elementos é zero

Source

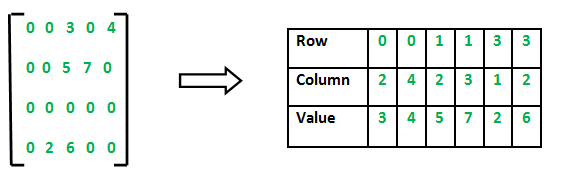
  • Cria-se uma matriz esparsa

Source

Análise de cluster em Python

TF-IDF (Term Frequency - Inverse Document Frequency)

  • Medida ponderada: avalia a importância de uma palavra num documento de uma coleção
from sklearn.feature_extraction.text import TfidfVectorizer

tfidf_vectorizer = TfidfVectorizer(max_df=0.8, max_features=50, min_df=0.2, tokenizer=remove_noise)
tfidf_matrix = tfidf_vectorizer.fit_transform(data)
Análise de cluster em Python

Agrupando com matriz esparsa

  • kmeans() no SciPy não aceita matrizes esparsas
  • Use .todense() para converter em matriz
cluster_centers, distortion = kmeans(tfidf_matrix.todense(), num_clusters)
Análise de cluster em Python

Principais termos por cluster

  • Centros dos clusters: listas do tamanho do nº de termos
  • Cada valor no centro indica sua importância
  • Crie um dicionário e imprima os termos principais
terms = tfidf_vectorizer.get_feature_names_out()

for i in range(num_clusters):
    center_terms = dict(zip(terms, list(cluster_centers[i])))

sorted_terms = sorted(center_terms, key=center_terms.get, reverse=True)
print(sorted_terms[:3])
['room', 'hotel', 'staff']

['bad', 'location', 'breakfast']
Análise de cluster em Python

Outras considerações

  • Trate hyperlinks, emoticons etc.
  • Normalize palavras (run, ran, running -> run)
  • .todense() pode falhar em bases grandes
Análise de cluster em Python

A seguir: exercícios!

Análise de cluster em Python

Preparing Video For Download...