Noções básicas de k-means

Análise de cluster em Python

Shaumik Daityari

Business Analyst

Por que k-means?

  • Um grande problema do agrupamento hierárquico: tempo de execução
  • K-means é bem mais rápido em conjuntos grandes
Análise de cluster em Python

Etapa 1: gerar centros dos clusters

kmeans(obs, k_or_guess, iter, thresh, check_finite)
  • obs: observações padronizadas
  • k_or_guess: número de clusters
  • iter: número de iterações (padrão: 20)
  • thres: limiar (padrão: 1e-05)
  • check_finite: verifica se há apenas números finitos (padrão: True)

Retorna dois objetos: centros dos clusters e distorção

Análise de cluster em Python

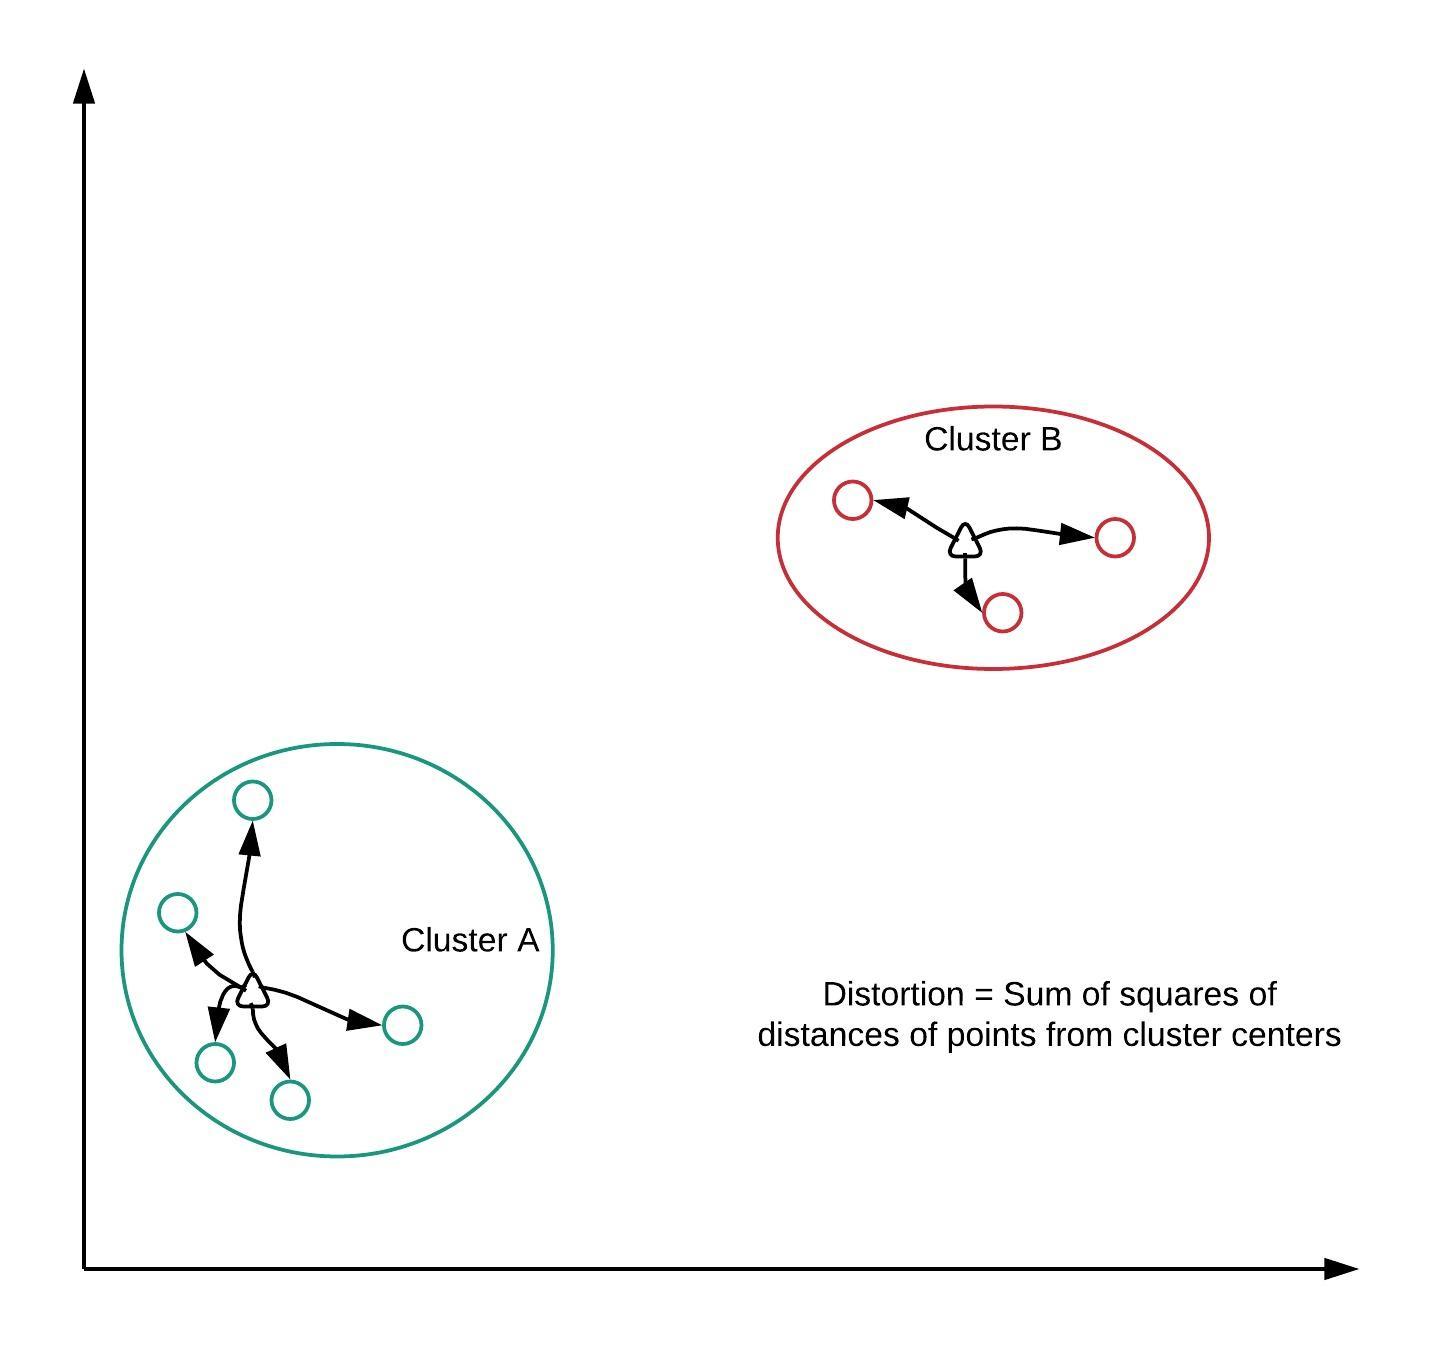
Como a distorção é calculada?

Análise de cluster em Python

Etapa 2: gerar rótulos dos clusters

vq(obs, code_book, check_finite=True)
  • obs: observações padronizadas
  • code_book: centros dos clusters
  • check_finite: verifica se há apenas números finitos (padrão: True)

Retorna dois objetos: lista de rótulos de cluster e lista de distorções

Análise de cluster em Python

Observação sobre distorções

  • kmeans retorna um único valor de distorção
  • vq retorna uma lista de distorções.
Análise de cluster em Python

Executando k-means

# Import kmeans and vq functions
from scipy.cluster.vq import kmeans, vq
# Generate cluster centers and labels
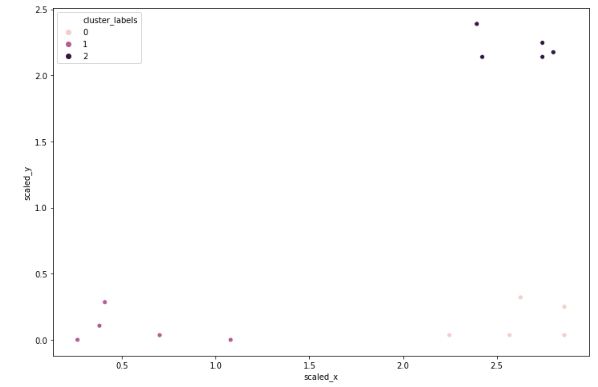
cluster_centers, _ = kmeans(df[['scaled_x', 'scaled_y']], 3)
df['cluster_labels'], _ = vq(df[['scaled_x', 'scaled_y']], cluster_centers)
# Plot clusters
sns.scatterplot(x='scaled_x', y='scaled_y', hue='cluster_labels', data=df)
plt.show()
Análise de cluster em Python

Análise de cluster em Python

Em seguida: exercícios!

Análise de cluster em Python

Preparing Video For Download...