Regressão logística e regularização

Classificadores Lineares em Python

Michael (Mike) Gelbart

Instructor, The University of British Columbia

Regressão logística regularizada
Classificadores Lineares em Python

Regressão logística regularizada

Classificadores Lineares em Python

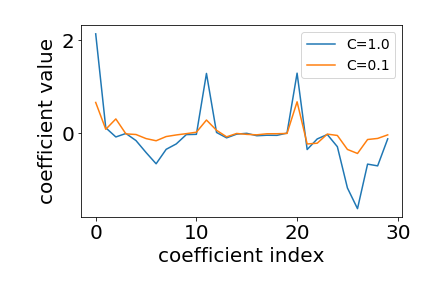
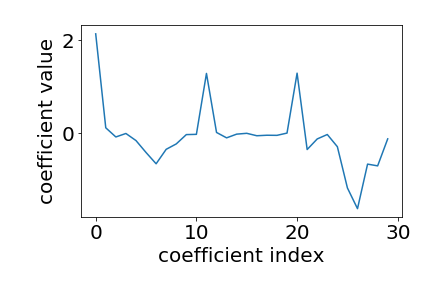
Como a regularização afeta a acurácia de treino?

lr_weak_reg = LogisticRegression(C=100)
lr_strong_reg = LogisticRegression(C=0.01)

lr_weak_reg.fit(X_train, y_train) lr_strong_reg.fit(X_train, y_train)
lr_weak_reg.score(X_train, y_train) lr_strong_reg.score(X_train, y_train)
1.0
0.92

$\text{regularized loss = original loss + large coefficient penalty}$

  • mais regularização: menor acurácia no treino
Classificadores Lineares em Python

Como a regularização afeta a acurácia de teste?

lr_weak_reg.score(X_test, y_test)
0.86
lr_strong_reg.score(X_test, y_test)
0.88

$\text{regularized loss = original loss + large coefficient penalty}$

  • mais regularização: menor acurácia no treino
  • mais regularização: (quase sempre) maior acurácia no teste
Classificadores Lineares em Python

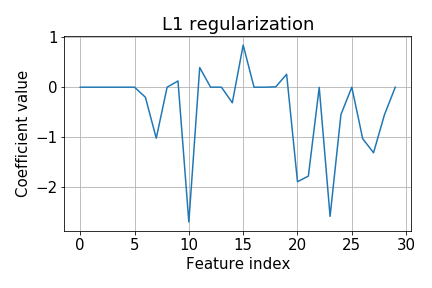
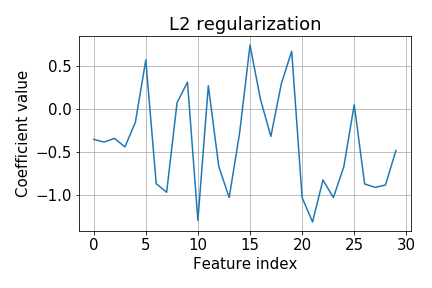
Regularização L1 vs. L2

  • Lasso = regressão linear com regularização L1
  • Ridge = regressão linear com regularização L2
  • Em outros modelos, como regressão logística, dizemos apenas L1, L2 etc.
lr_L1 = LogisticRegression(solver='liblinear', penalty='l1')
lr_L2 = LogisticRegression() # penalty='l2' by default

lr_L1.fit(X_train, y_train)
lr_L2.fit(X_train, y_train)
plt.plot(lr_L1.coef_.flatten())
plt.plot(lr_L2.coef_.flatten())
Classificadores Lineares em Python

Regularização L2 vs. L1

Classificadores Lineares em Python

Vamos praticar!

Classificadores Lineares em Python

Preparing Video For Download...