Machine Learning para dados de séries temporais em Python
Chris Holdgraf
Fellow, Berkeley Institute for Data Science


# Audio é um DataFrame do Pandas
print(audio.shape)
# (n_times, n_audio_files)
(5000, 20)
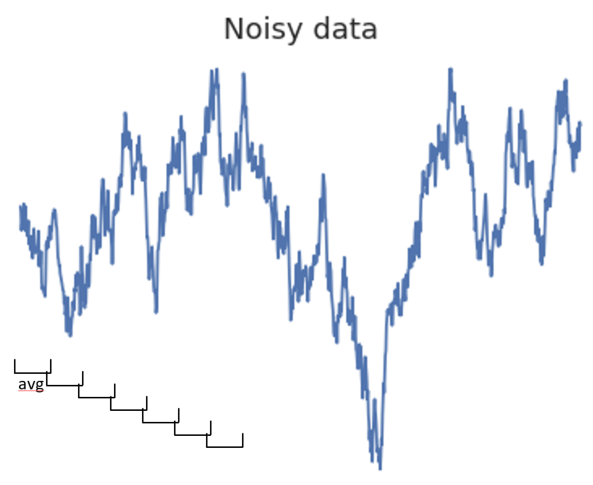
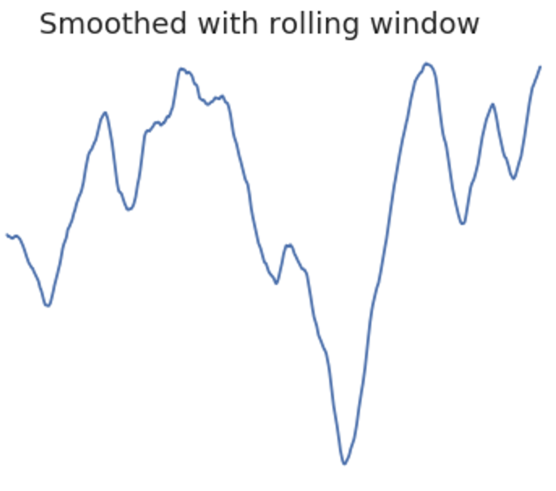
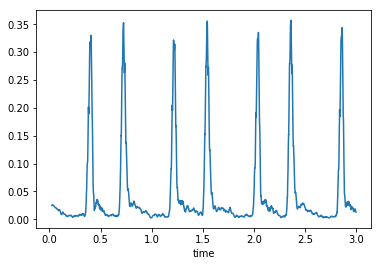
# Suavize os dados com a média móvel em uma janela de 50 amostras
window_size = 50
windowed = audio.rolling(window=window_size)
audio_smooth = windowed.mean()
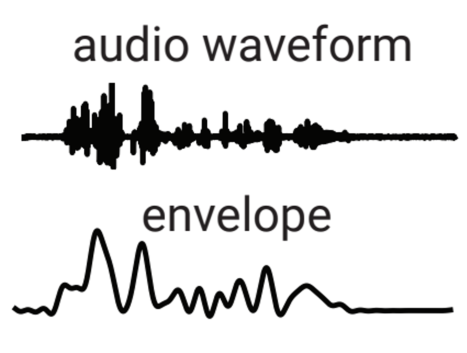
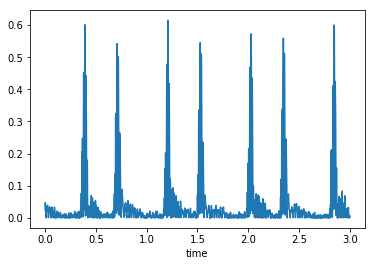
Primeiro retifique o áudio e depois suavize
audio_rectified = audio.apply(np.abs)
audio_envelope = audio_rectified.rolling(50).mean()


# Calcule várias features do envelope, uma por som
envelope_mean = np.mean(audio_envelope, axis=0)
envelope_std = np.std(audio_envelope, axis=0)
envelope_max = np.max(audio_envelope, axis=0)
# Crie nossos dados de treino para um classificador
X = np.column_stack([envelope_mean, envelope_std, envelope_max])
y = labels.reshape(-1, 1)
cross_val_score automatiza:from sklearn.model_selection import cross_val_score
model = LinearSVC()
scores = cross_val_score(model, X, y, cv=3)
print(scores)
[0.60911642 0.59975305 0.61404035]
librosa é ótima para engenharia de features auditivas e de séries temporais# Importe librosa e calcule o tempo de um array 1-D de áudio
import librosa as lr
audio_tempo = lr.beat.tempo(y=audio, sr=sfreq,
hop_length=2**6)
Machine Learning para dados de séries temporais em Python