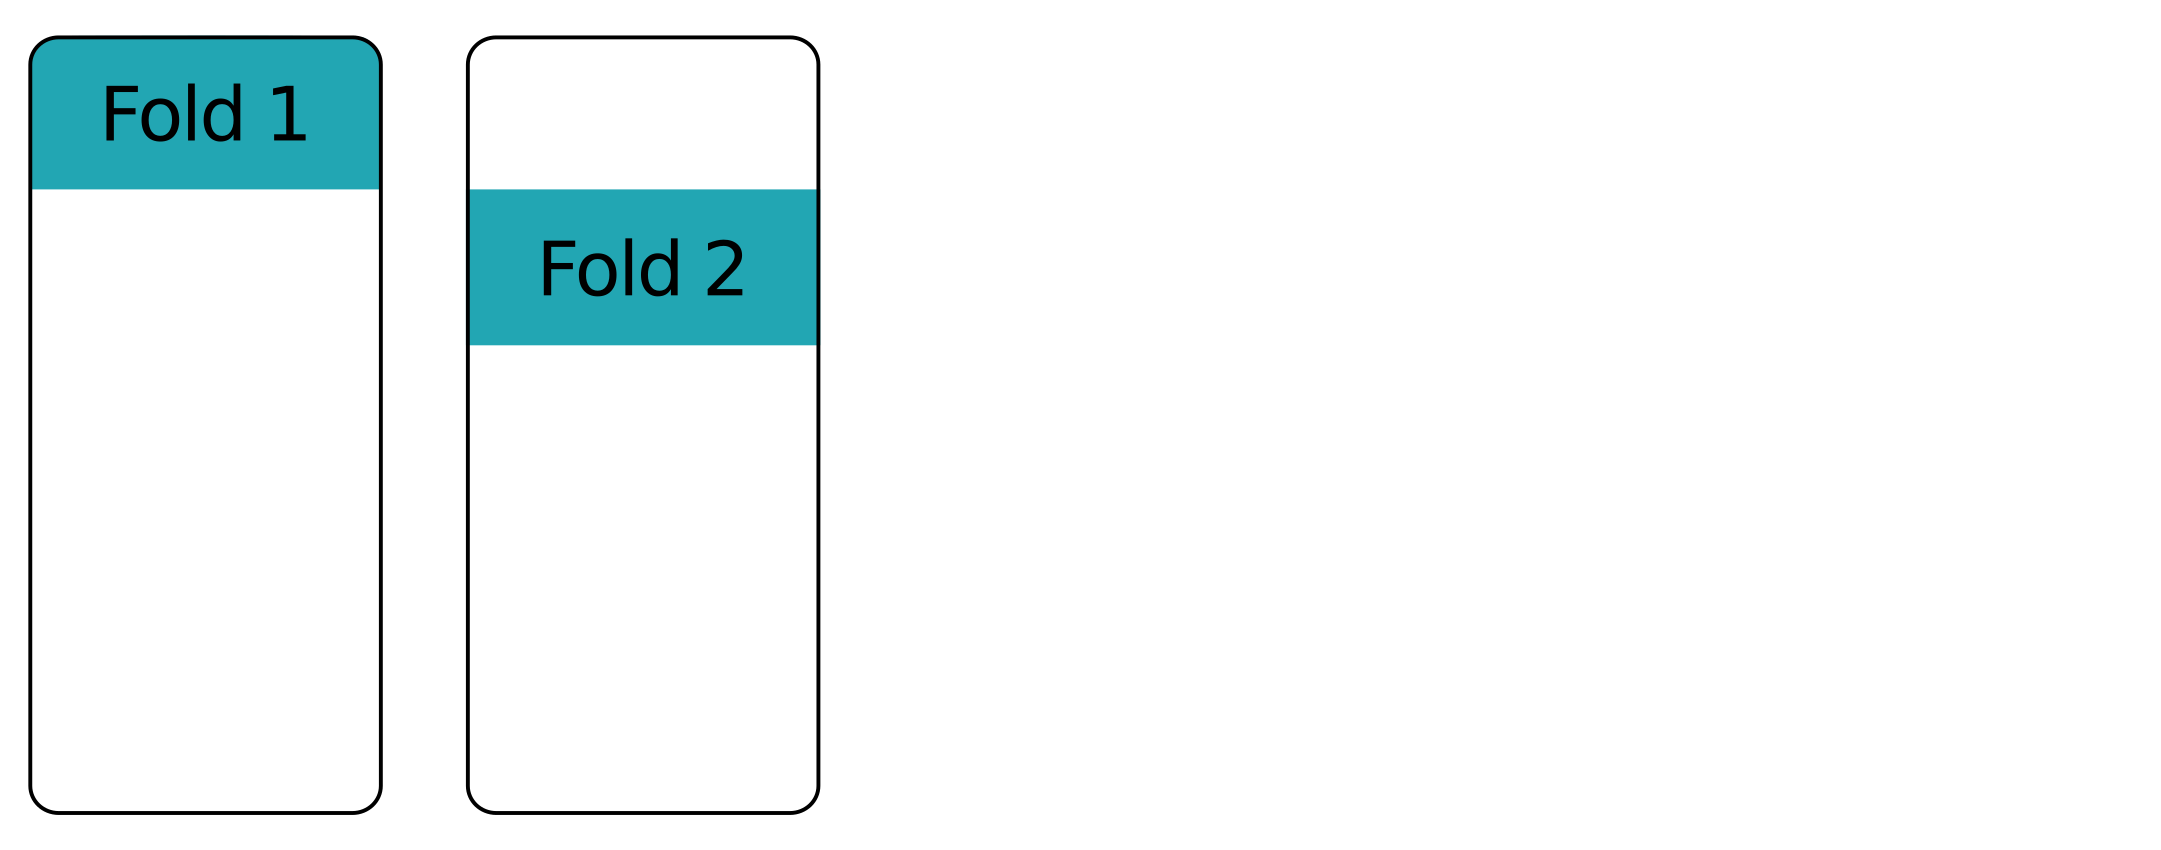Machine learning com PySpark
Andrew Collier
Data Scientist, Fathom Data


cars.select('mass', 'cyl', 'consumption').show(5)
+------+---+-----------+
| mass|cyl|consumption|
+------+---+-----------+
|1451.0| 6| 9.05|
|1129.0| 4| 6.53|
|1399.0| 4| 7.84|
|1147.0| 4| 7.84|
|1111.0| 4| 9.05|
+------+---+-----------+
Um objeto para criar o modelo. Pode ser um pipeline.
regression = LinearRegression(labelCol='consumption')
Um objeto para avaliar o desempenho do modelo.
evaluator = RegressionEvaluator(labelCol='consumption')
from pyspark.ml.tuning import CrossValidator, ParamGridBuilder
Uma grade de valores de parâmetros (por enquanto vazia).
params = ParamGridBuilder().build()
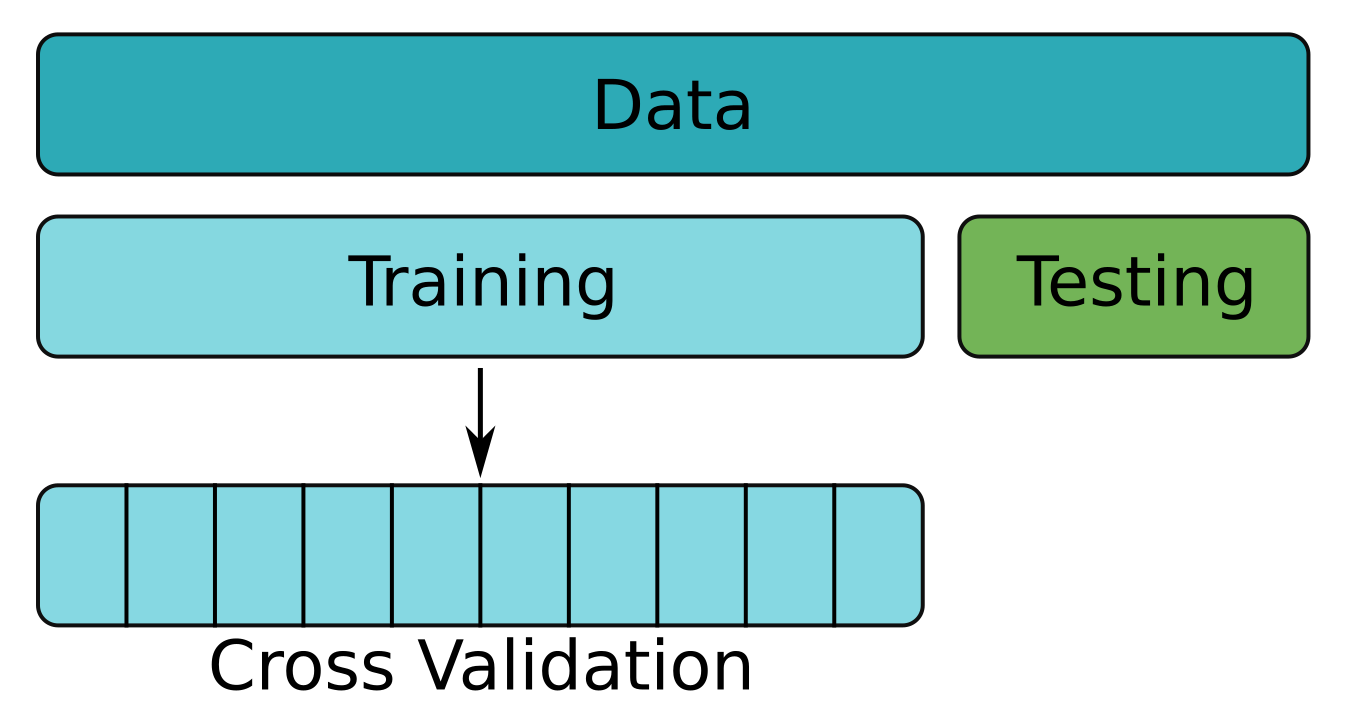
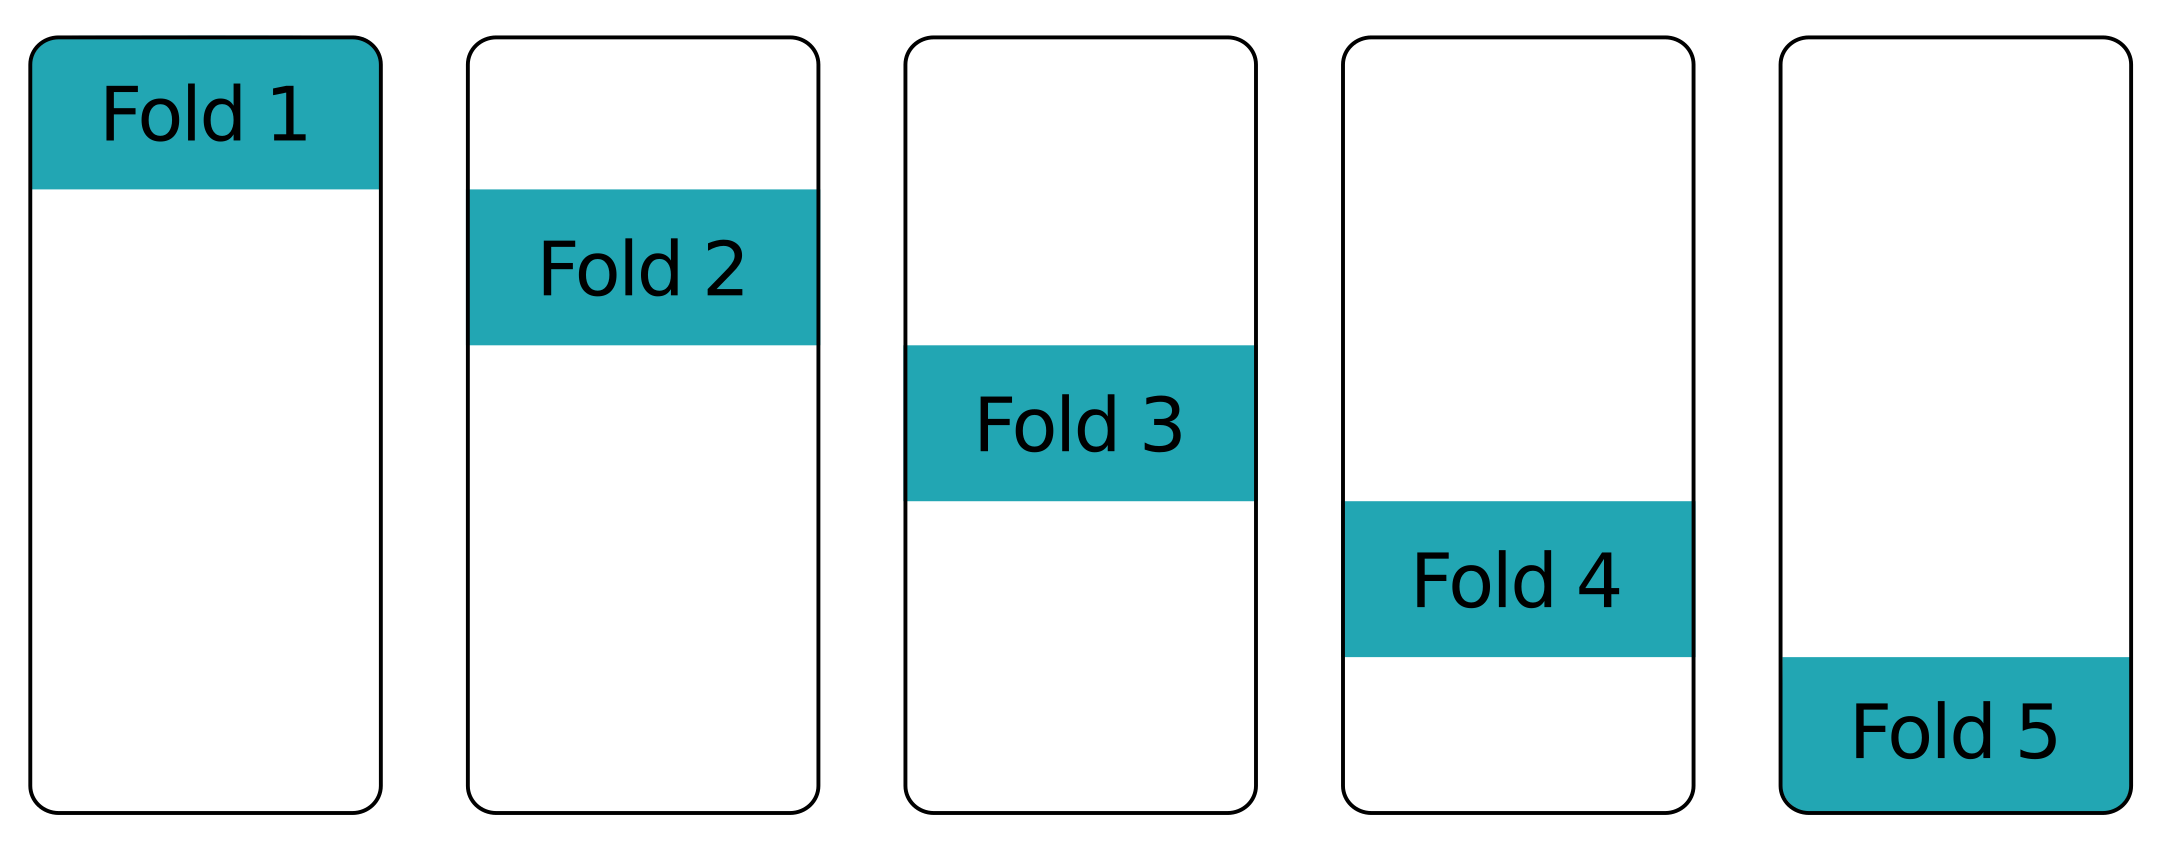
O objeto de validação cruzada.
cv = CrossValidator(estimator=regression,
estimatorParamMaps=params,
evaluator=evaluator,
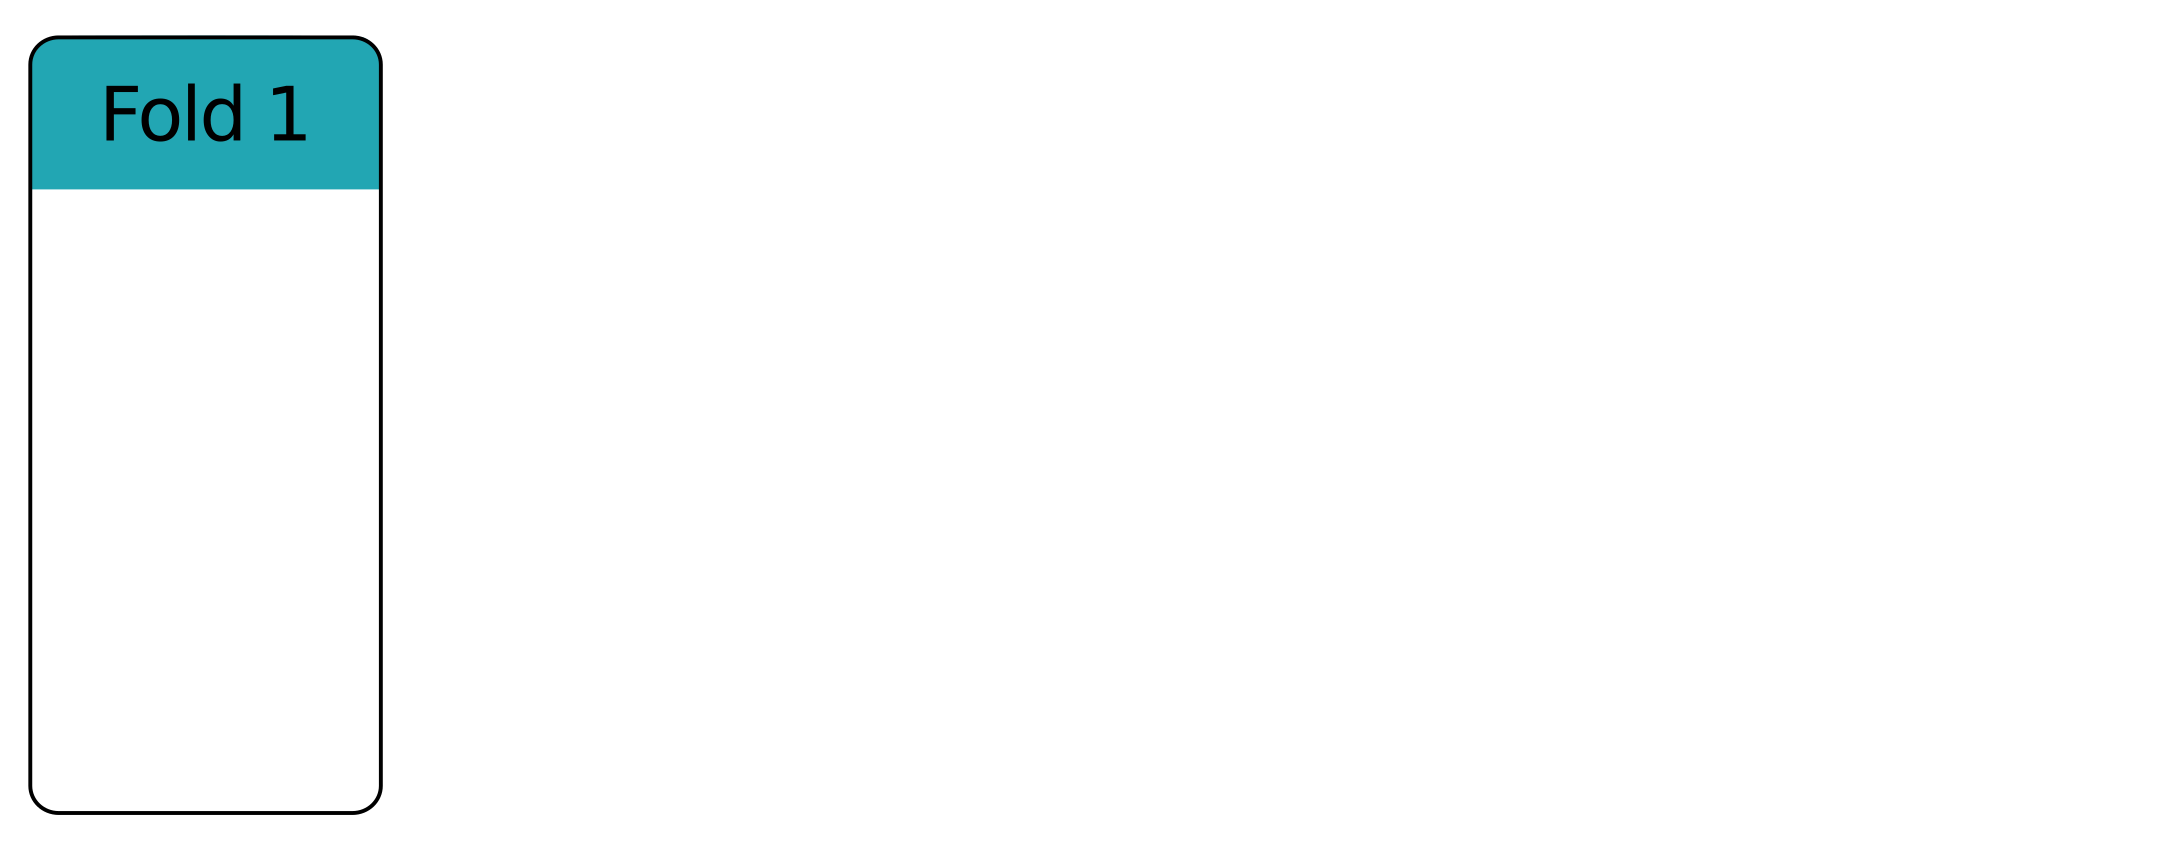
numFolds=10, seed=13)
Aplique validação cruzada aos dados de treino.
cv = cv.fit(cars_train)
Qual é o RMSE médio entre os folds?
cv.avgMetrics
[0.800663722151572]
Faça previsões nos dados de teste originais.
evaluator.evaluate(cv.transform(cars_test))
# RMSE nos dados de teste
0.745974203928479
Bem menor que o RMSE da validação cruzada.
# RMSE da validação cruzada
0.800663722151572
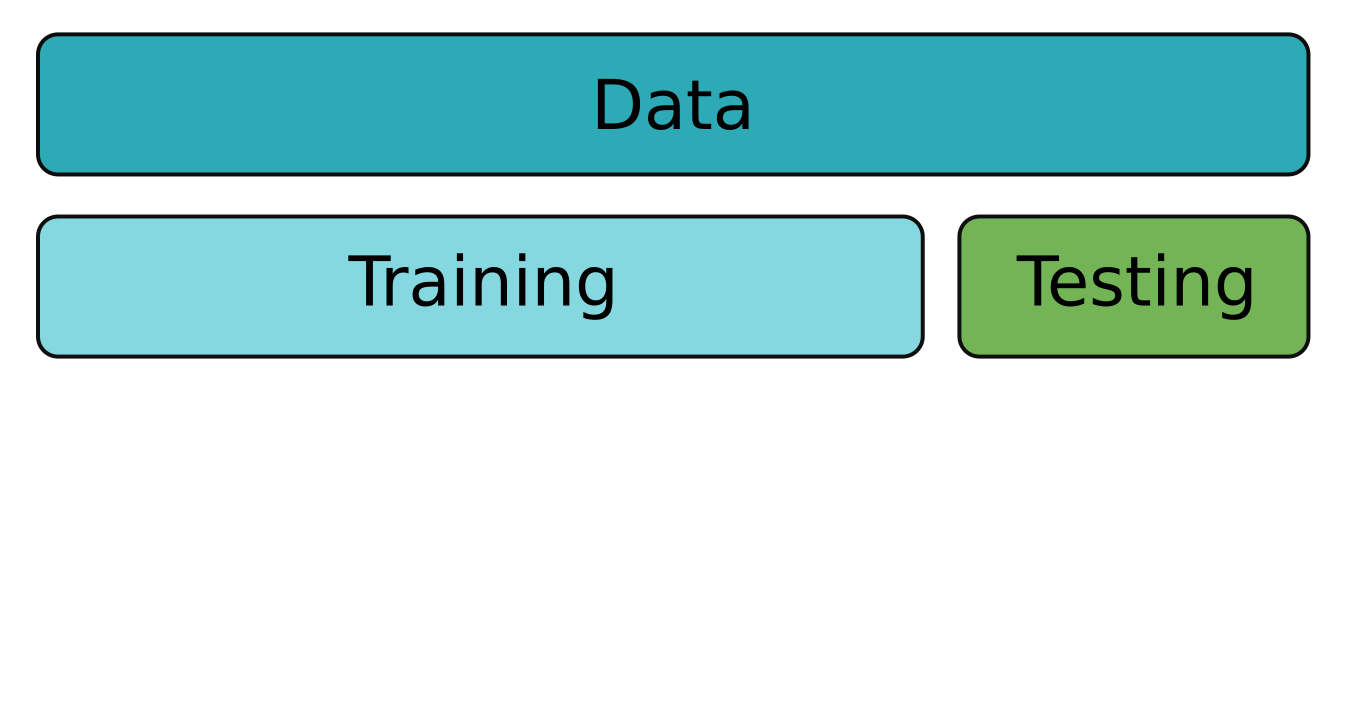
Uma simples divisão treino-teste daria uma visão otimista demais do desempenho do modelo.
Machine learning com PySpark