Estimativa Paramétrica

Gerenciamento Quantitativo de Risco em Python

Jamsheed Shorish

Computational Economist

Uma classe de distribuições

  • Distribuição de perdas: não conhecida com certeza
  • Classe de distribuições possíveis?
    • Suponha classe de distribuições $f(x; \theta)$
    • $x$ é a perda (variável aleatória)
    • $\theta$ é um vetor de parâmetros desconhecidos
  • Exemplo: distribuição Normal
    • Parâmetros: $\theta = (\mu, \sigma)$, média $\mu$ e desvio padrão $\sigma$
  • Estimativa paramétrica: encontrar $\theta^\star$ "melhor" dado os dados
  • Distribuição de perdas: $f(x,\theta^\star)$
Gerenciamento Quantitativo de Risco em Python

Ajuste de uma distribuição

  • Ajuste a distribuição segundo critérios que minimizam o erro
    • Exemplo: scipy.stats.norm.fit(), ajusta a Normal aos dados
      • Resultado: média e desvio padrão ajustados de forma ótima
  • Vantagens:
    • Dá para visualizar a diferença entre dados e estimativa com histograma
    • Pode fornecer testes de aderência (goodness-of-fit)
Gerenciamento Quantitativo de Risco em Python

Qualidade do ajuste

  • Quão bem a distribuição estimada se ajusta aos dados?
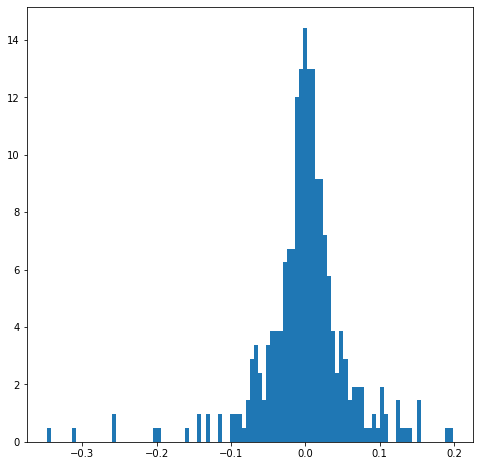
  • Visualize: plote o histograma das perdas da carteira

imagem de histograma de perdas

Gerenciamento Quantitativo de Risco em Python

Qualidade do ajuste

  • Quão bem a distribuição estimada se ajusta aos dados?
  • Visualize: plote o histograma das perdas da carteira
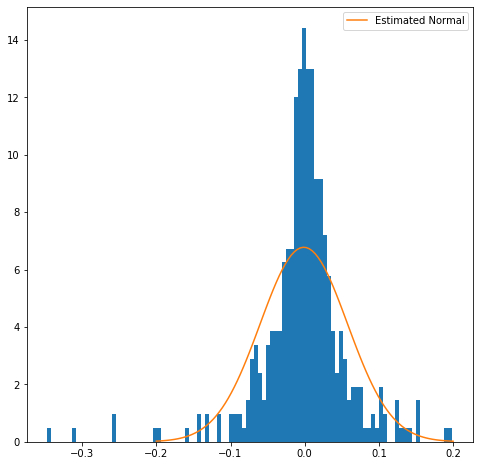
  • Distribuição Normal com norm.fit()

imagem de histograma de perdas com distribuição normal

Gerenciamento Quantitativo de Risco em Python

Qualidade do ajuste

  • Quão bem a distribuição estimada se ajusta aos dados?
  • Visualize: plote o histograma das perdas da carteira
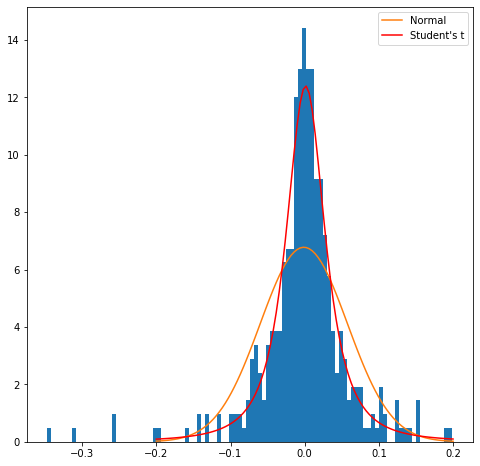
  • Exemplo:
    • Distribuição Normal com norm.fit()
    • Distribuição t de Student com t.fit()
    • Histograma assimétrico?

imagem de histograma de perdas com distribuição normal

Gerenciamento Quantitativo de Risco em Python

Teste de Anderson-Darling

  • Teste estatístico de qualidade do ajuste
    • Testa a hipótese nula: dados são Normais
    • A estatística rejeita a Normal se maior que critical_values
  • Importe scipy.stats.anderson
  • Calcule o resultado do teste usando os dados loss
from scipy.stats import anderson

anderson(loss)
AndersonResult(statistic=11.048641503898523,
critical_values=array([0.57 , 0.649, 0.779, 0.909, 1.081]),
significance_level=array([15. , 10. ,  5. ,  2.5,  1. ]))
Gerenciamento Quantitativo de Risco em Python

Assimetria

  • Assimetria: grau em que os dados não são distribuídos simetricamente
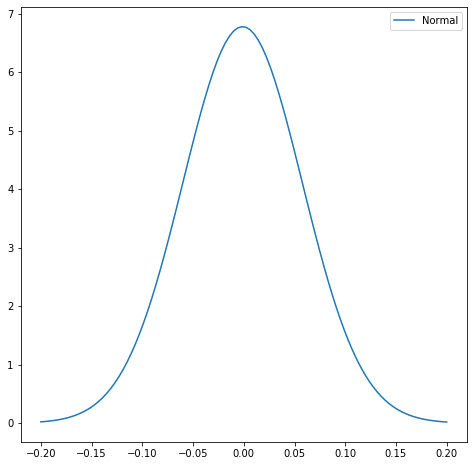
    • Distribuição Normal: simétrica

distribuição normal

Gerenciamento Quantitativo de Risco em Python

Assimetria

  • Assimetria: grau em que os dados não são distribuídos simetricamente
    • Distribuição Normal: simétrica
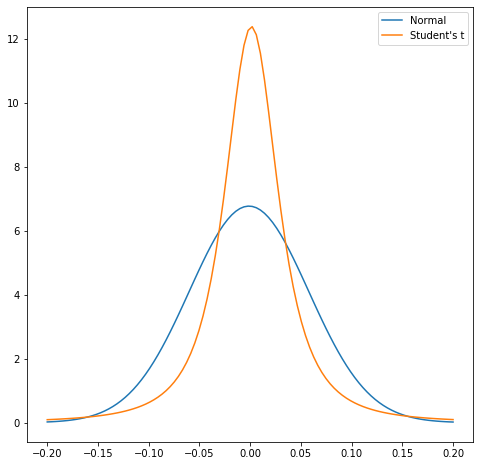
    • Distribuição t de Student: simétrica

distribuições normal e t

Gerenciamento Quantitativo de Risco em Python

Assimetria

  • Assimetria: grau em que os dados não são distribuídos simetricamente
    • Distribuição Normal: simétrica
    • Distribuição t de Student: simétrica
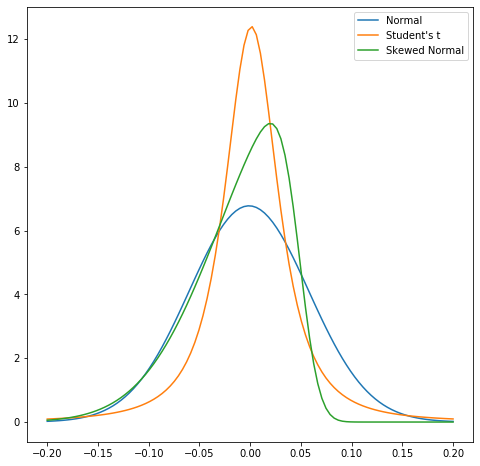
  • Distribuição Normal assimétrica: assimétrica
    • Contém a Normal como caso especial
    • Útil para dados de carteira, em que, por ex., perdas são mais frequentes que ganhos
    • Disponível em scipy.stats como skewnorm

distribuições normal, t e normal assimétrica

Gerenciamento Quantitativo de Risco em Python

Testando a assimetria

  • Teste o quão longe os dados estão de uma distribuição simétrica: scipy.stats.skewtest
  • Hipótese nula: sem assimetria
  • Importe skewtest de scipy.stats
  • Calcule o resultado do teste nos dados loss
    • Significativo estatisticamente => use classe de distribuição com assimetria
from scipy.stats import skewtest

skewtest(loss)
SkewtestResult(statistic=-7.786120875514511,
pvalue=6.90978472959861e-15)
Gerenciamento Quantitativo de Risco em Python

Vamos praticar!

Gerenciamento Quantitativo de Risco em Python

Preparing Video For Download...