Configuração dos dados experimentais

Projeto experimental em Python

James Chapman

Curriculum Manager, DataCamp

O problema da randomização
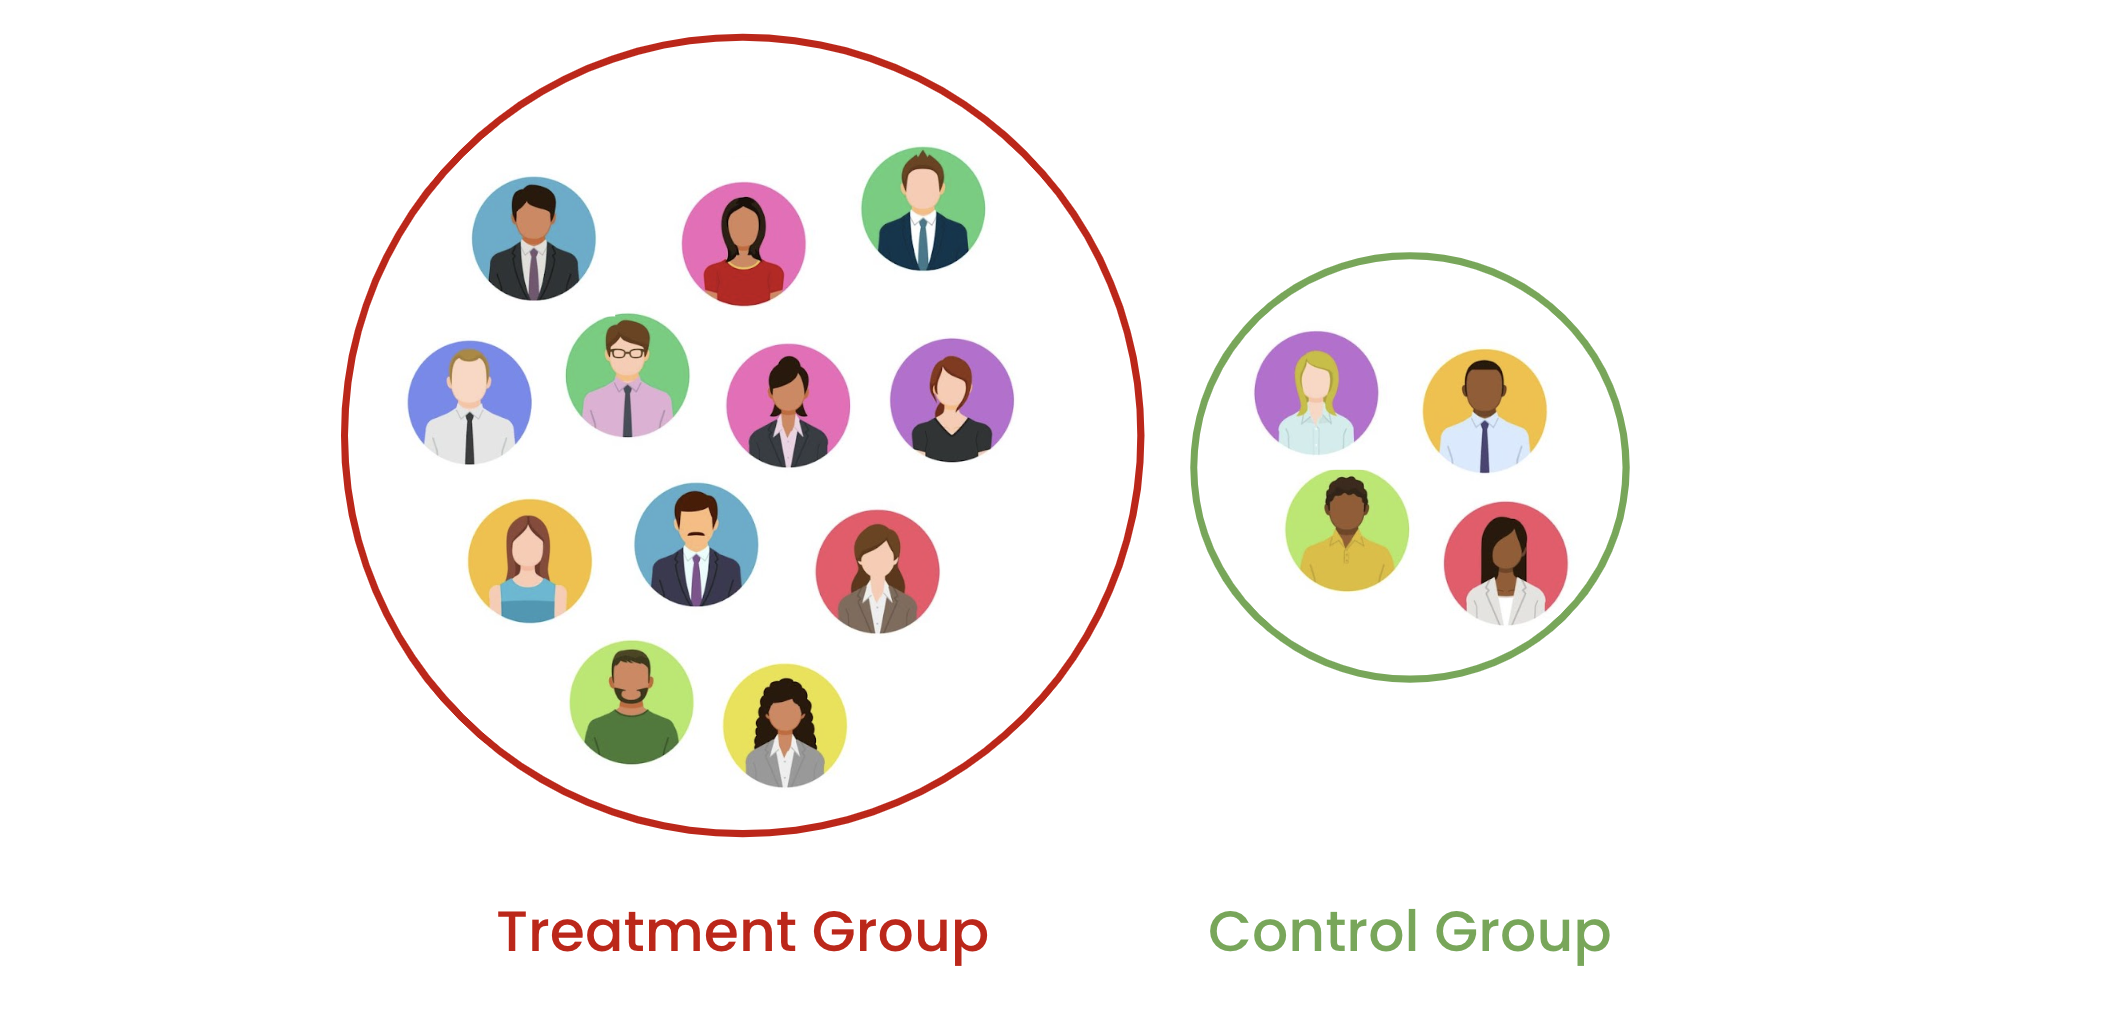
1) Problema de desequilíbrio: números diferentes por grupo

Dois grupos com quantidades diferentes de participantes.

Projeto experimental em Python

O problema da randomização

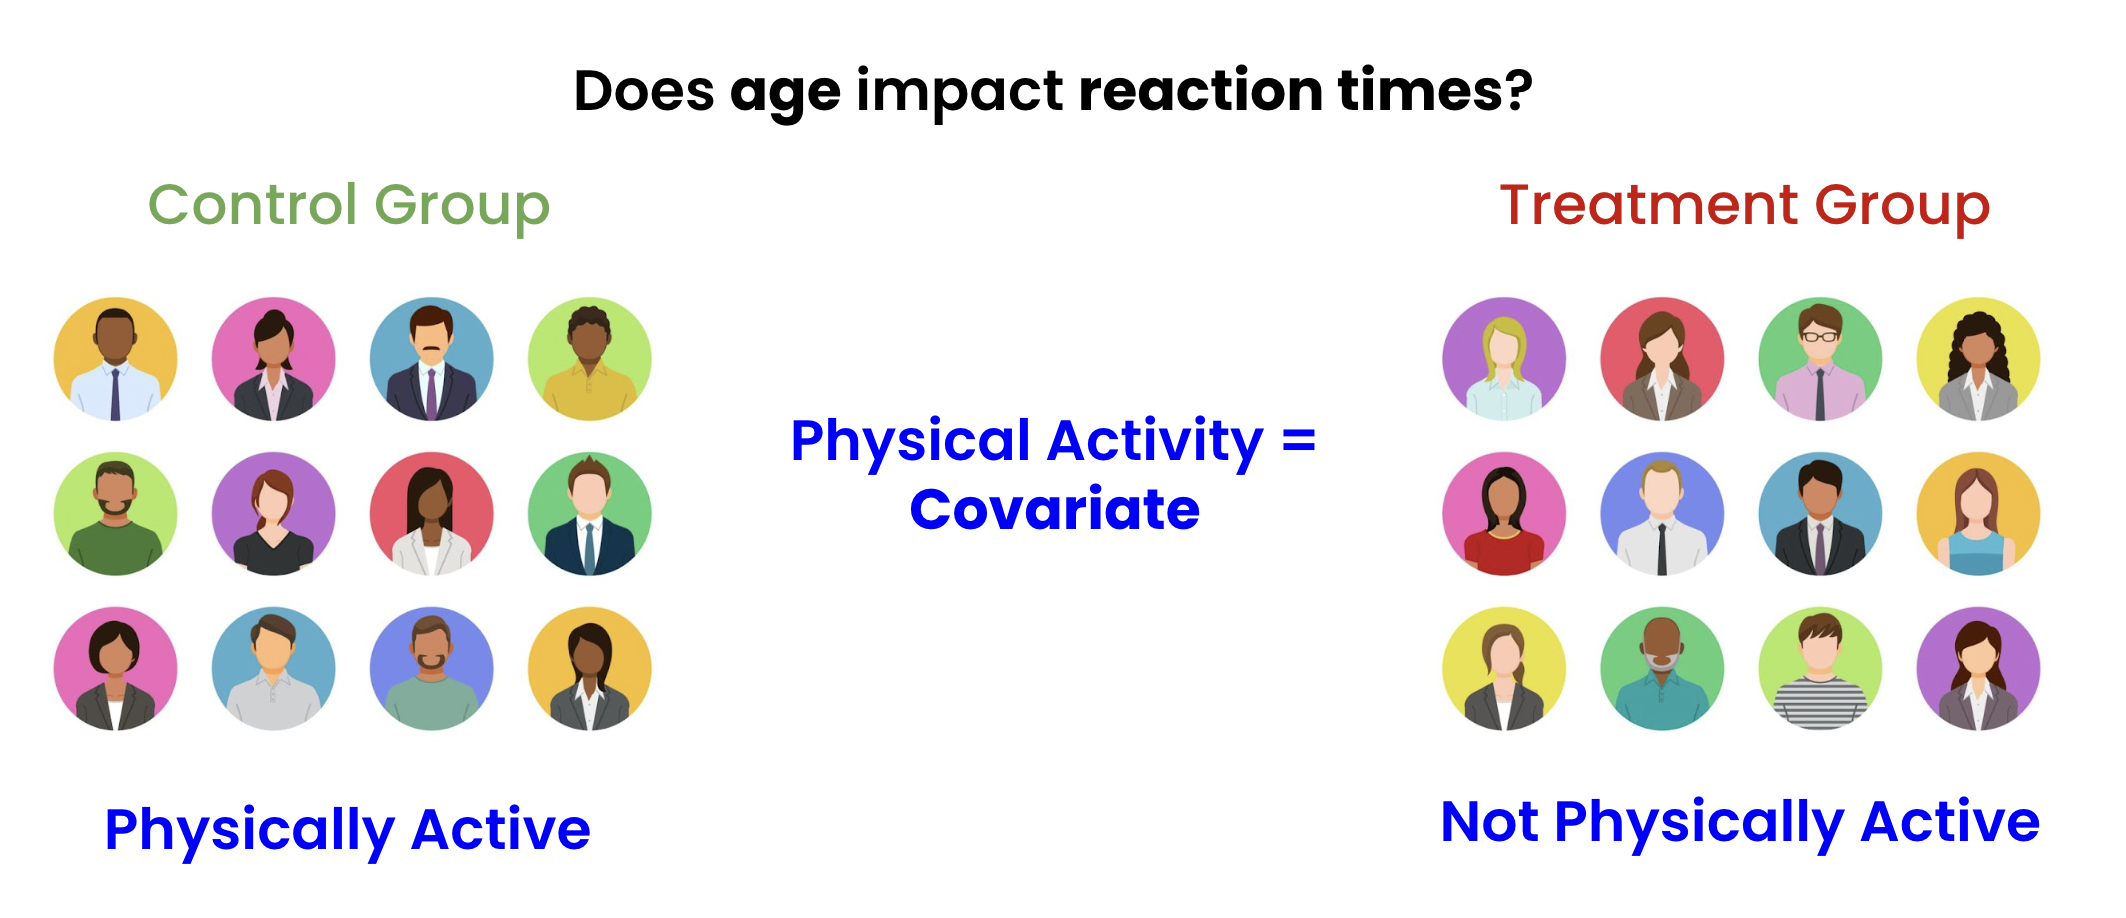
2) Problema de covariável: alta variabilidade em algumas covariáveis → desequilíbrios na randomização

Grupos de controle e tratamento para medir o impacto da idade no tempo de reação. Os grupos têm distribuição desigual de condicionamento físico, que não é o foco do experimento, mas pode afetar o tempo de reação.

Resultado: mais difícil medir o efeito do tratamento!

Projeto experimental em Python

Randomização por blocos


  • Dividir em blocos de tamanho $n$ primeiro e depois randomizar
    • Corrige o desequilíbrio

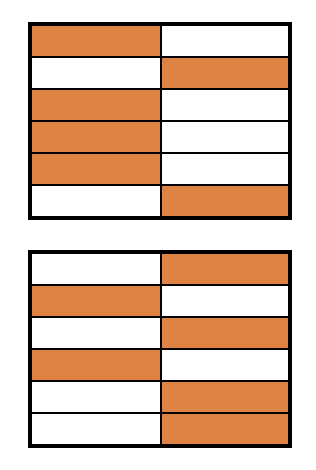
Exemplo de randomização por blocos com duas grades de quadrados laranja e brancos

  • 24 participantes divididos em dois grupos e depois randomizados
Projeto experimental em Python

Nosso dataset

  • Dataset de e-commerce (ecom) (1000 participantes)
    • Tamanho médio do carrinho
    • Tempo médio no site
    • Usuário avançado (média de 40+ min/dia no site)
   basket_size  web_time  power_user
0          227         7           0
1          123         5           0
2           98        16           0
3          211        45           1
4          133        17           0
Projeto experimental em Python

Randomização por blocos em Python

group1 = ecom.sample(frac=0.5, random_state=42, replace=False)
group1['Block'] = 1
group2 = ecom.drop(group1.index)
group2['Block'] = 2
print(len(group1), len(group2))
500,500
Projeto experimental em Python

Visualizando divisões


import seaborn as sns
import matplotlib.pyplot as plt
sns.displot(data=ecom, 
            x='basket_size', 
            hue='power_user', 
            fill=True, 
            kind='kde')    
plt.show()

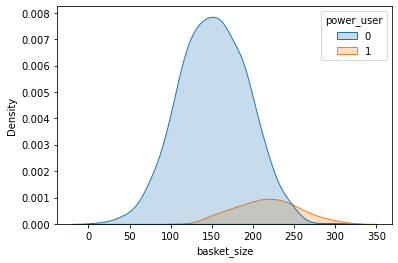
Confundimento = variável que pode causar o efeito em vez do tratamento


Um gráfico de distribuição do seaborn com duas distribuições quase normais e semitransparentes: uma azul maior e uma laranja menor, levemente sobrepostas, com a laranja mais à direita

Projeto experimental em Python

Randomização estratificada


  • Dividir com base em covariáveis primeiro
    • Depois randomizar
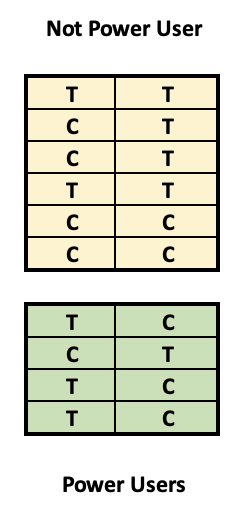
  • Verde = Todos usuários avançados (Amarelo = Não avançados)
    • Depois dividir Tratamento/Controle
  • Corrige problema de covariável/confundimento
  • Pode usar várias covariáveis — mas fica complexo!

Imagem com duas grades de dados, uma verde e outra amarela. Ambas têm T ou C em todas as células, e a grade amarela é maior

Projeto experimental em Python

Nosso primeiro estrato

  • Separar usuários avançados
  • Amostrar em Tratamento/Controle
strata_1 = ecom[ecom['power_user'] == 1]
strata_1['Block'] = 1

strata_1_g1 = strata_1.sample(frac=0.5, replace=False) strata_1_g1['T_C'] = 'T'
strata_1_g2 = strata_1.drop(strata_1_g1.index) strata_1_g2['T_C'] = 'C'
Projeto experimental em Python

O segundo estrato

  • Separar não avançados
  • Amostrar em Tratamento/Controle
strata_2 = ecom.drop(strata_1.index)
strata_2['Block'] = 2

strata_2_g1 = strata_2.sample(frac=0.5, replace=False) strata_2_g1['T_C'] = 'T' strata_2_g2 = strata_2.drop(strata_2_g1.index) strata_2_g2['T_C'] = 'C'
Projeto experimental em Python

Confirmando a estratificação

  • Juntar blocos e grupos
  • Usar groupby para checar a alocação
ecom_stratified = pd.concat([strata_1_g1, strata_1_g2, strata_2_g1, strata_2_g2])

ecom_stratified.groupby(['Block','T_C', 'power_user']).size()
Block  T_C  power_user
1      C    1              50
       T    1              50
2      C    0             450
       T    0             450
Projeto experimental em Python

Vamos praticar!

Projeto experimental em Python

Preparing Video For Download...