Explicando modelos não supervisionados

IA explicável em Python

Fouad Trad

Machine Learning Engineer

Clustering

Agrupe pontos parecidos sem rótulos prévios
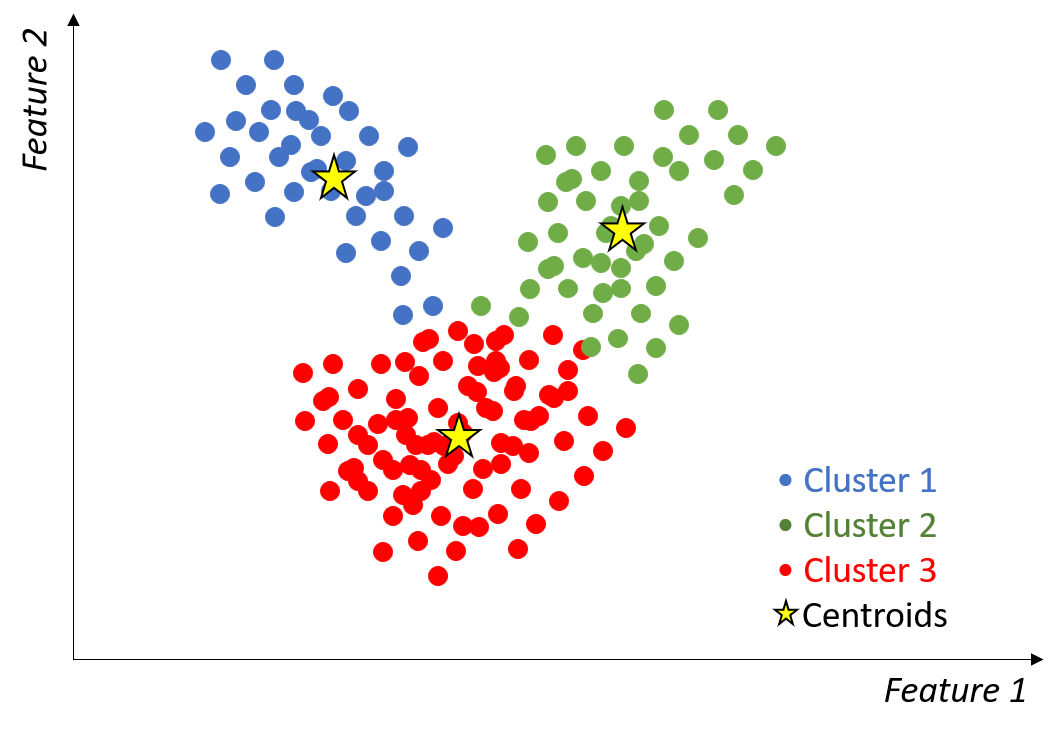
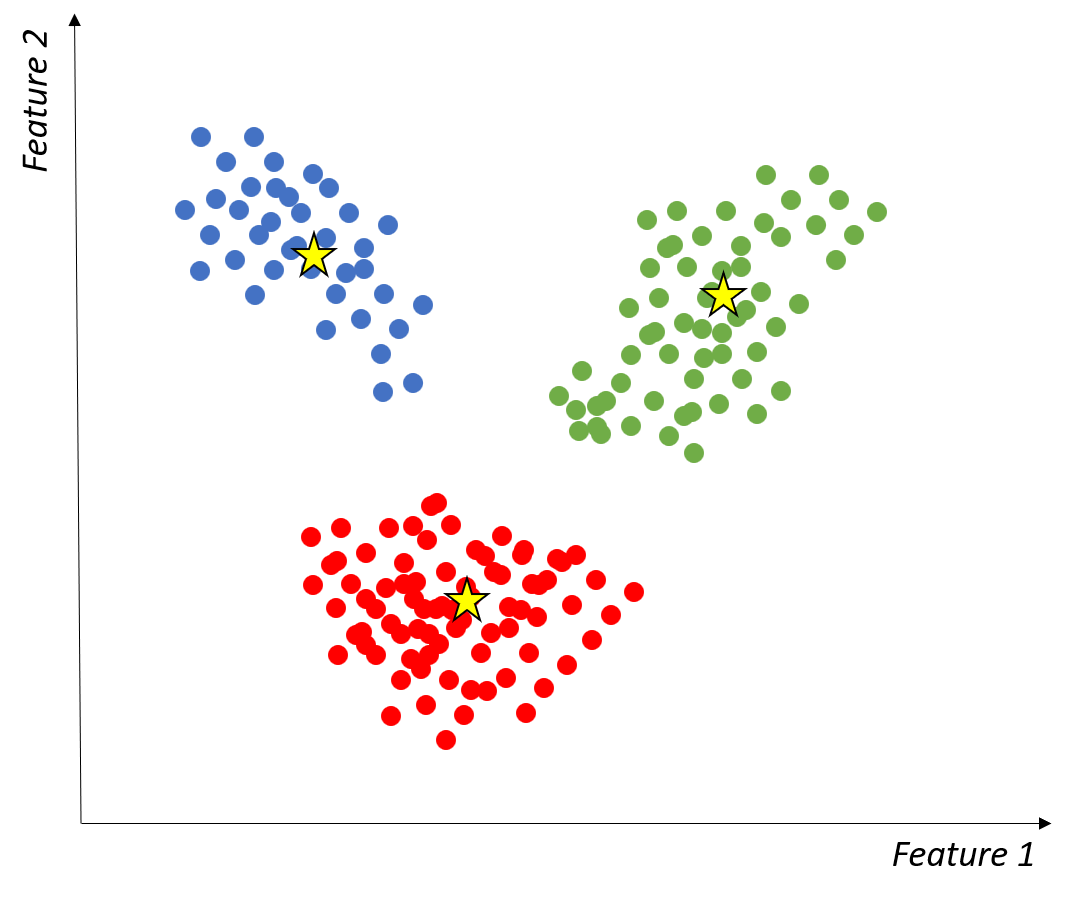
Imagem mostrando dados com 2 features divididos em 3 clusters, cada um com um centróide.

IA explicável em Python

Silhouette score

  • Mede a qualidade do clustering
  • Varia de -1 a 1
    • 1 → clusters bem separados

Imagem mostrando clusters bem separados.

IA explicável em Python

Silhouette score

  • Mede a qualidade do clustering
  • Varia de -1 a 1
    • 1 → clusters bem separados
    • -1 → pontos mal atribuídos

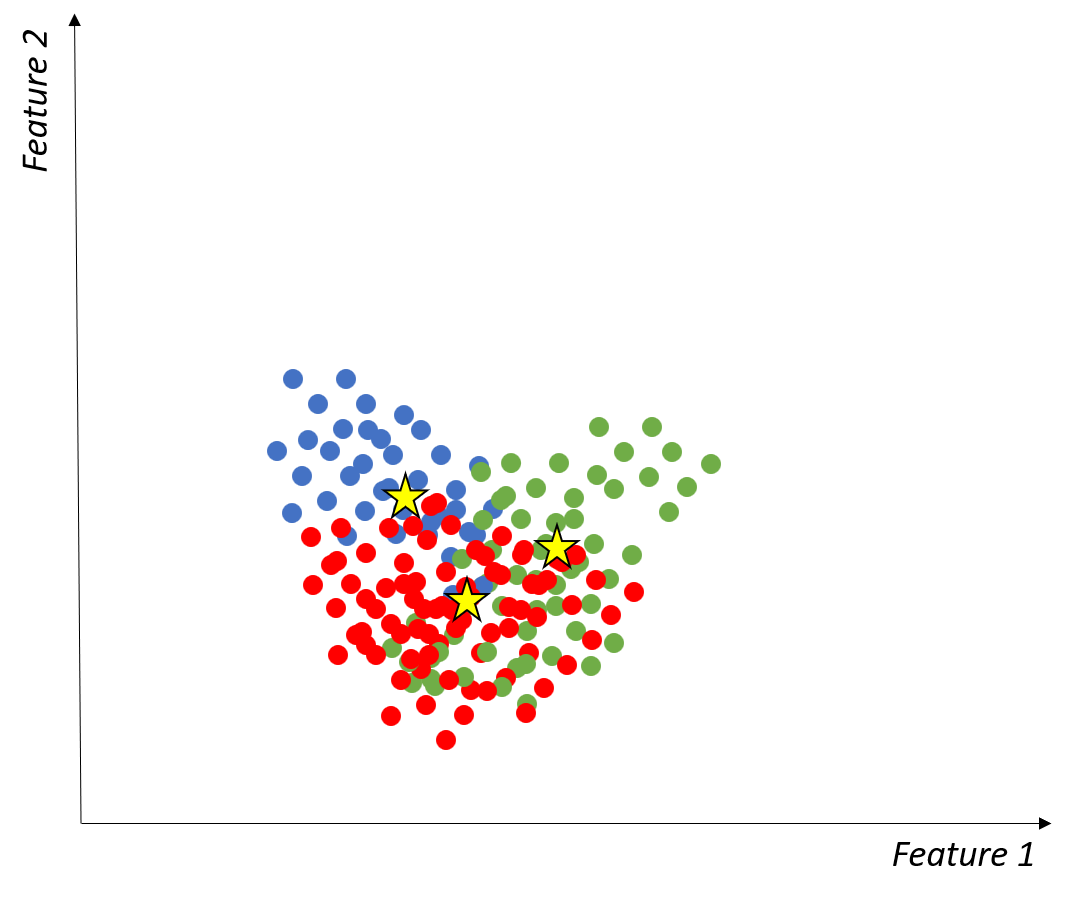
Imagem mostrando clusters sem separação clara.

IA explicável em Python

Impacto da feature na qualidade do cluster
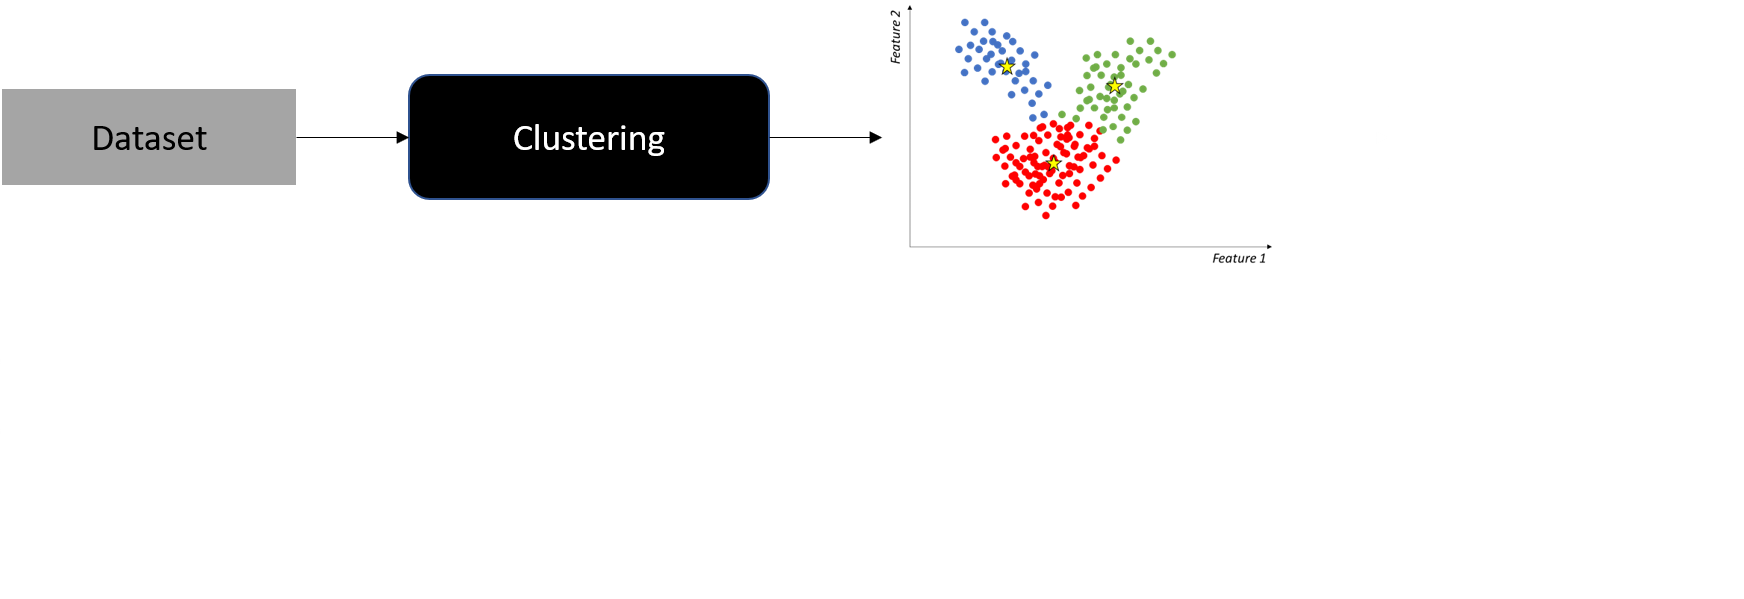
Imagem mostrando o resultado de agrupamento de um dataset com 2 features usado no algoritmo.

IA explicável em Python

Impacto da feature na qualidade do cluster
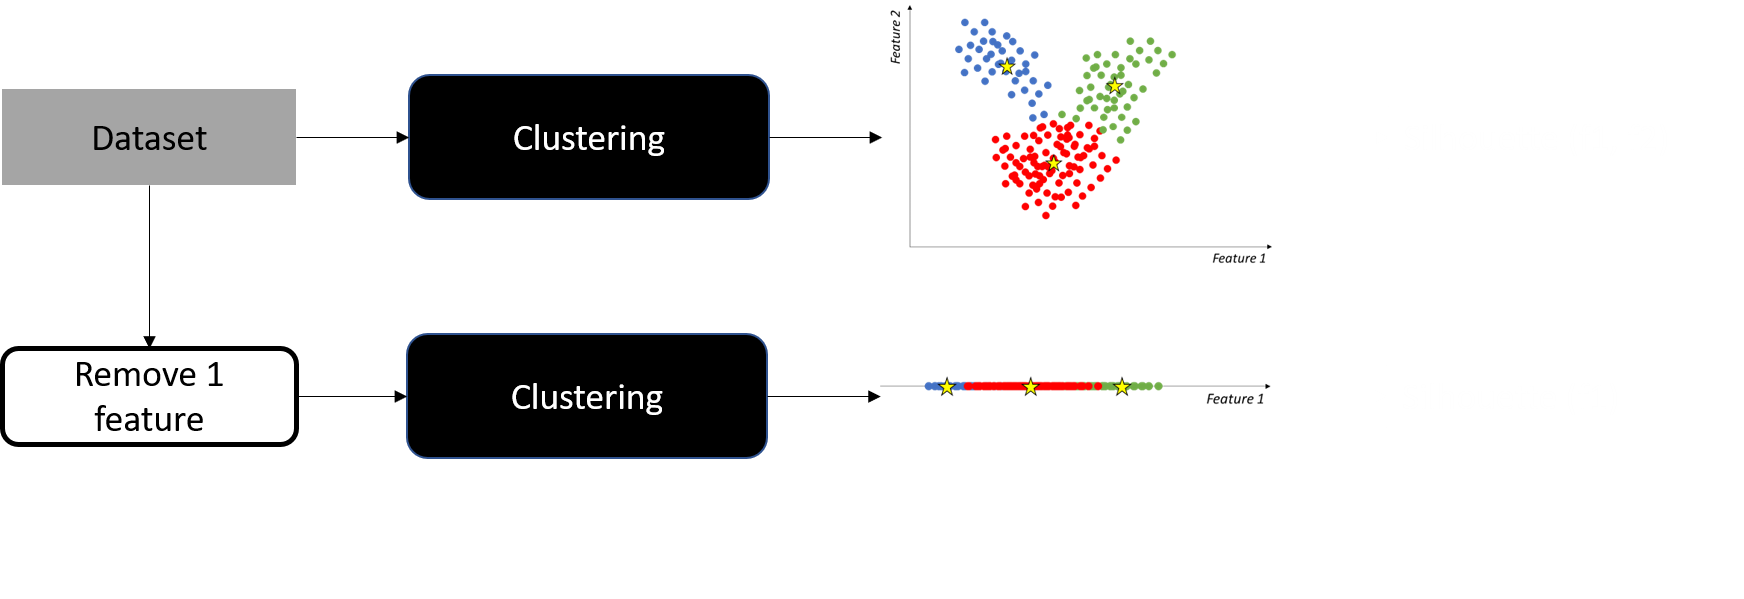
Imagem mostrando o resultado do agrupamento após remover uma feature e retreinar o modelo.

IA explicável em Python

Impacto da feature na qualidade do cluster
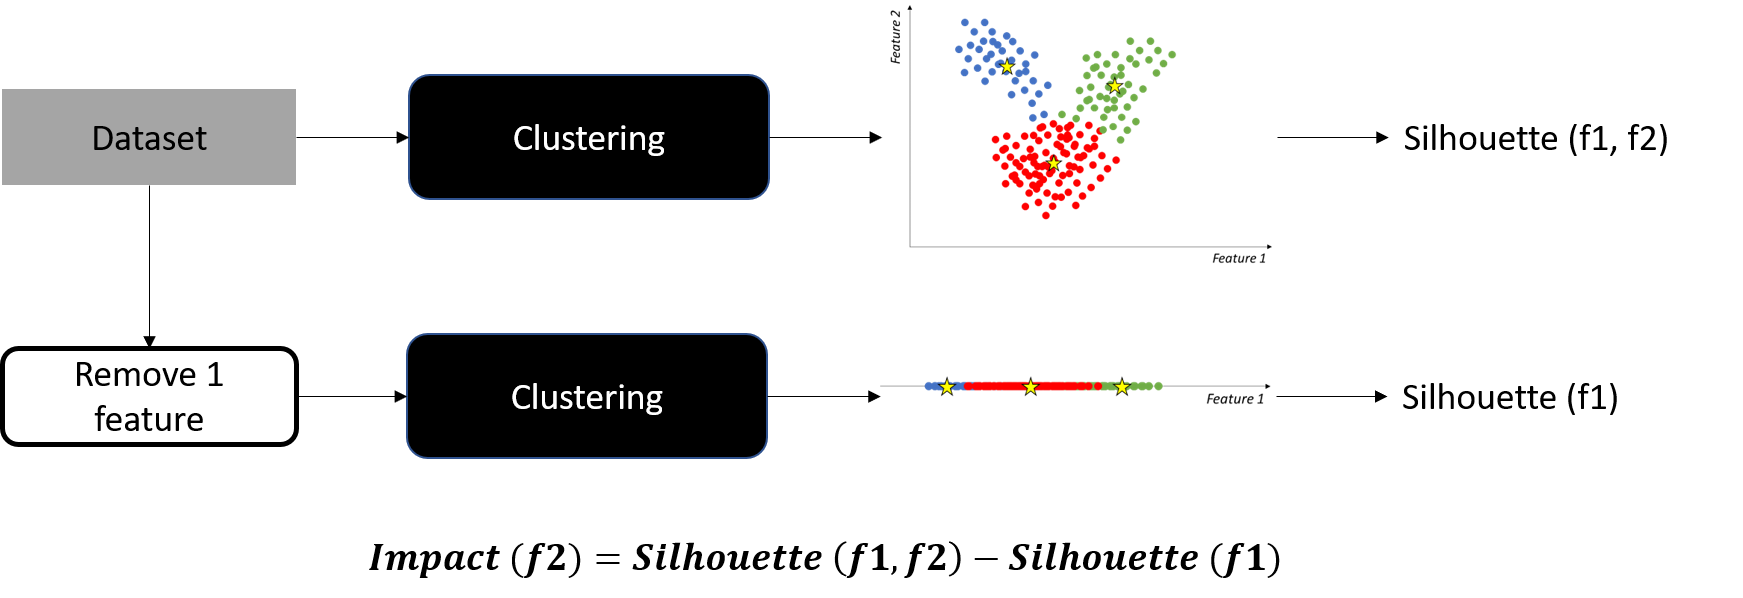
Imagem mostrando a fórmula para obter o impacto da feature removida como a diferença entre o silhouette com todas as features e o silhouette sem a feature.

  • $\text{Impacto(}f) > 0$ → contribuição positiva de $f$
  • $\text{Impacto(}f) < 0$ → $f$ adiciona ruído
IA explicável em Python

Dataset Student Performance

age health status absences G1 G2 G3
18 3 4 0 11 11
17 3 2 9 11 11
15 3 6 12 13 12
15 5 0 14 14 14
16 5 0 11 13 13


X: array com as features

IA explicável em Python

Calculando impacto da feature na qualidade do cluster

from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score


kmeans = KMeans(n_clusters=2).fit(X)
original_score = silhouette_score(X, kmeans.labels_)
for i in range(X.shape[1]):
X_reduced = np.delete(X, i, axis=1)
kmeans.fit(X_reduced)
new_score = silhouette_score(X_reduced, kmeans.labels_)
impact = original_score - new_score print(f'Feature {column_names[i]}: Impact = {impact}')
IA explicável em Python

Calculando impacto da feature na qualidade do cluster

Feature age: Impact = 0.05199181662741281
Feature health status: Impact = 0.06046737420227638
Feature absences: Impact = 0.031290940582026694
Feature G1: Impact = -0.025746421940652353
Feature G2: Impact = -0.02578292339364119
Feature G3: Impact = -0.03163419458330158
IA explicável em Python

Adjusted Rand Index (ARI)

  • Mede o quão bem os clusters batem

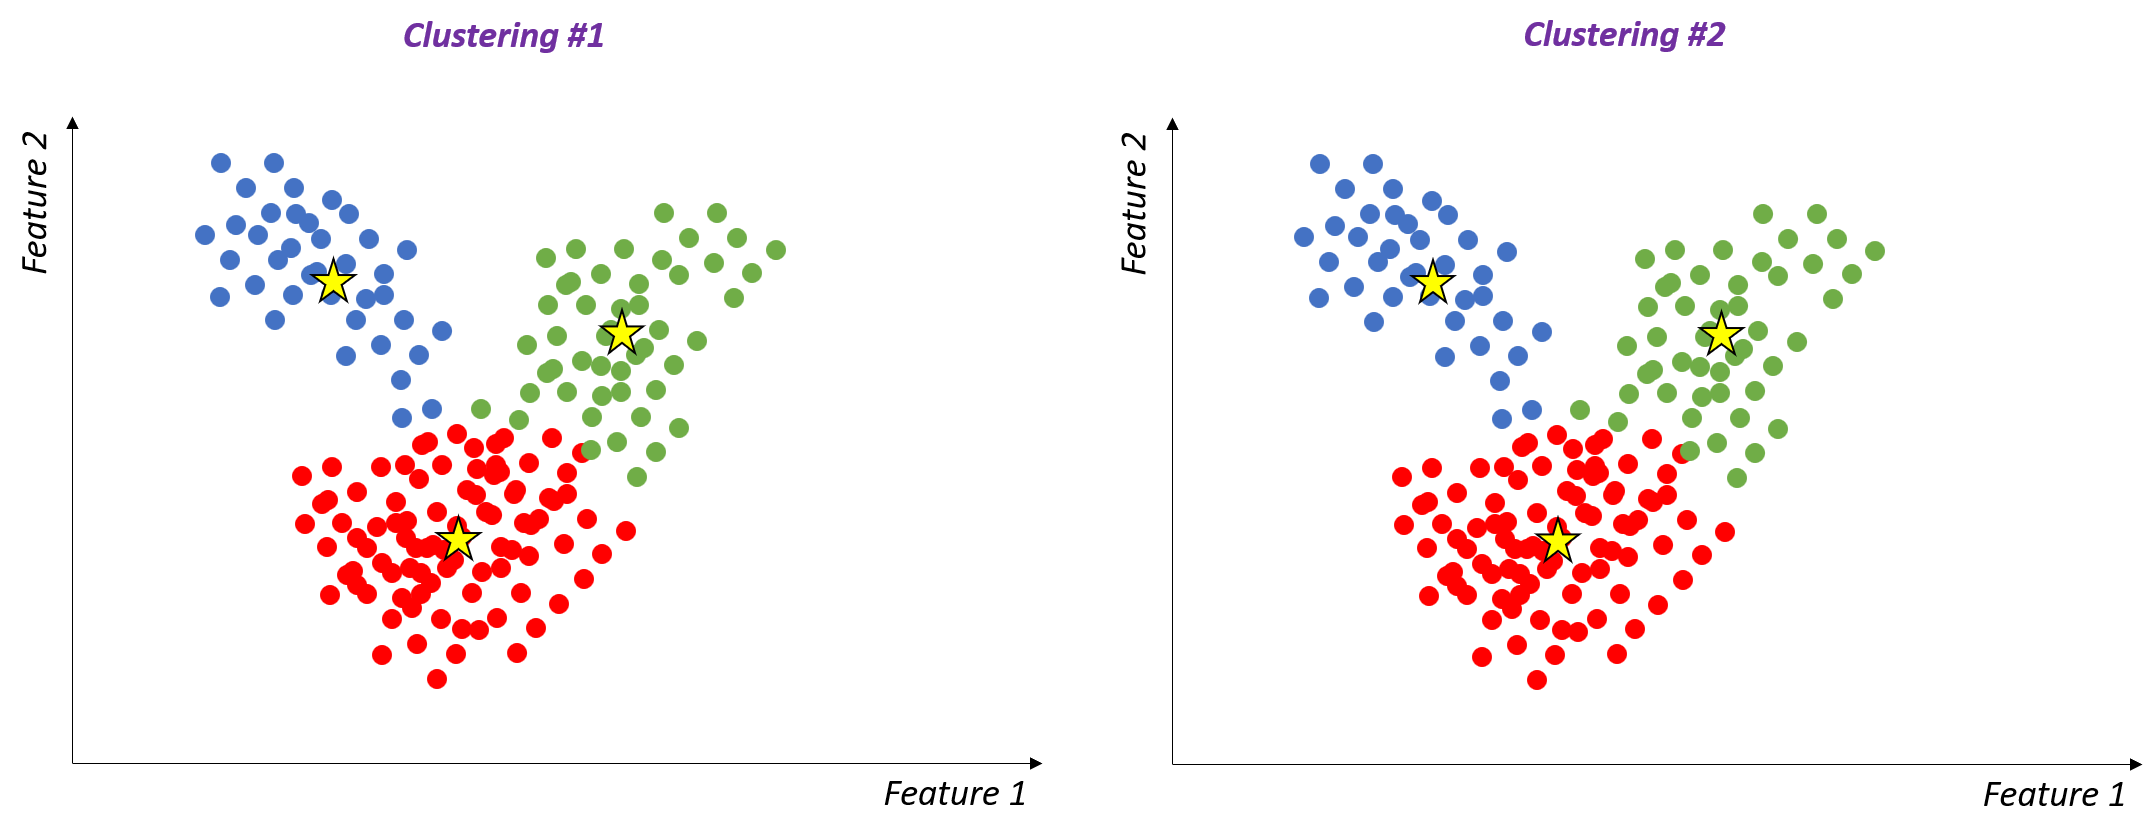
Imagem mostrando duas atribuições de cluster semelhantes para um dataset.

  • ARI máximo = 1 → alinhamento perfeito
IA explicável em Python

Adjusted Rand Index (ARI)

  • Mede o quão bem os clusters batem

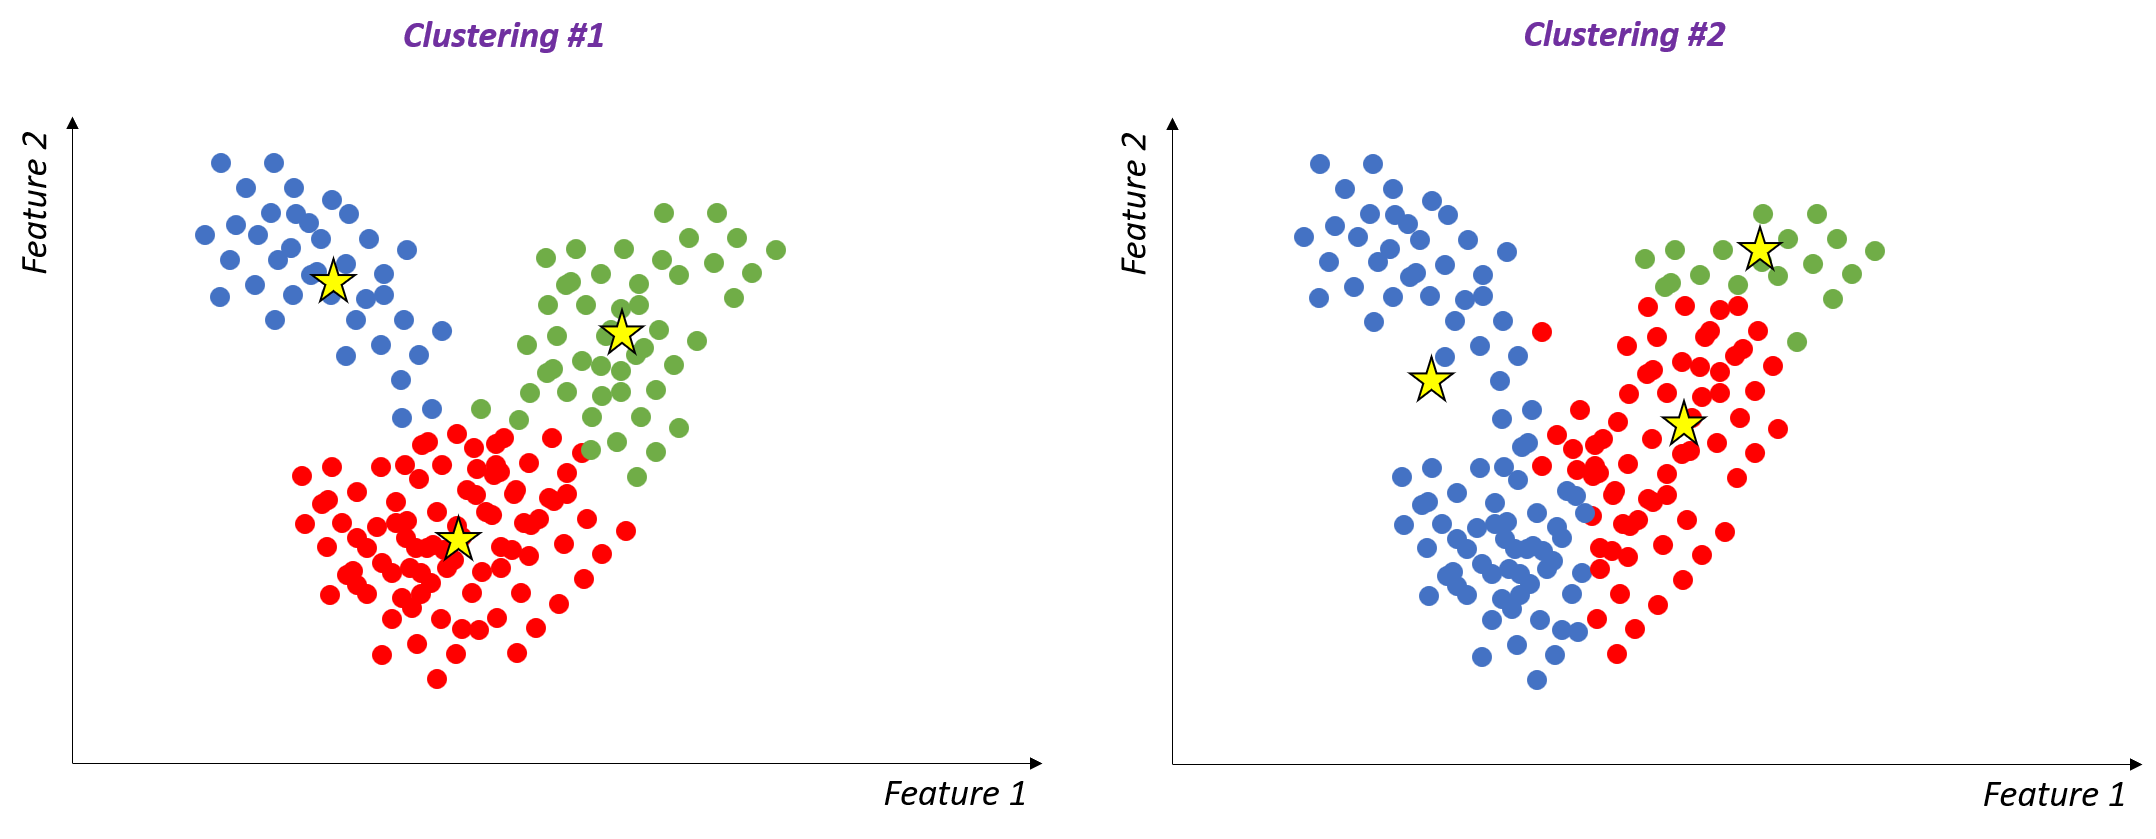
Imagem mostrando duas atribuições de cluster diferentes para o mesmo dataset.

  • ARI máximo = 1 → alinhamento perfeito
  • ARI menor → maior diferença entre clusterizações
IA explicável em Python

Importância de features para a atribuição de clusters


  • Remova uma feature por vez
  • $\text{Importância}(f) = 1 - \text{ARI (clusters originais, clusters modificados)}$
  • ARI baixo → $\text(1 - ARI)$ alto → feature importante
IA explicável em Python

Importância de features para a atribuição de cluster

from sklearn.metrics import adjusted_rand_score

kmeans = KMeans(n_clusters=2).fit(X) original_clusters = kmeans.predict(X)
for i in range(X.shape[1]):
X_reduced = np.delete(X, i, axis=1)
reduced_clusters = kmeans.fit_predict(X_reduced)
importance = 1 - adjusted_rand_score(original_clusters, reduced_clusters) print(f'{df.columns[i]}: {importance}')
age: 0.0
health status: 0.9995376368119572
absences: 0.0
G1: 0.0
G2: 0.6204069909514572
G3: 0.6204069909514572
IA explicável em Python

Vamos praticar!

IA explicável em Python

Preparing Video For Download...