Erklären von unüberwachten Modellen

Erklärbare KI in Python

Fouad Trad

Machine Learning Engineer

Clustering

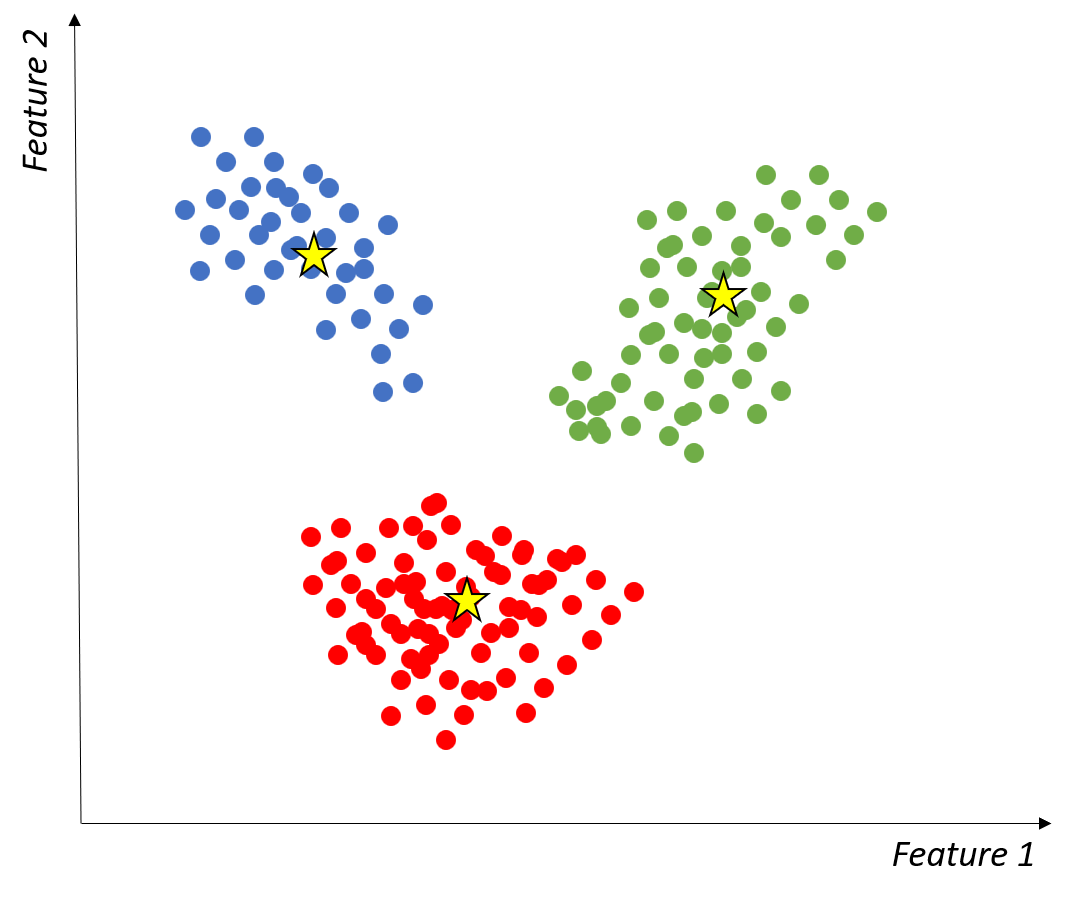
Ähnliche Datenpunkte ohne Labels gruppieren
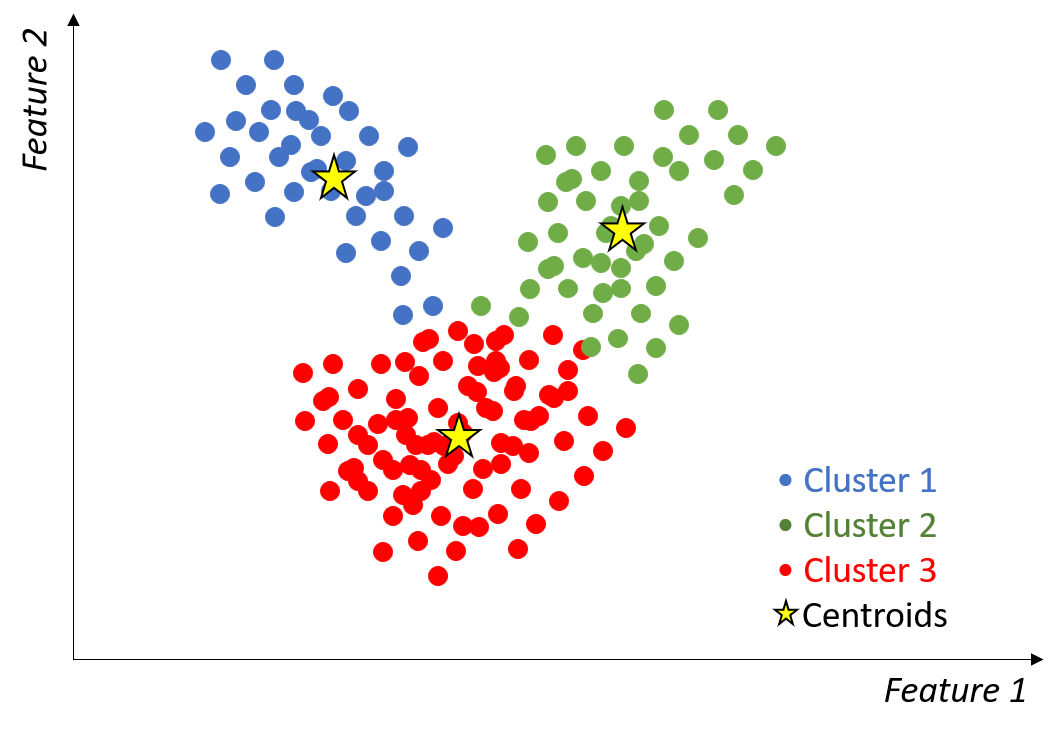
Bild mit Daten mit 2 Merkmalen, aufgeteilt in 3 Cluster mit Zentroiden.

Erklärbare KI in Python

Silhouette-Score

  • Misst die Clustering-Qualität
  • Bereich: -1 bis 1
    • 1 → gut getrennte Cluster

Bild mit gut getrennten Clustern.

Erklärbare KI in Python

Silhouette-Score

  • Misst die Clustering-Qualität
  • Bereich: -1 bis 1
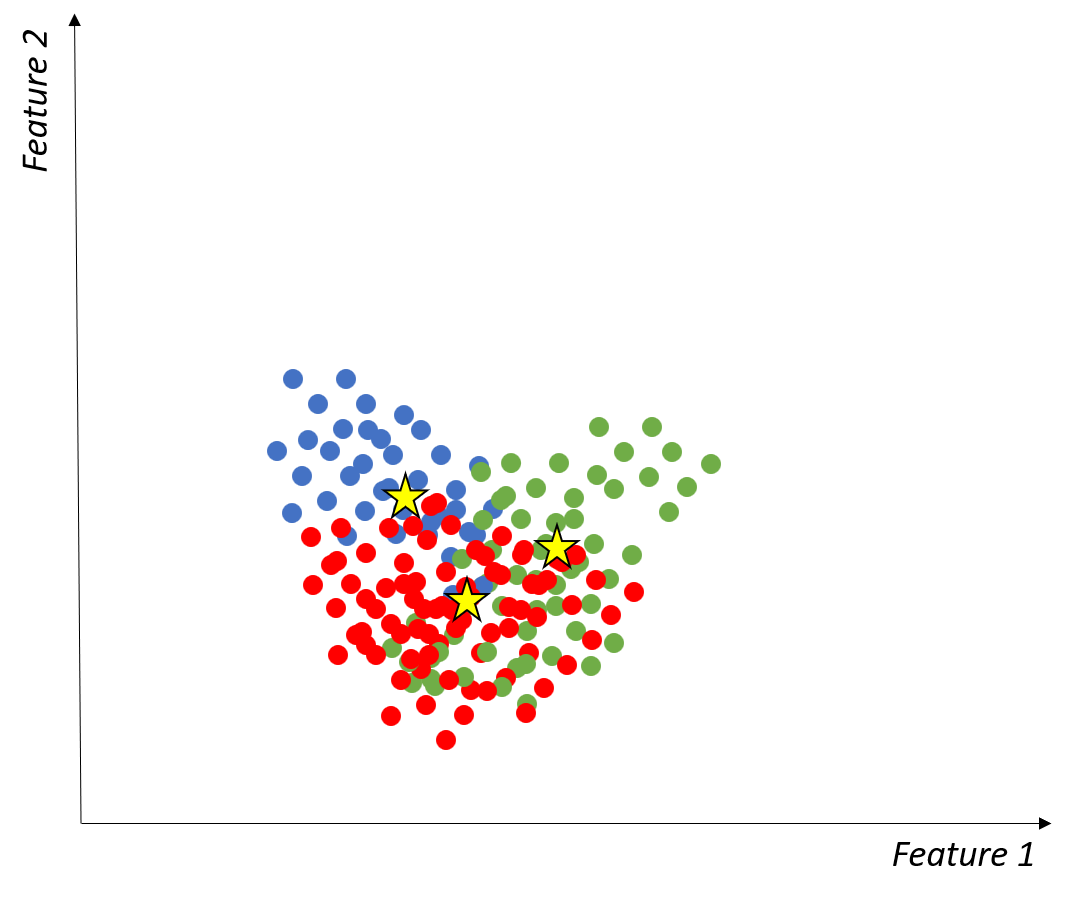
    • 1 → gut getrennte Cluster
    • -1 → falsch zugewiesene Punkte

Bild mit Clustern ohne klare Trennung.

Erklärbare KI in Python

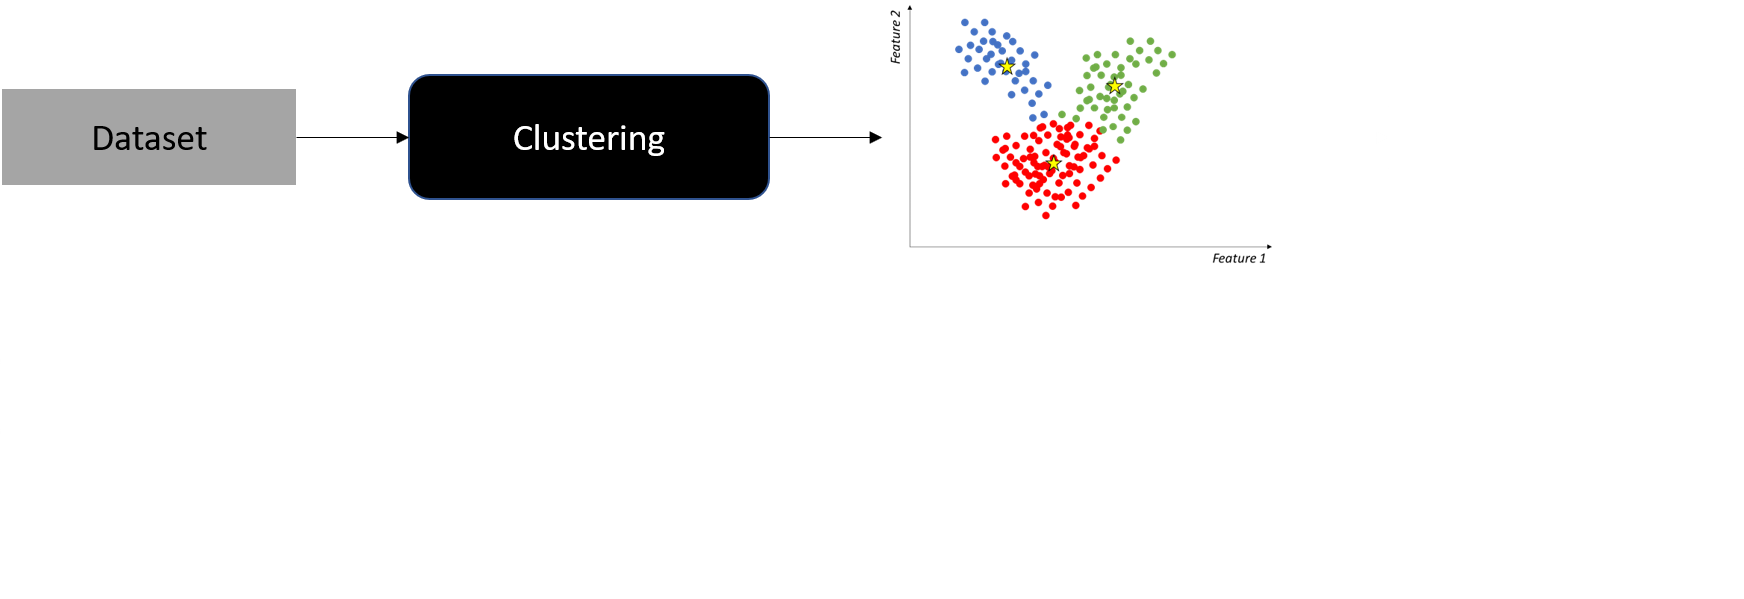
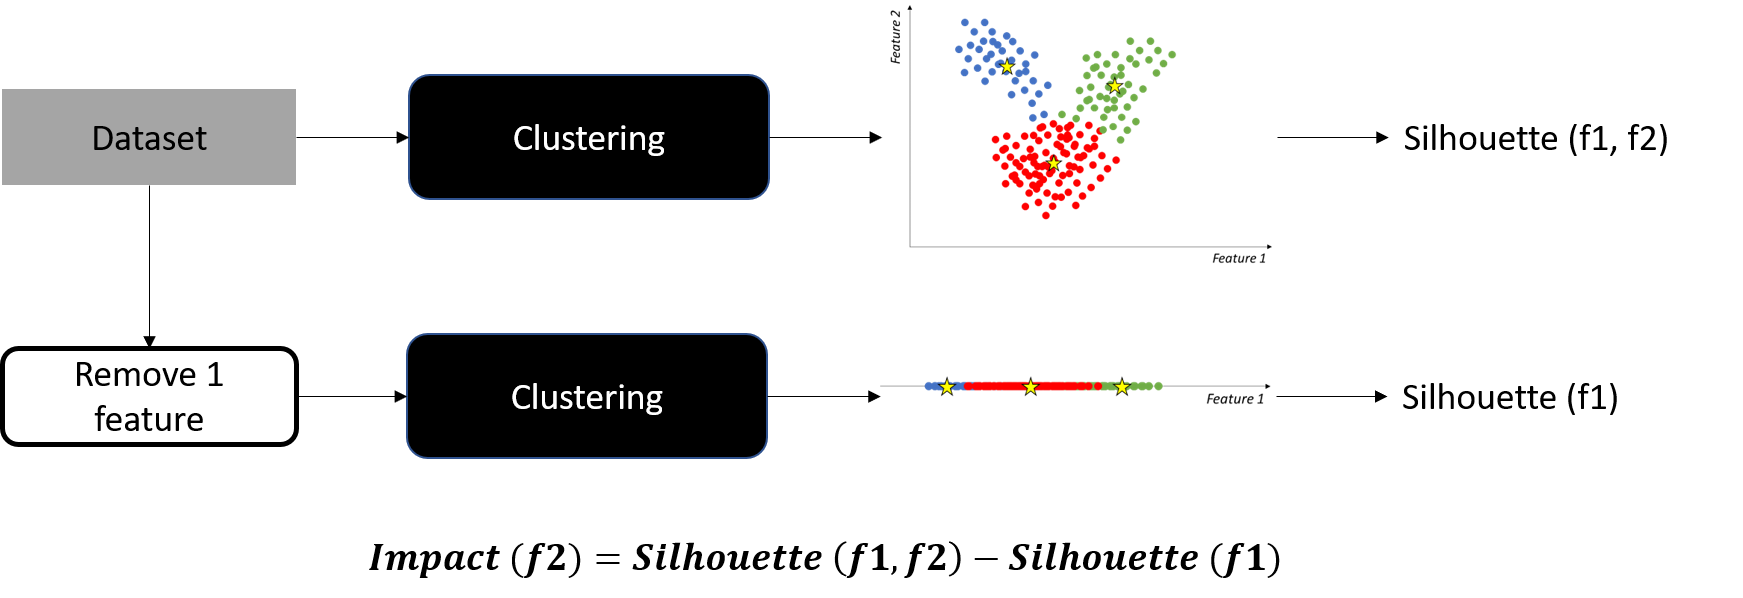
Merkmals­einfluss auf Clusterqualität

Bild mit dem Clustering-Ergebnis eines Datensatzes mit 2 Merkmalen, der dem Algorithmus übergeben wurde.

Erklärbare KI in Python

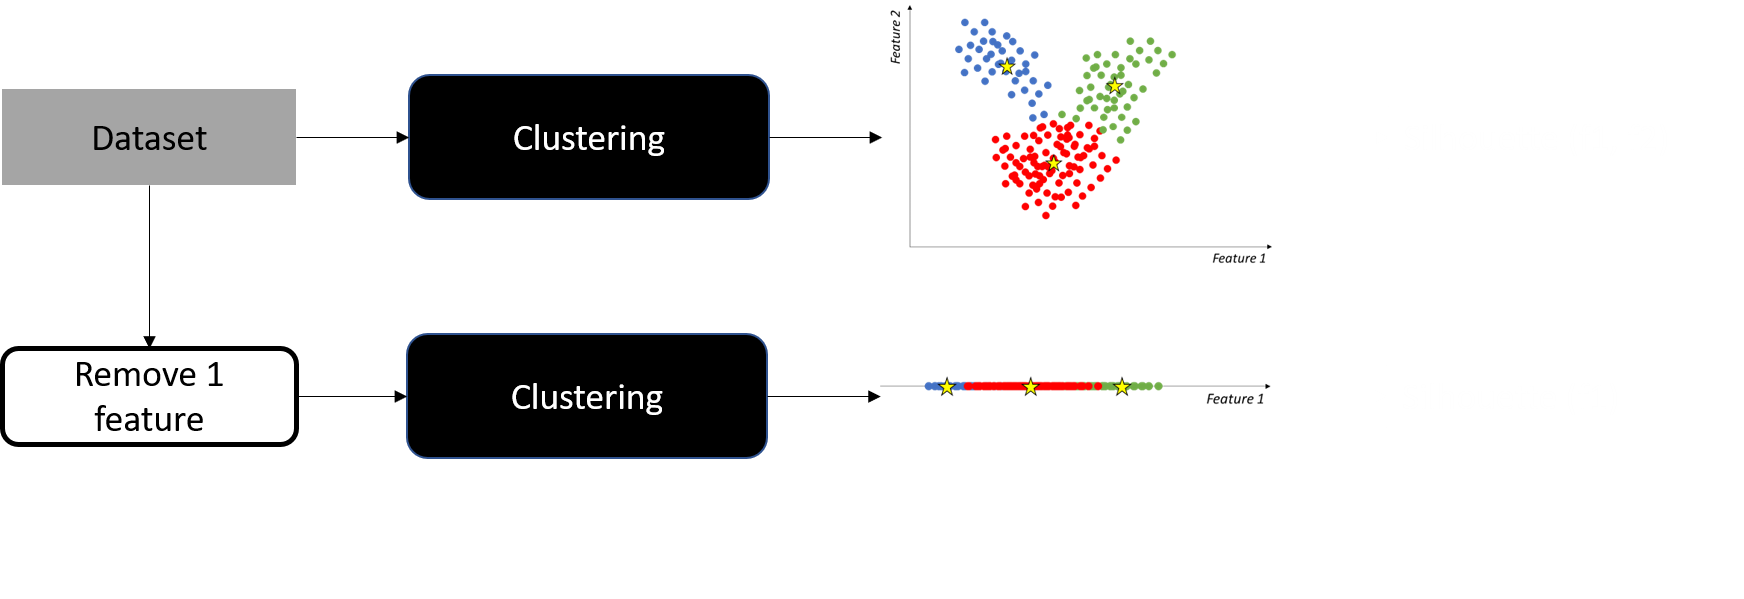
Merkmals­einfluss auf Clusterqualität

Bild mit dem Clustering-Ergebnis nach Entfernen eines Merkmals und erneutem Trainieren.

Erklärbare KI in Python

Merkmals­einfluss auf Clusterqualität

Bild mit der Formel: Einfluss des entfernten Merkmals = Differenz zwischen Silhouette-Score mit allen Merkmalen und dem Score ohne dieses Merkmal.

  • $\text{Impact(}f) > 0$ → positives Beitrag für $f$
  • $\text{Impact(}f) < 0$ → $f$ bringt Rauschen ein
Erklärbare KI in Python

Student Performance-Datensatz

age health status absences G1 G2 G3
18 3 4 0 11 11
17 3 2 9 11 11
15 3 6 12 13 12
15 5 0 14 14 14
16 5 0 11 13 13


X: Array mit Merkmalen

Erklärbare KI in Python

Merkmals­einfluss auf Clusterqualität berechnen

from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score


kmeans = KMeans(n_clusters=2).fit(X)
original_score = silhouette_score(X, kmeans.labels_)
for i in range(X.shape[1]):
X_reduced = np.delete(X, i, axis=1)
kmeans.fit(X_reduced)
new_score = silhouette_score(X_reduced, kmeans.labels_)
impact = original_score - new_score print(f'Feature {column_names[i]}: Impact = {impact}')
Erklärbare KI in Python

Merkmals­einfluss auf Clusterqualität berechnen

Feature age: Impact = 0.05199181662741281
Feature health status: Impact = 0.06046737420227638
Feature absences: Impact = 0.031290940582026694
Feature G1: Impact = -0.025746421940652353
Feature G2: Impact = -0.02578292339364119
Feature G3: Impact = -0.03163419458330158
Erklärbare KI in Python

Adjusted Rand Index (ARI)

  • Misst, wie gut Clusterzuweisungen übereinstimmen
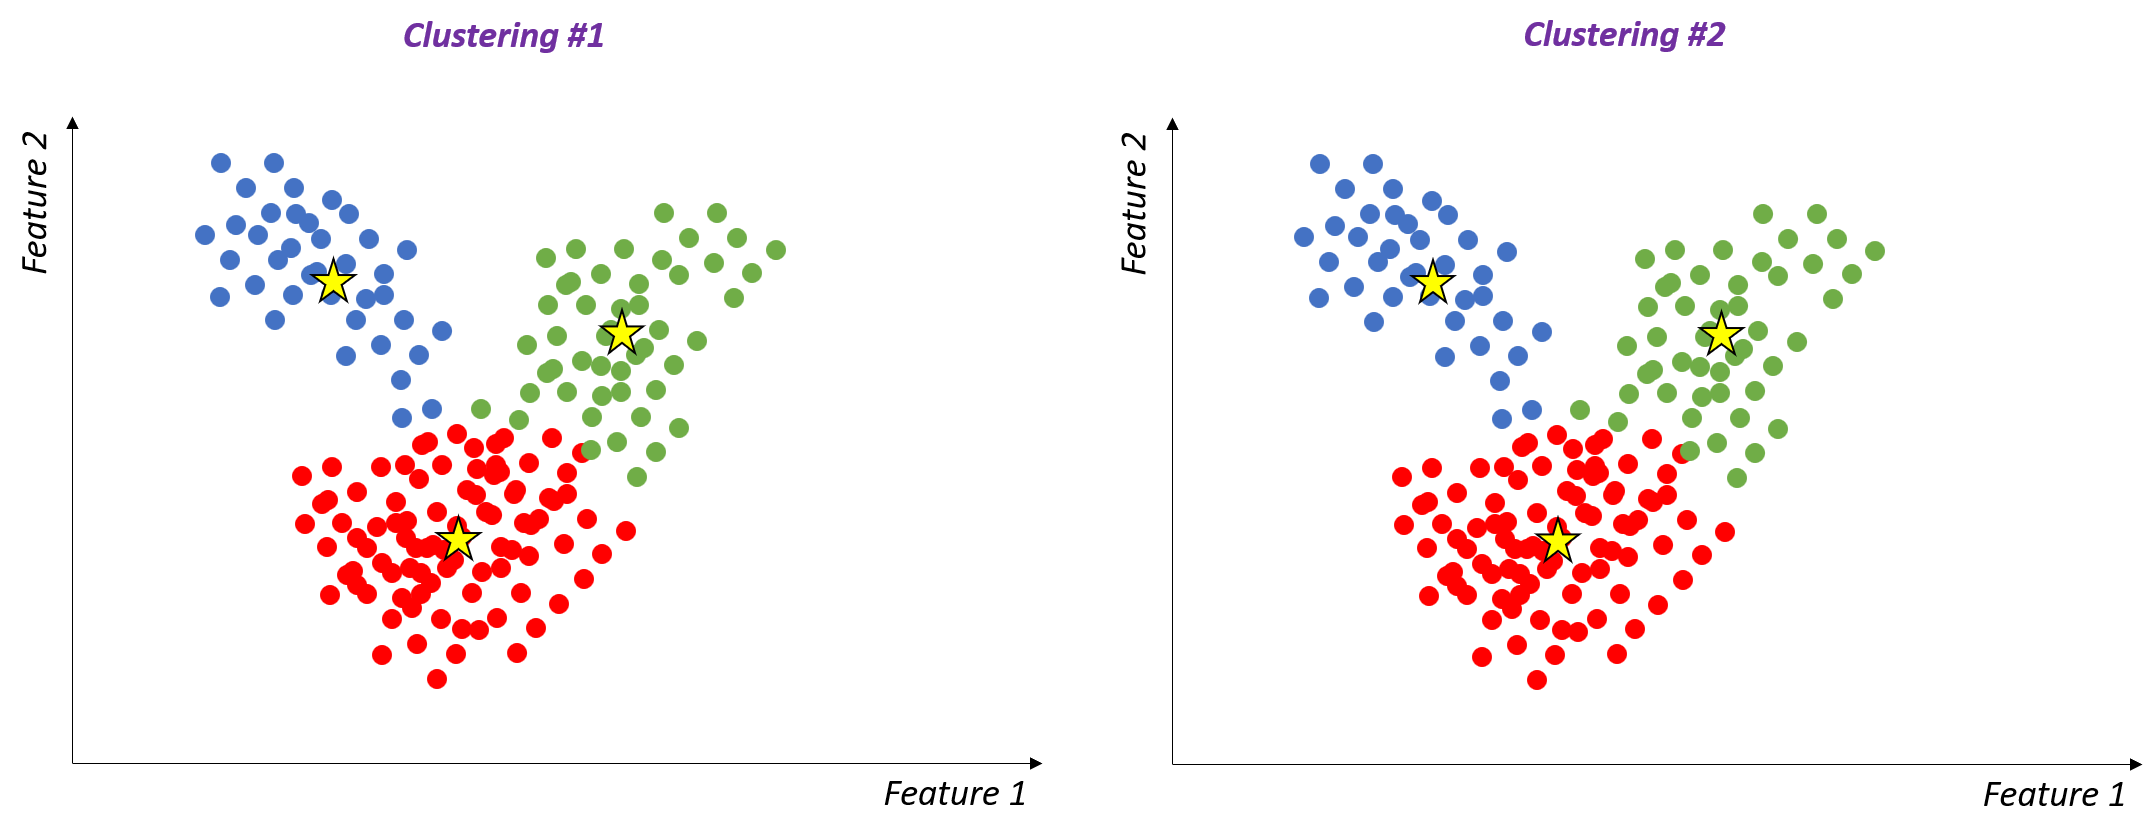
Bild mit zwei ähnlichen Clusterzuweisungen für einen Datensatz.

  • Max. ARI = 1 → perfekte Übereinstimmung
Erklärbare KI in Python

Adjusted Rand Index (ARI)

  • Misst, wie gut Clusterzuweisungen übereinstimmen
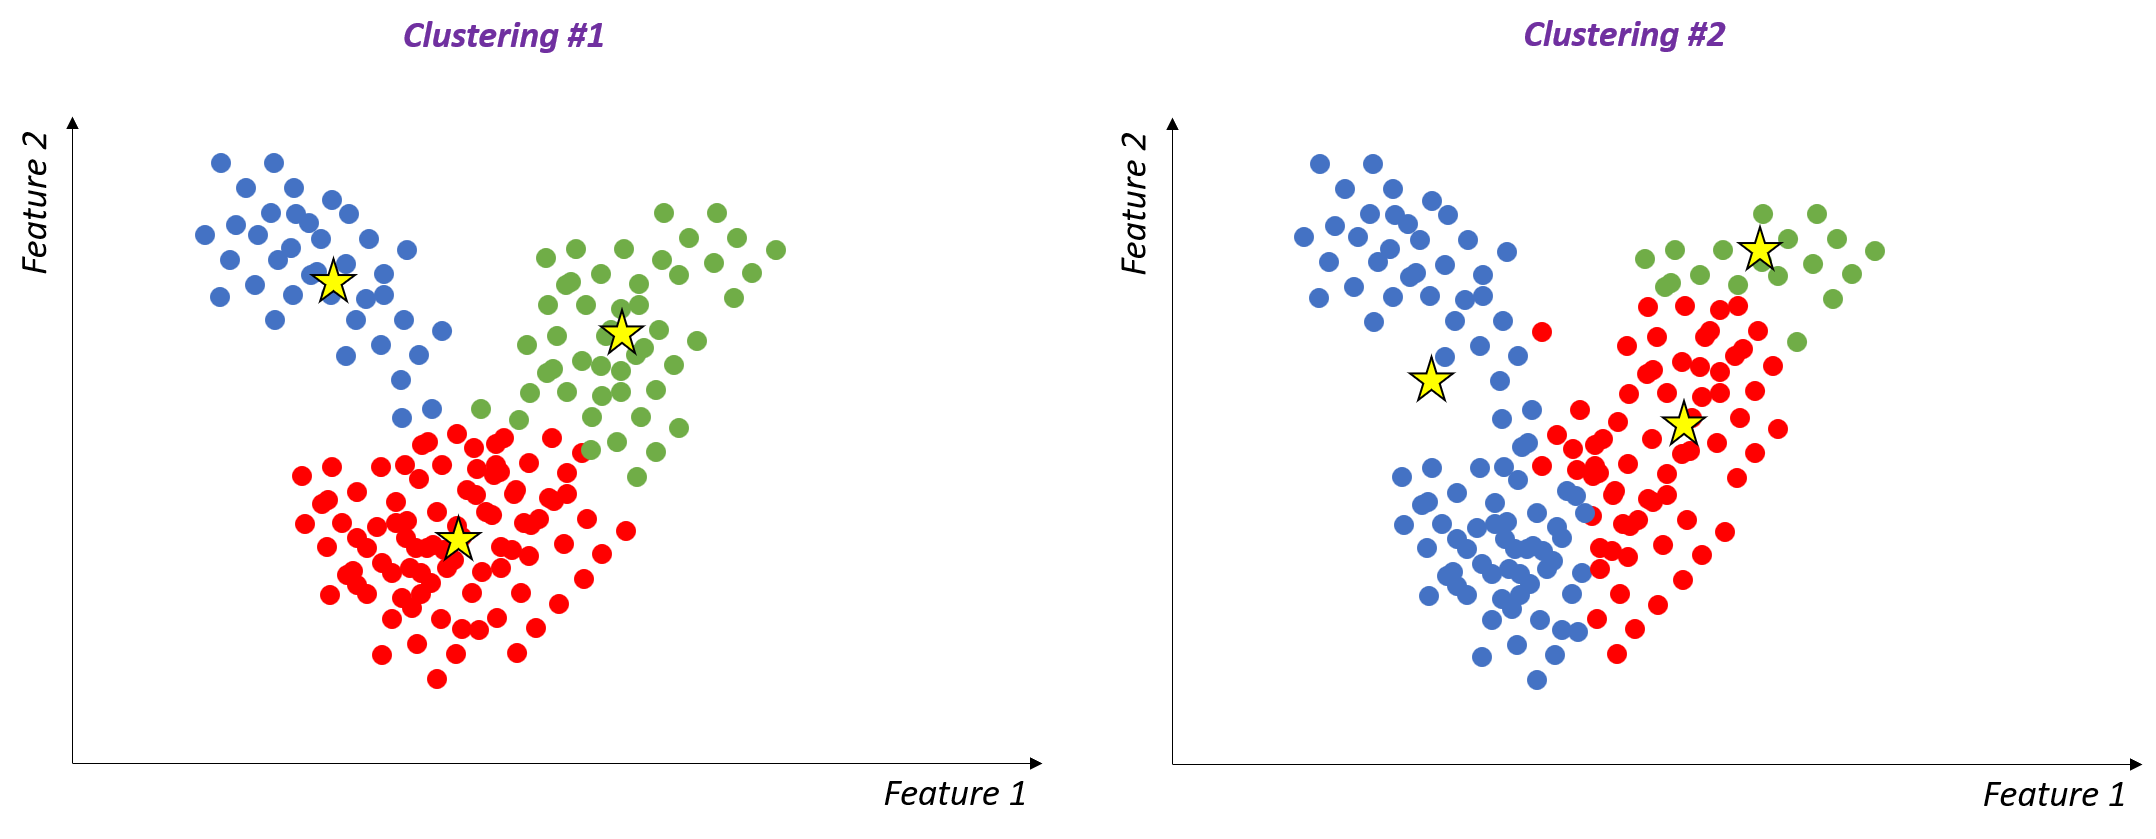
Bild mit zwei unterschiedlichen Clusterzuweisungen für denselben Datensatz.

  • Max. ARI = 1 → perfekte Übereinstimmung
  • Niedriger ARI → größere Unterschiede
Erklärbare KI in Python

Merkmalswichtigkeit für Zuweisungen


  • Merkmale einzeln entfernen
  • $\text{Importance}(f) = 1 - \text{ARI (Original vs. modifiziert)}$
  • Niedriger $\text{ARI}$ → hoher $\text{1 - ARI}$ → wichtiges Merkmal
Erklärbare KI in Python

Merkmalswichtigkeit für Zuweisungen

from sklearn.metrics import adjusted_rand_score

kmeans = KMeans(n_clusters=2).fit(X) original_clusters = kmeans.predict(X)
for i in range(X.shape[1]):
X_reduced = np.delete(X, i, axis=1)
reduced_clusters = kmeans.fit_predict(X_reduced)
importance = 1 - adjusted_rand_score(original_clusters, reduced_clusters) print(f'{df.columns[i]}: {importance}')
age: 0.0
health status: 0.9995376368119572
absences: 0.0
G1: 0.0
G2: 0.6204069909514572
G3: 0.6204069909514572
Erklärbare KI in Python

Lass uns üben!

Erklärbare KI in Python

Preparing Video For Download...