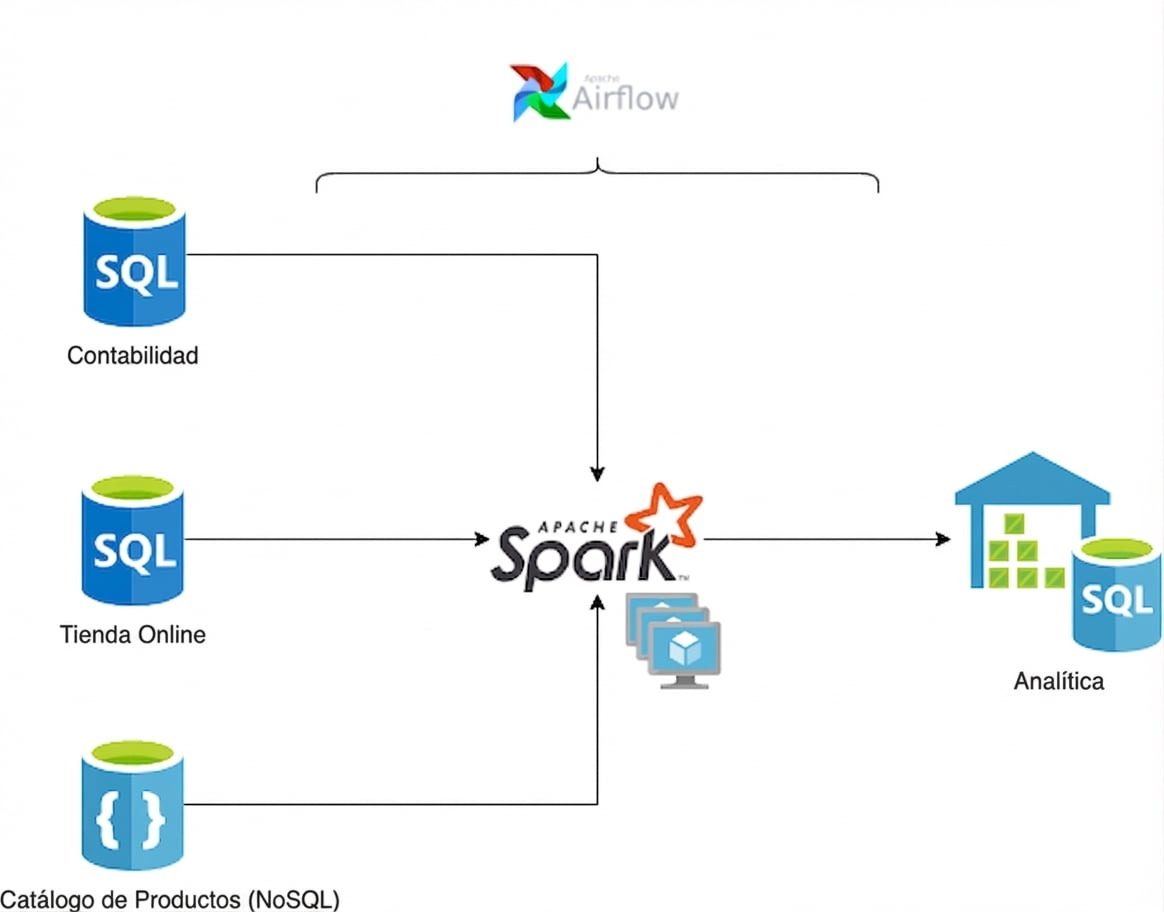
Herramientas del data engineer
Introducción a la ingeniería de datos

Vincent Vankrunkelsven
Data Engineer, DataCamp
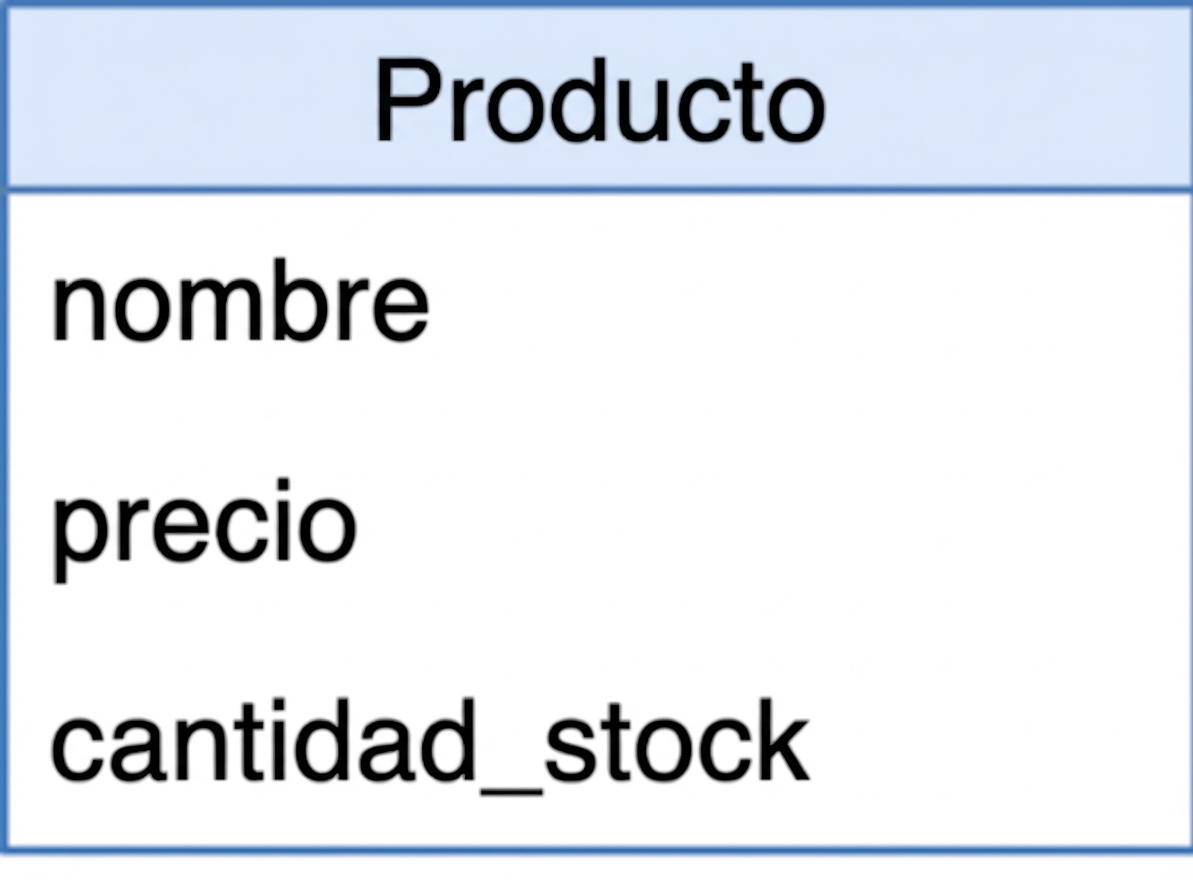
Bases de datos
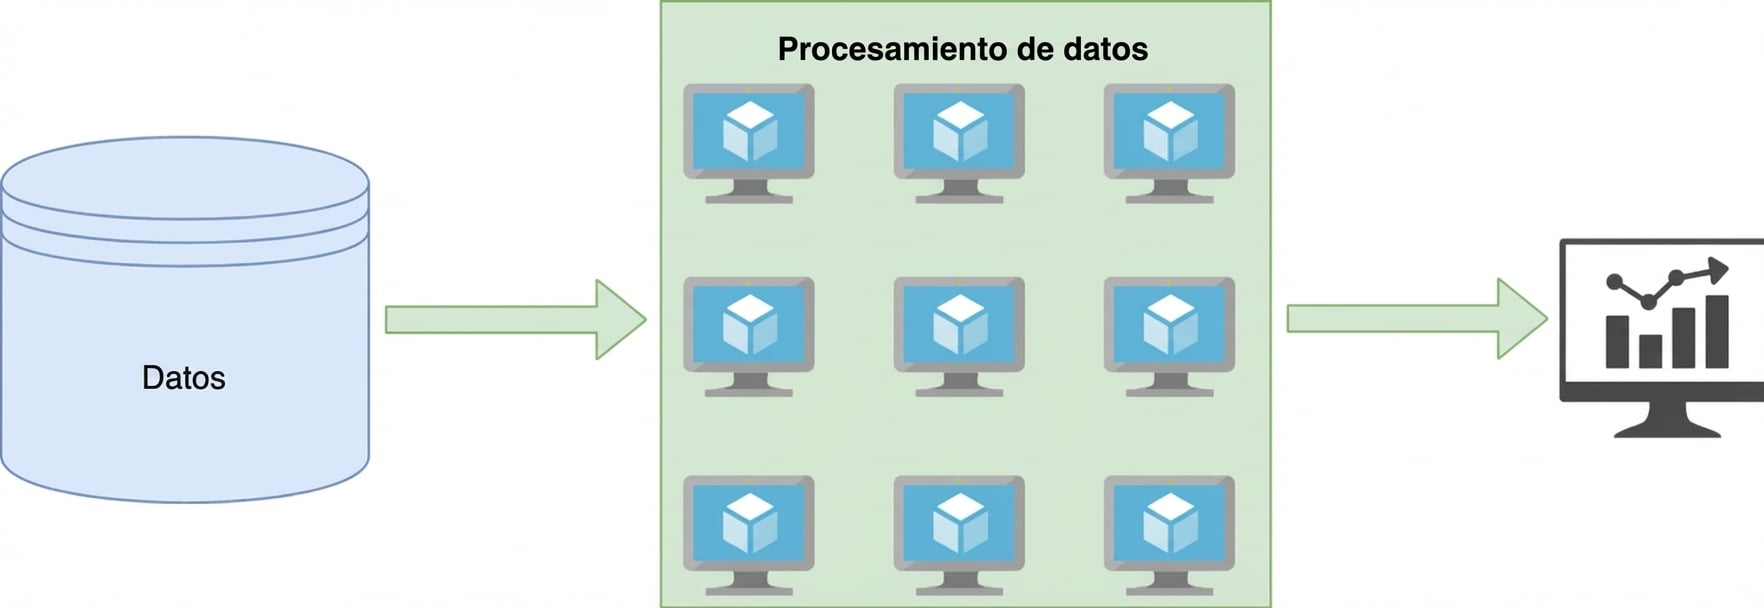
Procesamiento
Planificación
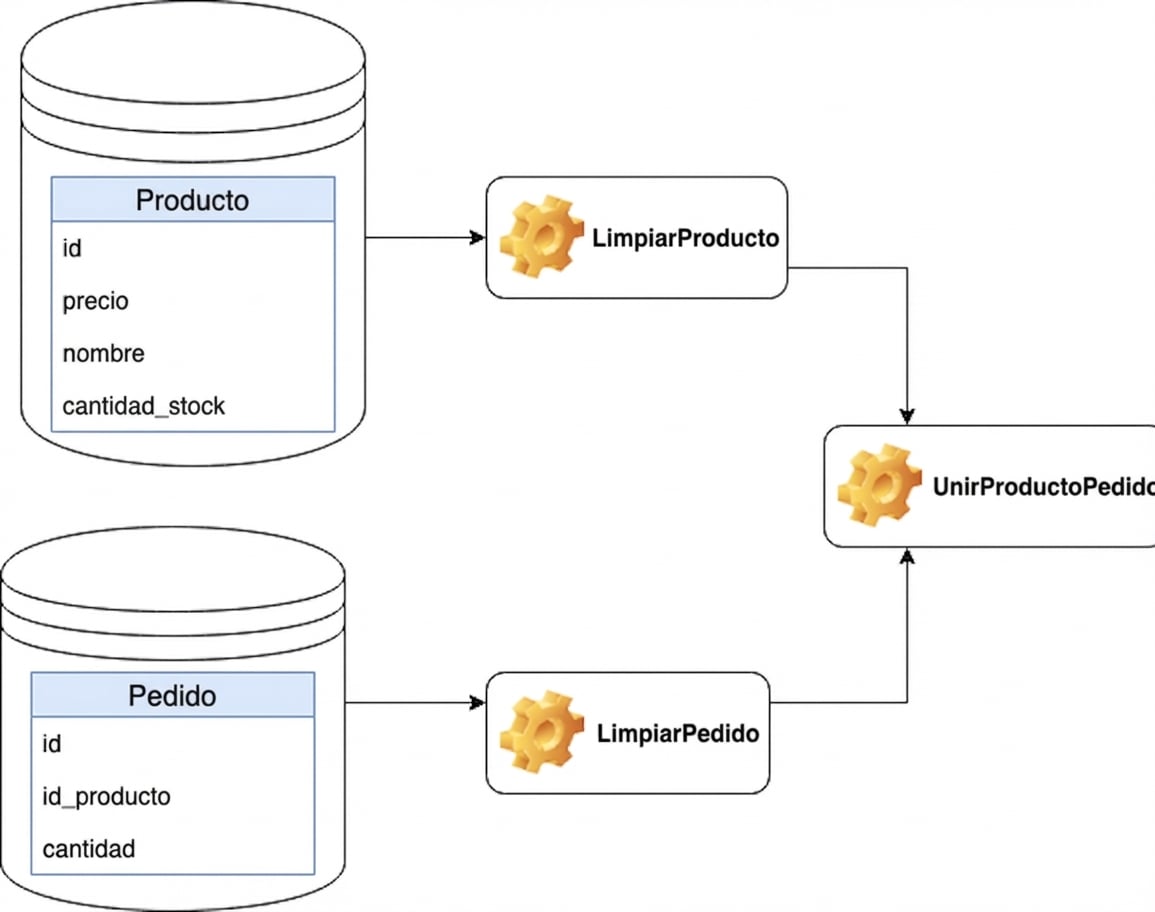
JoinProductOrder debe ejecutarse después de CleanProduct y CleanOrder
Herramientas existentes
Bases de datos
Procesamiento
Planificación
Un data pipeline