Configuration des données expérimentales

Conception expérimentale en Python

James Chapman

Curriculum Manager, DataCamp

Le problème de la randomisation
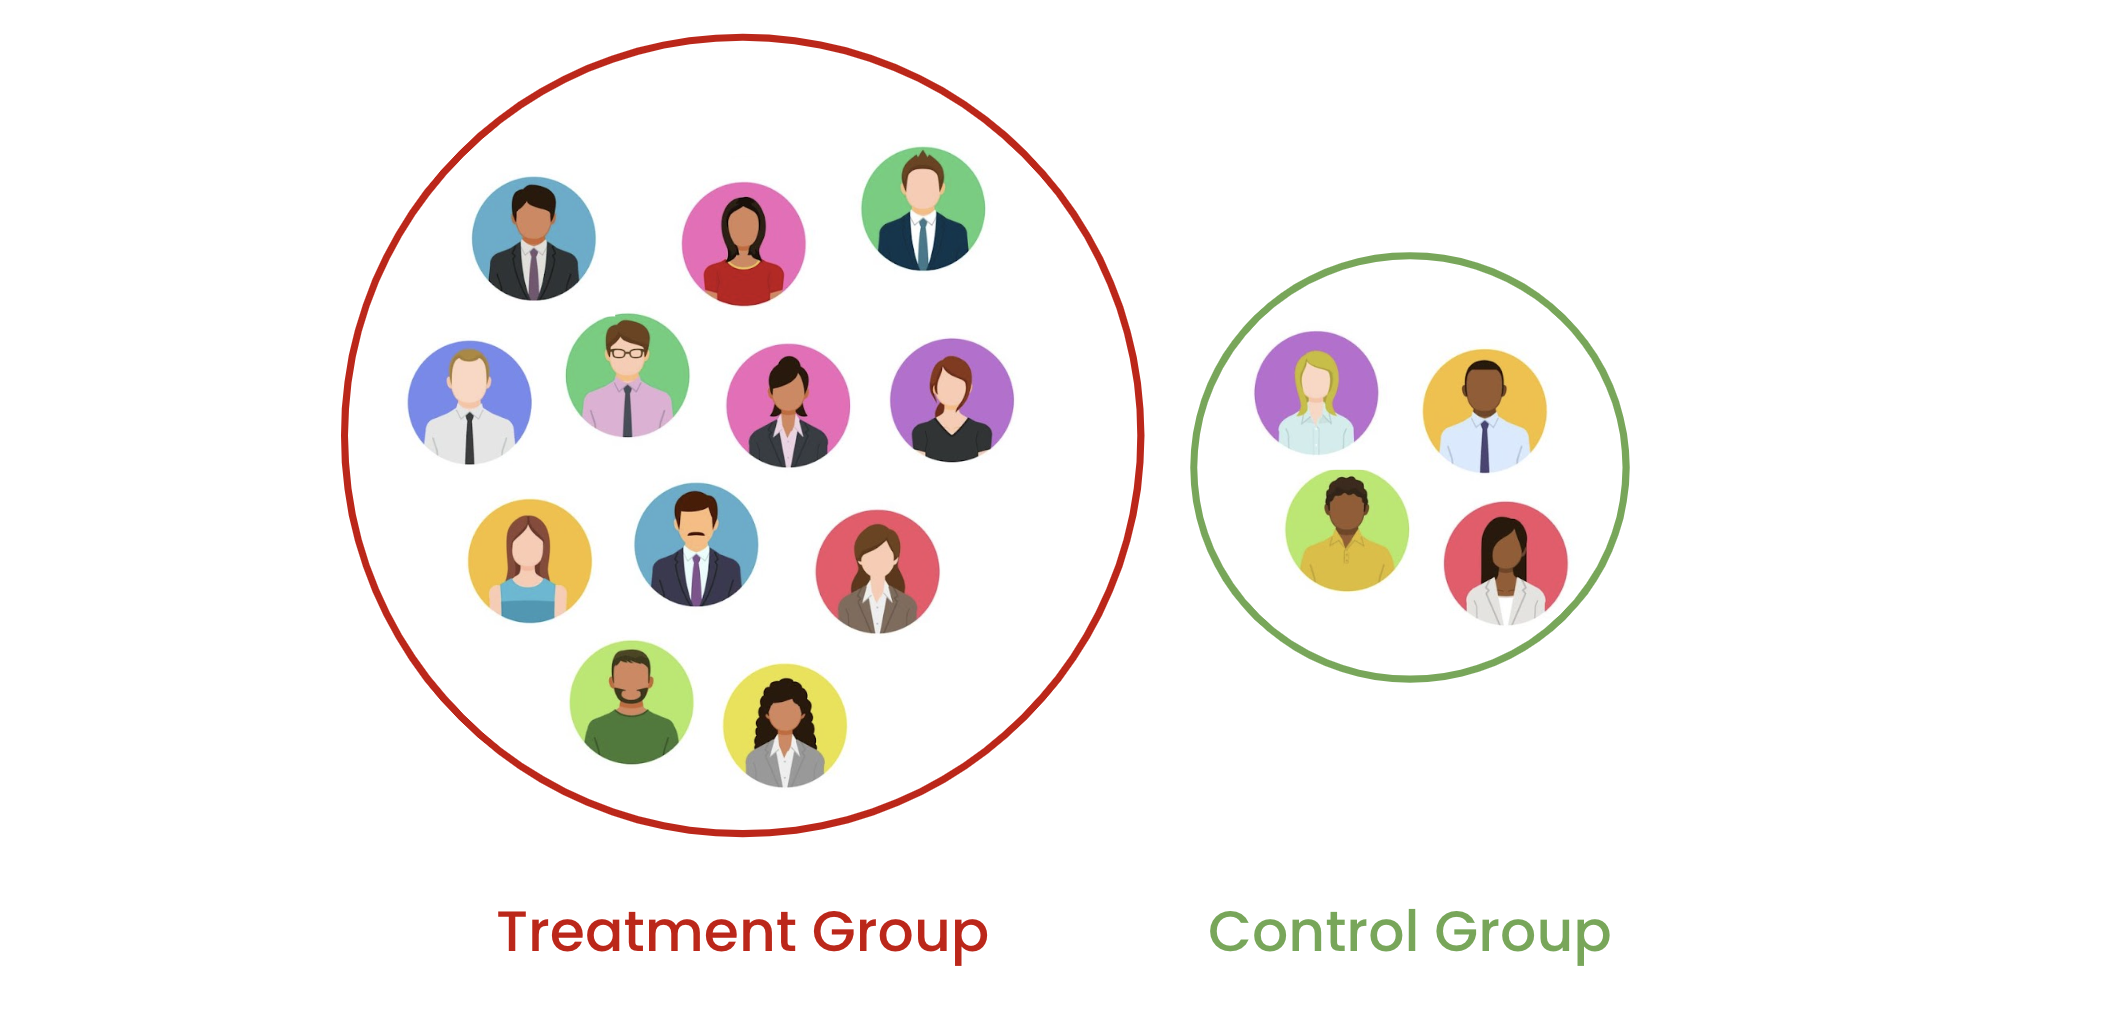
1) Problème d'inégalité : nombre de sujets différent entre groupes

Deux groupes avec un nombre de sujets différent.

Conception expérimentale en Python

Le problème de la randomisation

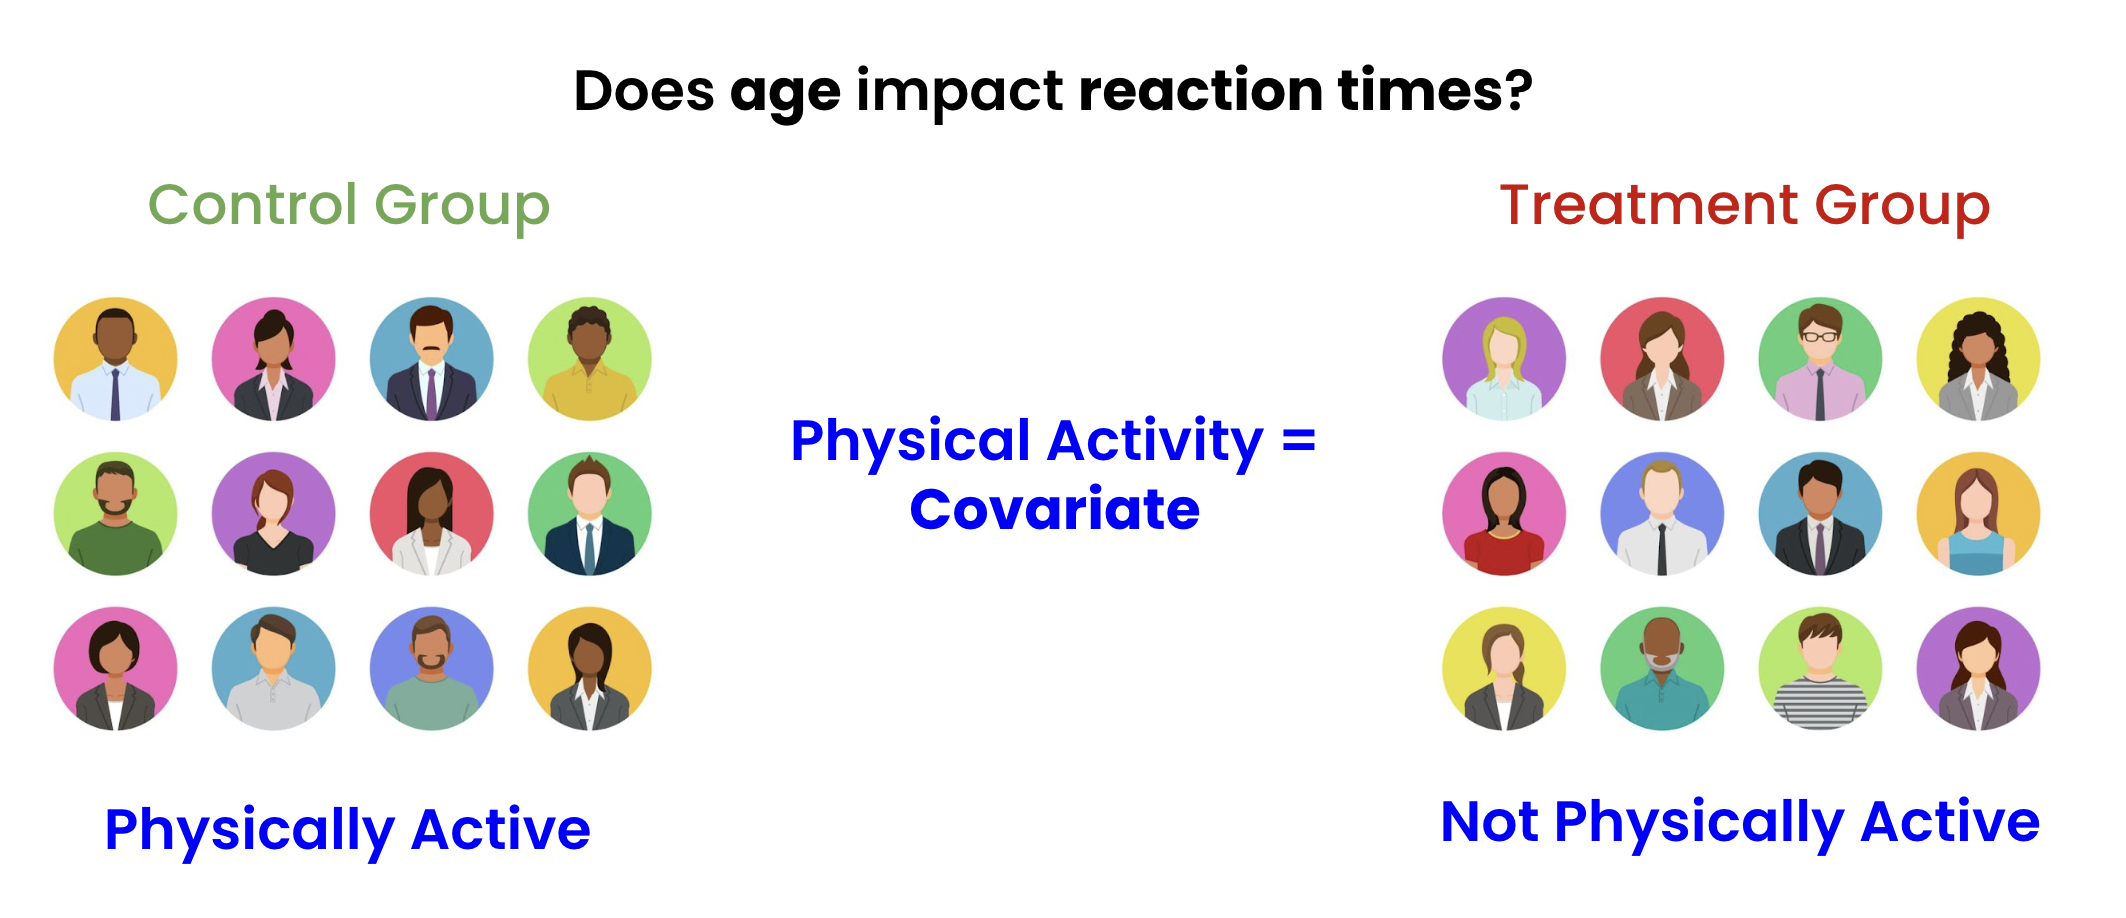
2) Problème de covariable : forte variabilité de certaines covariables → déséquilibres à la randomisation

Groupes témoin et traitement pour mesurer l'impact de l'âge sur les temps de réaction. Les deux groupes ont une distribution inégale de la condition physique, qui, bien que non visée, peut affecter la variable « temps de réaction ».

Résultat : effet du traitement plus difficile à mesurer !

Conception expérimentale en Python

Randomisation par blocs


  • Découper d'abord en blocs de taille $n$, puis randomiser
    • Corrige l'inégalité

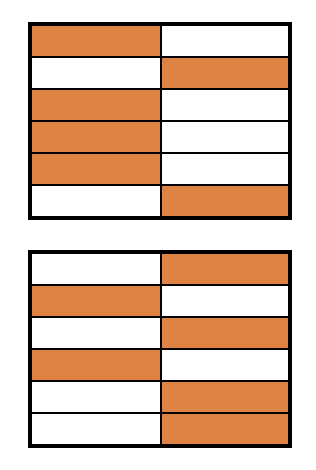
Exemple de randomisation par blocs montrant deux grilles de carrés orange et blancs

  • 24 sujets divisés en deux groupes puis randomisés
Conception expérimentale en Python

Notre jeu de données

  • Jeu de données e-commerce (ecom) (1000 sujets)
    • Taille moyenne du panier
    • Temps moyen sur le site
    • Power user (moy. 40+ min/jour sur le site)
   basket_size  web_time  power_user
0          227         7           0
1          123         5           0
2           98        16           0
3          211        45           1
4          133        17           0
Conception expérimentale en Python

Randomisation par blocs en Python

group1 = ecom.sample(frac=0.5, random_state=42, replace=False)
group1['Block'] = 1
group2 = ecom.drop(group1.index)
group2['Block'] = 2
print(len(group1), len(group2))
500,500
Conception expérimentale en Python

Visualiser les découpages


import seaborn as sns
import matplotlib.pyplot as plt
sns.displot(data=ecom, 
            x='basket_size', 
            hue='power_user', 
            fill=True, 
            kind='kde')    
plt.show()

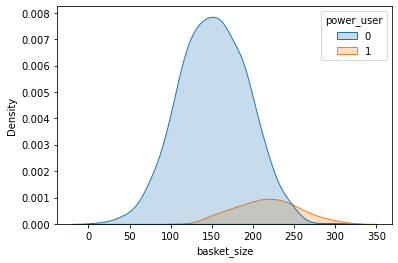
Confusion = une variable peut causer l'effet plutôt que le traitement


Un graphique de distribution seaborn montrant deux distributions quasi normales, légèrement transparentes : une grande bleue et une plus petite orange, qui se chevauchent légèrement avec l'orange plus à droite

Conception expérimentale en Python

Randomisation stratifiée


  • Découper d'abord selon la/les covariable(s)
    • Puis randomiser
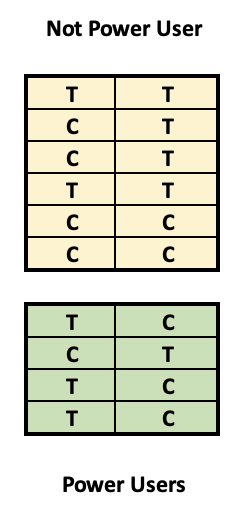
  • Vert = Tous les power users (Jaune = Non power users)
    • Puis répartir Traitement/Témoin
  • Corrige le problème de covariable/confusion
  • Possible avec plusieurs covariables, mais devient complexe

Une image de deux grilles de données, une verte et une jaune, contenant des lettres T ou C dans chaque case ; la grille jaune est plus grande

Conception expérimentale en Python

Notre première strate

  • Séparer les power users
  • Échantillonner en Traitement/Témoin
strata_1 = ecom[ecom['power_user'] == 1]
strata_1['Block'] = 1

strata_1_g1 = strata_1.sample(frac=0.5, replace=False) strata_1_g1['T_C'] = 'T'
strata_1_g2 = strata_1.drop(strata_1_g1.index) strata_1_g2['T_C'] = 'C'
Conception expérimentale en Python

La seconde strate

  • Séparer les non power users
  • Échantillonner en Traitement/Témoin
strata_2 = ecom.drop(strata_1.index)
strata_2['Block'] = 2

strata_2_g1 = strata_2.sample(frac=0.5, replace=False) strata_2_g1['T_C'] = 'T' strata_2_g2 = strata_2.drop(strata_2_g1.index) strata_2_g2['T_C'] = 'C'
Conception expérimentale en Python

Confirmer la stratification

  • Fusionner blocs et groupes
  • Utiliser groupby pour vérifier l'allocation
ecom_stratified = pd.concat([strata_1_g1, strata_1_g2, strata_2_g1, strata_2_g2])

ecom_stratified.groupby(['Block','T_C', 'power_user']).size()
Block  T_C  power_user
1      C    1              50
       T    1              50
2      C    0             450
       T    0             450
Conception expérimentale en Python

Passons à la pratique !

Conception expérimentale en Python

Preparing Video For Download...