Das Laden

Einführung in das Data Engineering

Vincent Vankrunkelsven

Data Engineer, DataCamp

Datenbanken für Analyse oder für Anwendung

{{1}}Analyse

Icon representing analytics

Aggregierte Abfragen

{{2}}Anwendungen
Symbol für Anwendungen

Viele Transaktionen

Einführung in das Data Engineering

Spalten- und zeilenorientiert

Analytik

Spaltenorientiert

Beispiel für spaltenorientierte Speicherung

Anwendungen

Zeilenorientiert

Beispiel für zeilenorientierte Speicherung

Einführung in das Data Engineering

MPP-Datenbanken

Massively Parallel Processing Databases
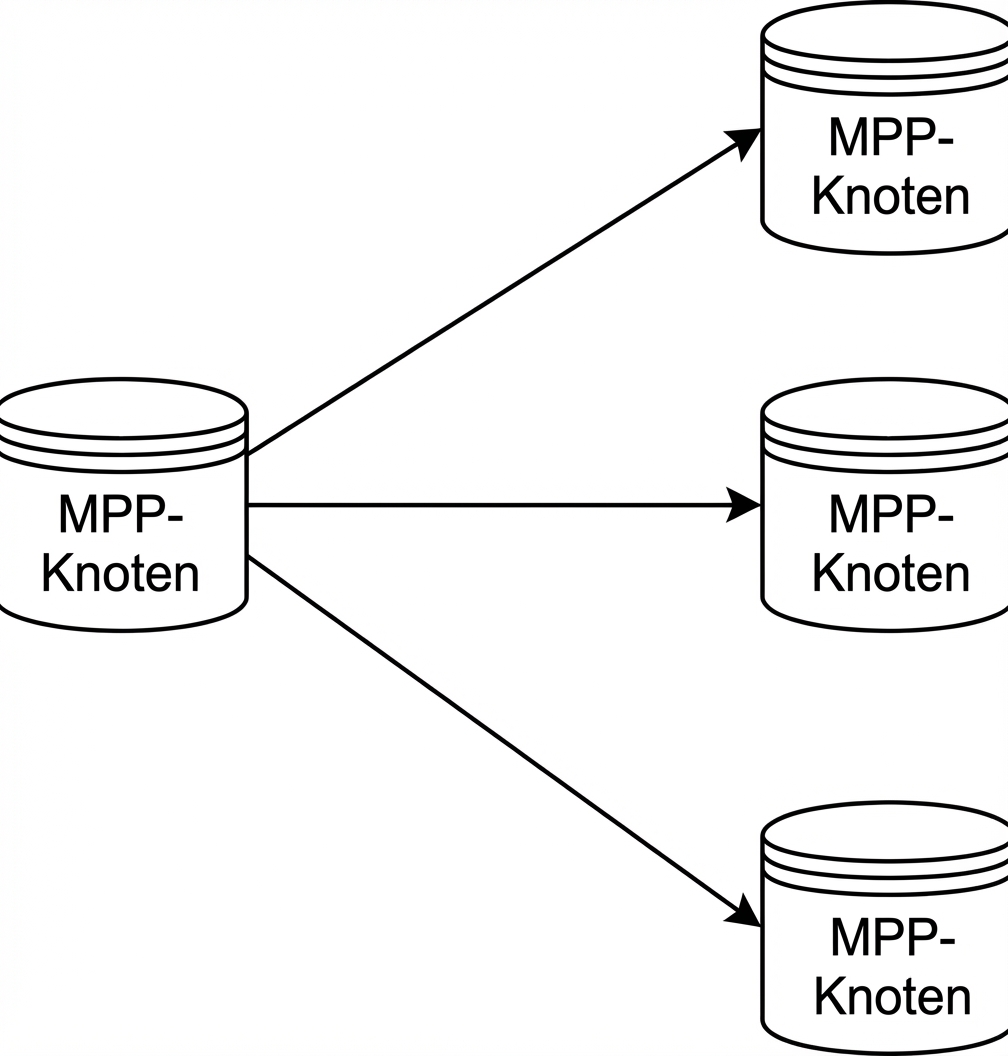
Diagramm einer MPP-Datenbank

Amazon Redshift

Einführung in das Data Engineering

Ein Beispiel: Redshift

Die Daten aus der Datei in das spaltenorientierte Speicherformat laden

# Pandas .to_parquet() method
df.to_parquet("s3://path/to/bucket/customer.parquet")
# PySpark .write.parquet() method
df.write.parquet("s3://path/to/bucket/customer.parquet")
COPY customer
FROM 's3://path/to/bucket/customer.parquet'
FORMAT as parquet
...
Einführung in das Data Engineering

In PostgreSQL laden

pandas.to_sql()

# Transformation on data
recommendations = transform_find_recommendatins(ratings_df)

# Load into PostgreSQL database
recommendations.to_sql("recommendations",
                       db_engine,
                       schema="store",
                       if_exists="replace")
Einführung in das Data Engineering

Lass uns üben!

Einführung in das Data Engineering

Preparing Video For Download...