Expliquer les modèles non supervisés

IA explicable en Python

Fouad Trad

Machine Learning Engineer

Clustering

Regrouper des points similaires sans étiquettes préalables
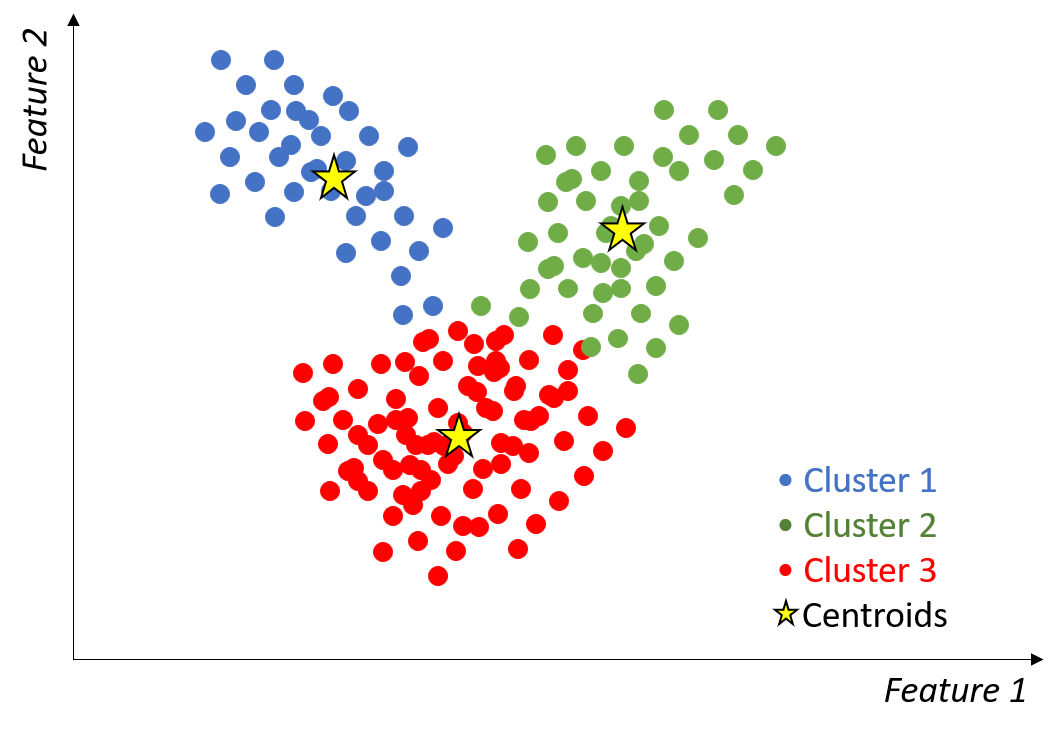
Image montrant des données avec 2 variables divisées en 3 clusters, chacun avec un centroïde.

IA explicable en Python

Silhouette score

  • Mesure la qualité du clustering
  • Va de -1 à 1
    • 1 → clusters bien séparés

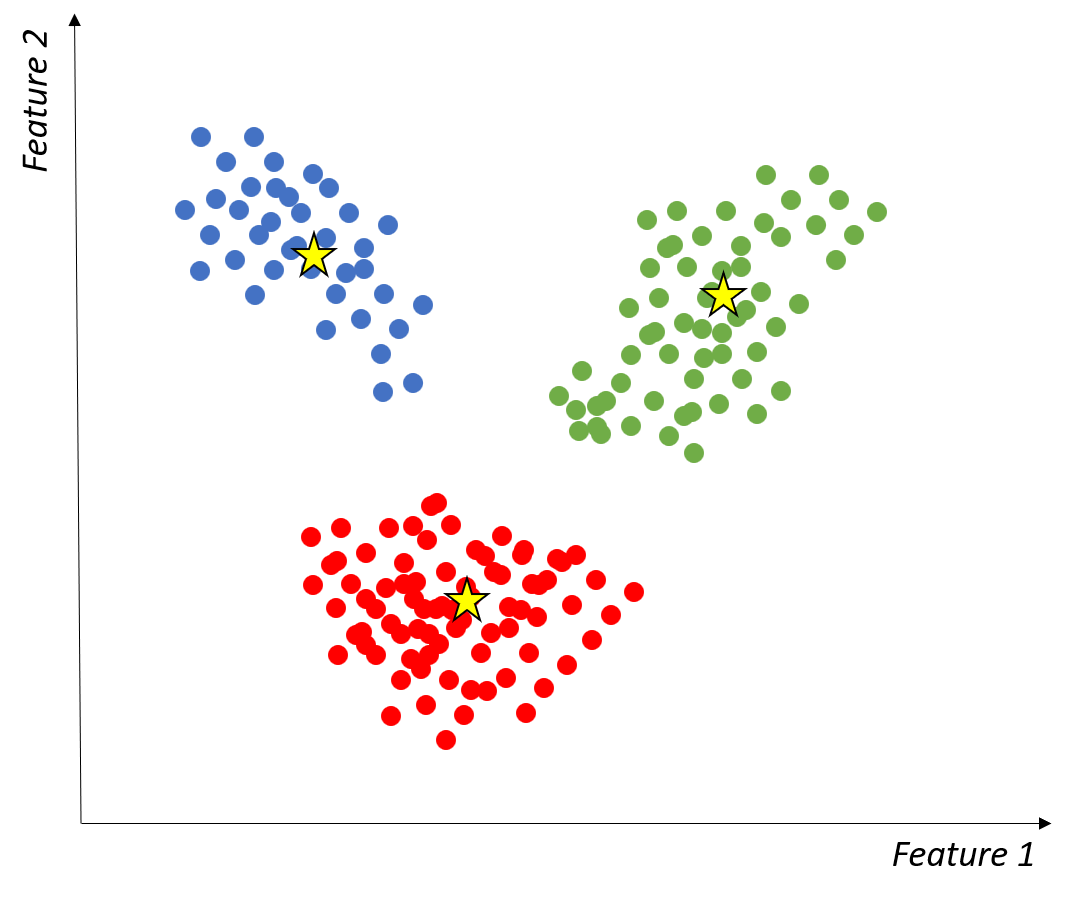
Image montrant des clusters bien séparés.

IA explicable en Python

Silhouette score

  • Mesure la qualité du clustering
  • Va de -1 à 1
    • 1 → clusters bien séparés
    • -1 → points mal affectés

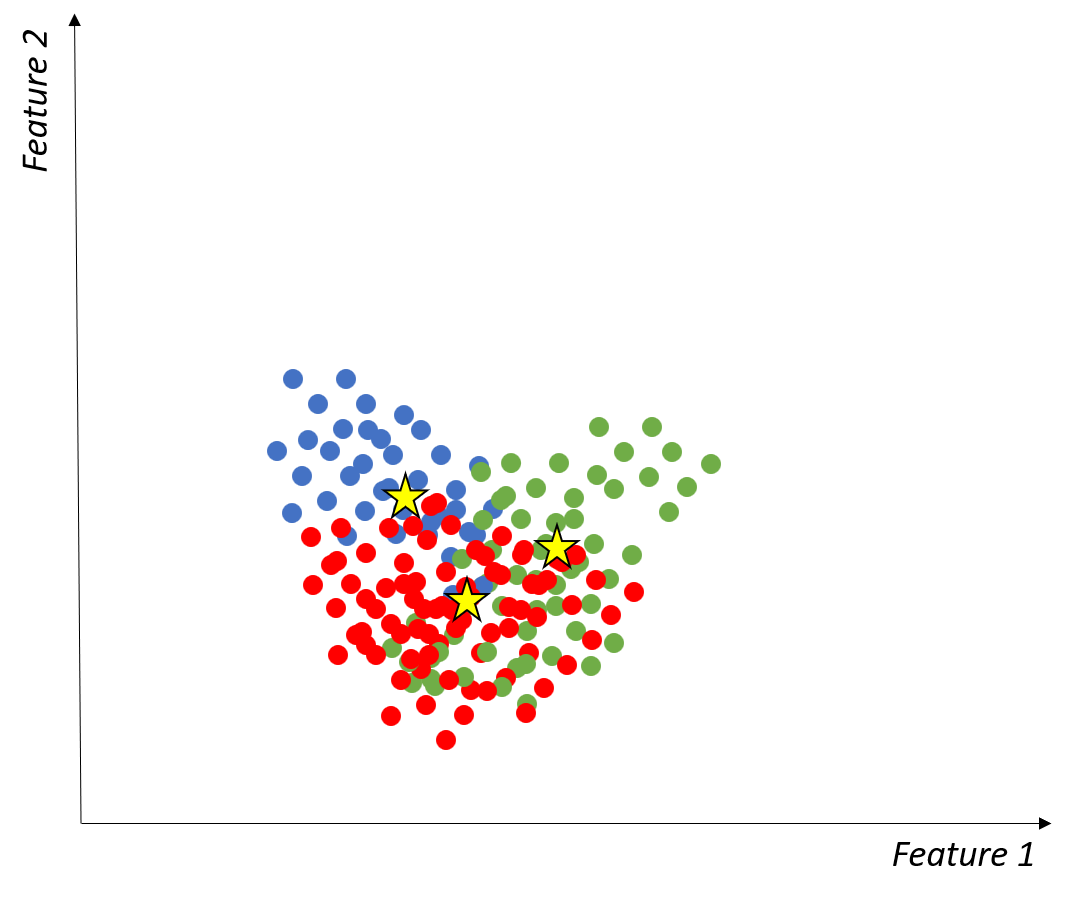
Image montrant des clusters sans séparation nette.

IA explicable en Python

Impact des variables sur la qualité des clusters
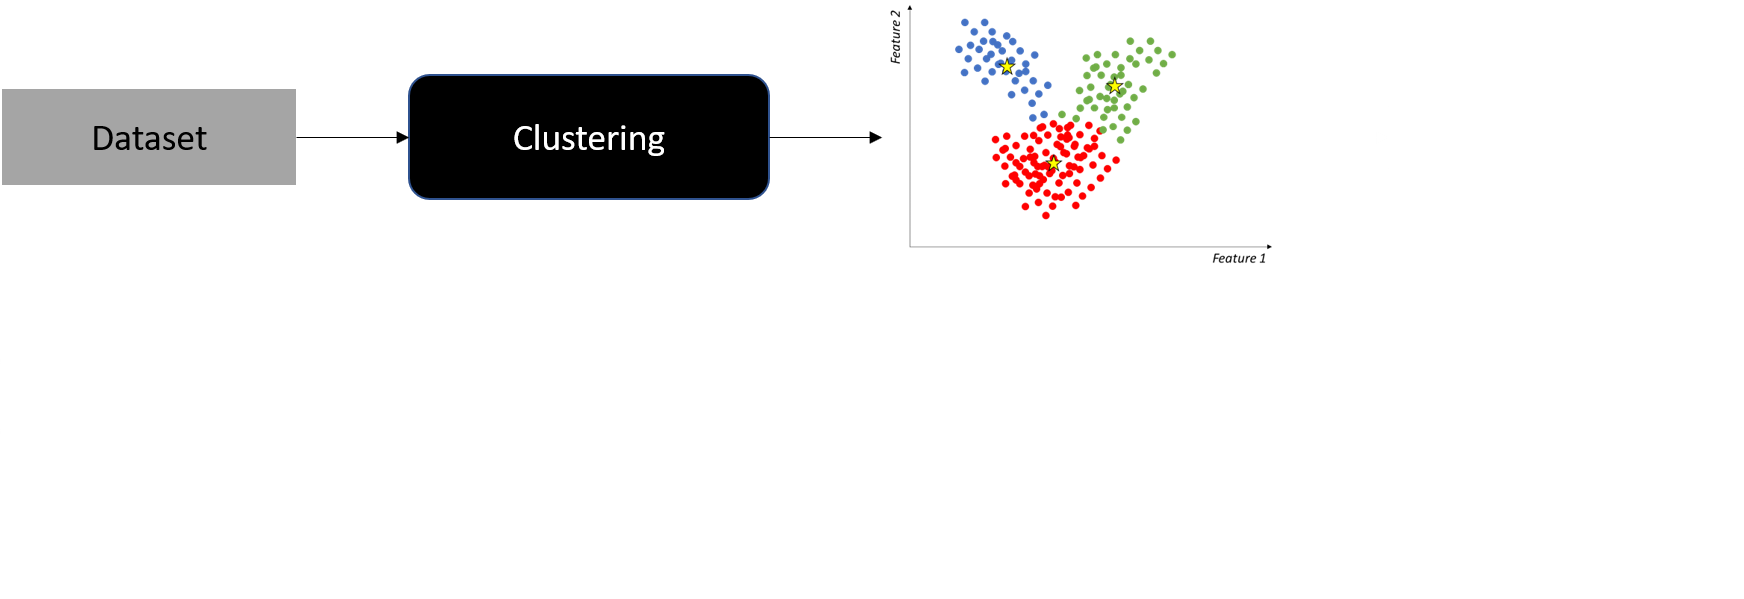
Image montrant le résultat de clustering d'un jeu de données avec 2 variables donné à l'algorithme.

IA explicable en Python

Impact des variables sur la qualité des clusters
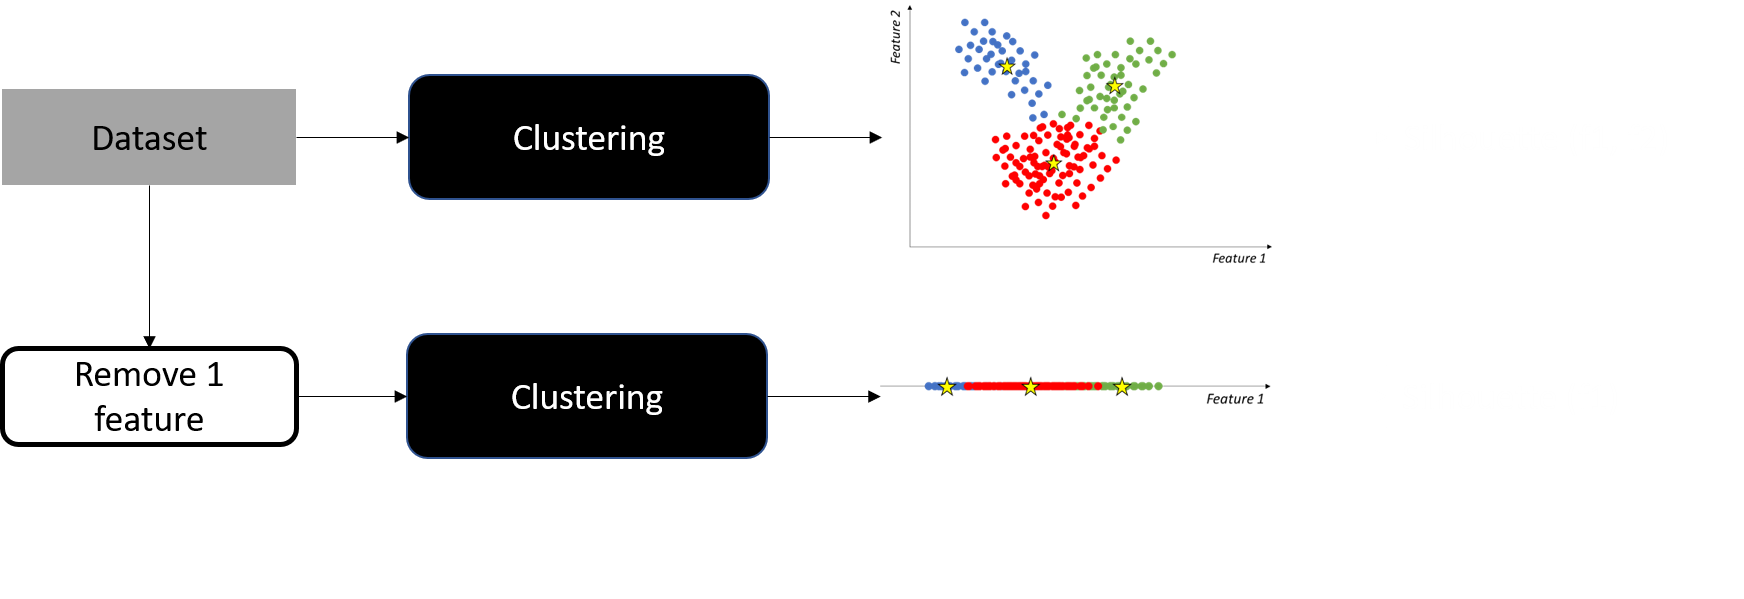
Image montrant le résultat de clustering après avoir retiré une variable et réentraîné le modèle.

IA explicable en Python

Impact des variables sur la qualité des clusters
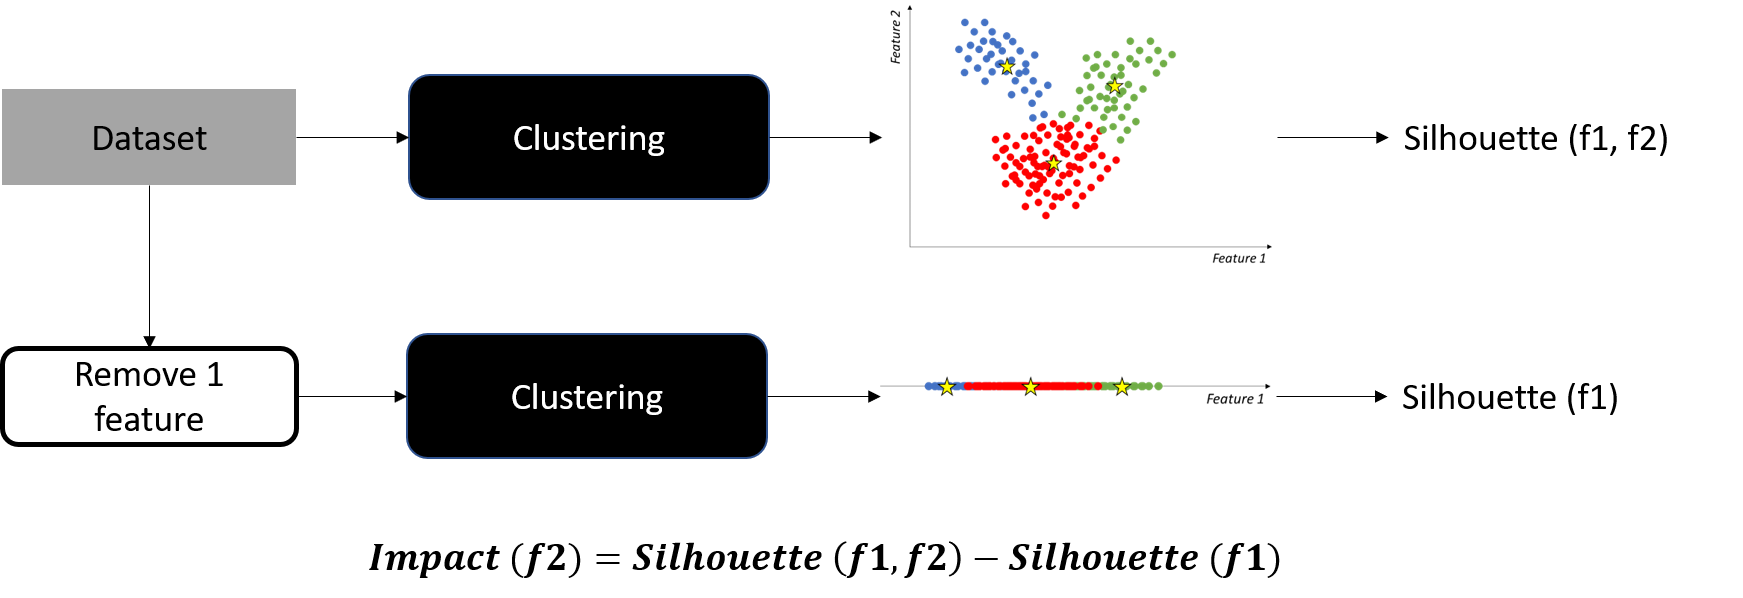
Image montrant la formule pour obtenir l'impact de la variable retirée comme la différence entre le score de silhouette avec les deux variables et le score de silhouette sans la variable.

  • $\text{Impact(}f) > 0$ → contribution positive de $f$
  • $\text{Impact(}f) < 0$ → $f$ ajoute du bruit
IA explicable en Python

Jeu de données Student Performance

age état de santé absences G1 G2 G3
18 3 4 0 11 11
17 3 2 9 11 11
15 3 6 12 13 12
15 5 0 14 14 14
16 5 0 11 13 13


X: tableau contenant les variables

IA explicable en Python

Calculer l'impact des variables sur la qualité des clusters

from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score


kmeans = KMeans(n_clusters=2).fit(X)
original_score = silhouette_score(X, kmeans.labels_)
for i in range(X.shape[1]):
X_reduced = np.delete(X, i, axis=1)
kmeans.fit(X_reduced)
new_score = silhouette_score(X_reduced, kmeans.labels_)
impact = original_score - new_score print(f'Feature {column_names[i]}: Impact = {impact}')
IA explicable en Python

Calculer l'impact des variables sur la qualité des clusters

Feature age: Impact = 0.05199181662741281
Feature health status: Impact = 0.06046737420227638
Feature absences: Impact = 0.031290940582026694
Feature G1: Impact = -0.025746421940652353
Feature G2: Impact = -0.02578292339364119
Feature G3: Impact = -0.03163419458330158
IA explicable en Python

Adjusted Rand Index (ARI)

  • Mesure l'adéquation entre affectations de clusters
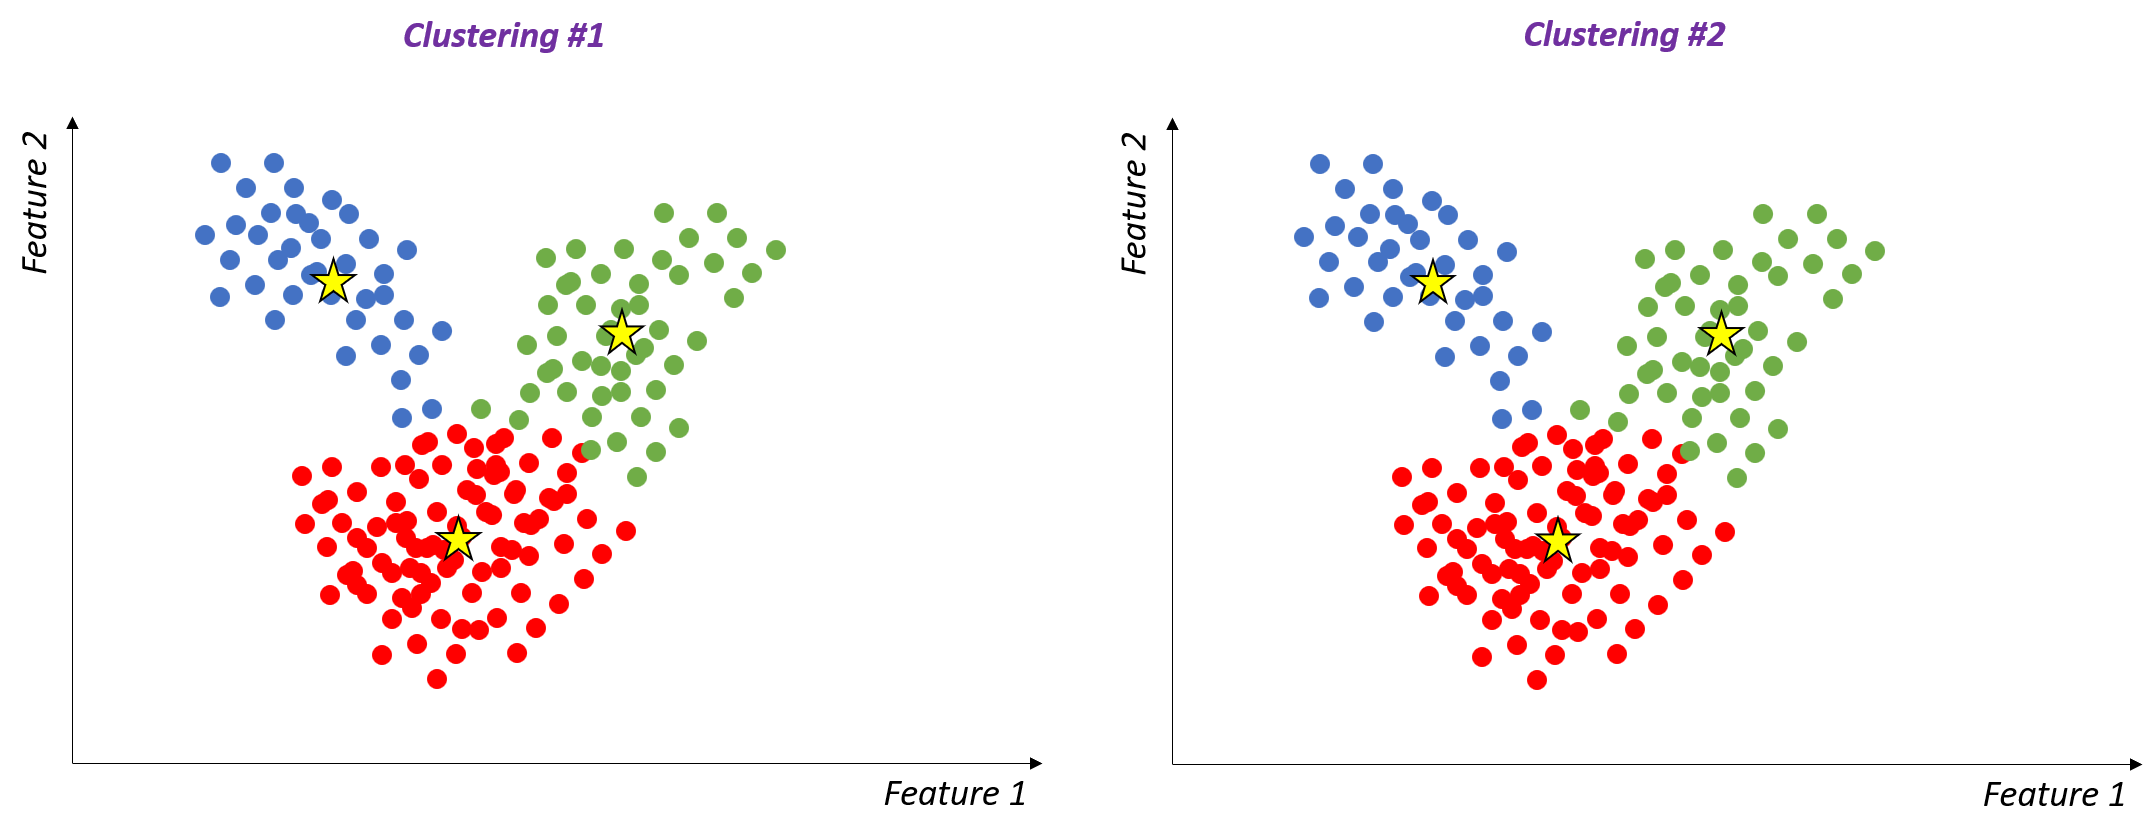
Image montrant deux affectations de clusters similaires pour un même jeu de données.

  • ARI max = 1 → alignement parfait
IA explicable en Python

Adjusted Rand Index (ARI)

  • Mesure l'adéquation entre affectations de clusters
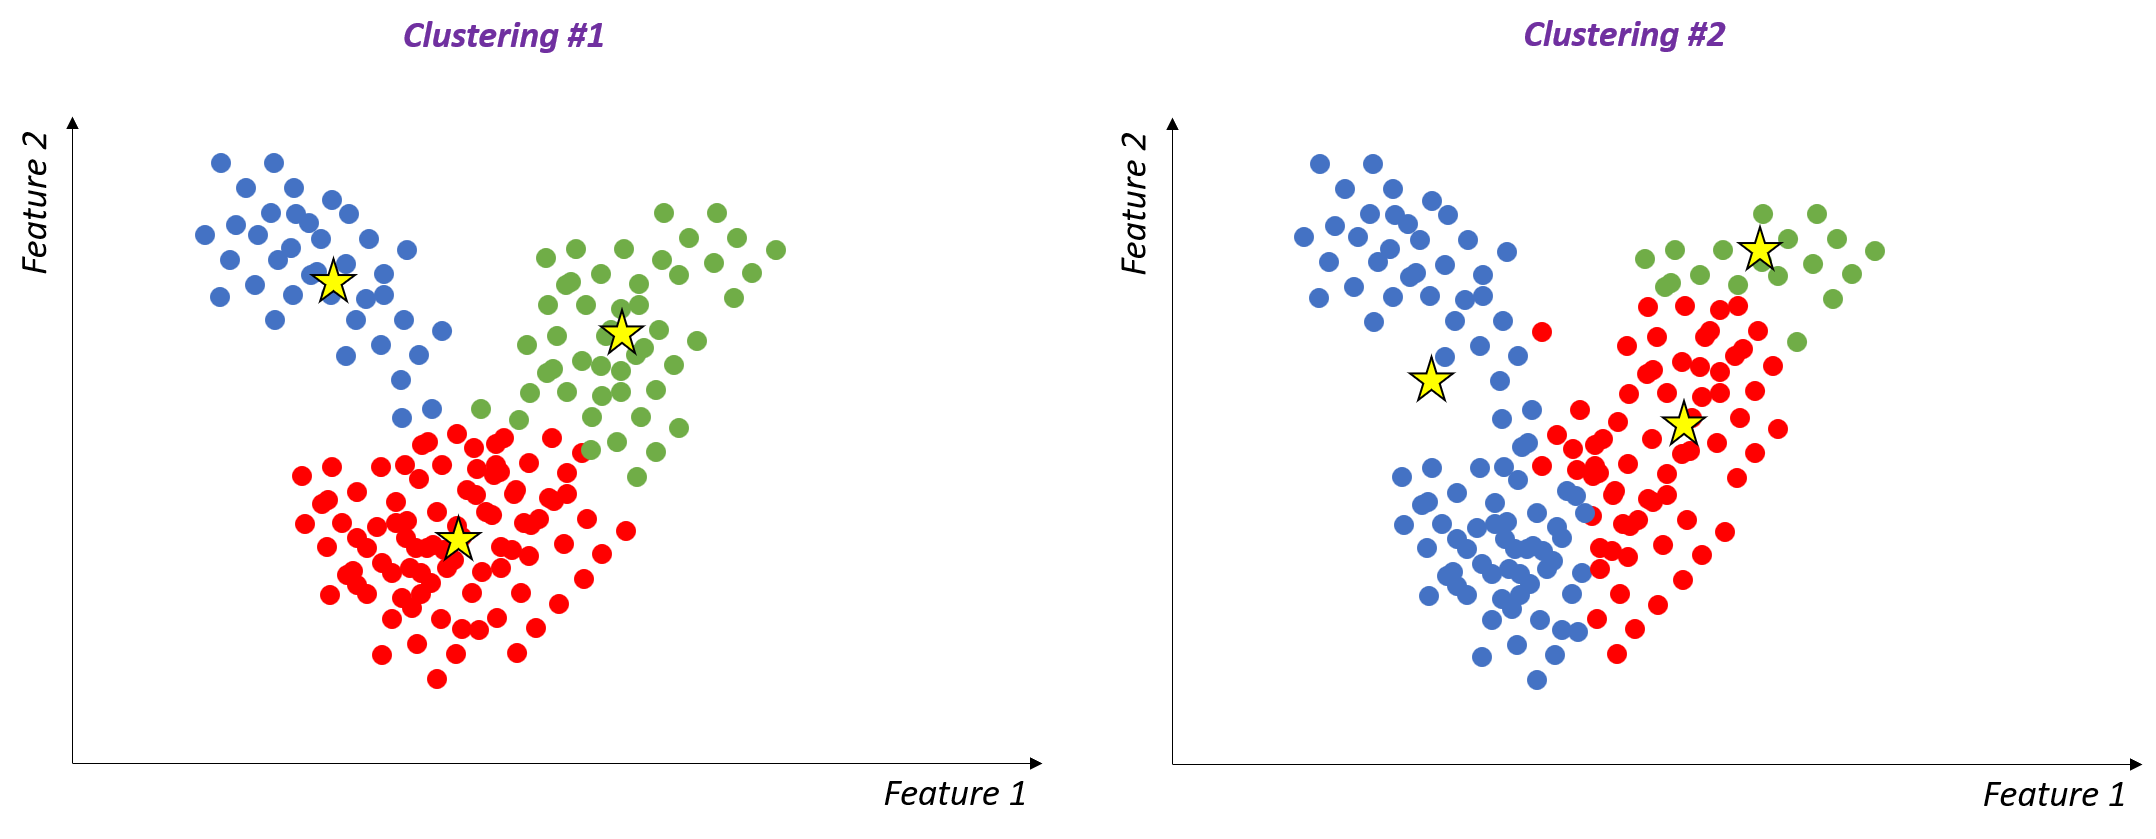
Image montrant deux affectations de clusters différentes pour le même jeu de données.

  • ARI max = 1 → alignement parfait
  • ARI plus faible → différence plus grande entre clusterings
IA explicable en Python

Importance des variables pour l'affectation des clusters


  • Retirer une variable à la fois
  • $\text{Importance}(f) = 1 - \text{ARI (clusters d'origine, clusters modifiés)}$
  • ARI faible → $1 - \text{ARI}$ élevé → variable importante
IA explicable en Python

Importance des variables pour l'affectation des clusters

from sklearn.metrics import adjusted_rand_score

kmeans = KMeans(n_clusters=2).fit(X) original_clusters = kmeans.predict(X)
for i in range(X.shape[1]):
X_reduced = np.delete(X, i, axis=1)
reduced_clusters = kmeans.fit_predict(X_reduced)
importance = 1 - adjusted_rand_score(original_clusters, reduced_clusters) print(f'{df.columns[i]}: {importance}')
age: 0.0
health status: 0.9995376368119572
absences: 0.0
G1: 0.0
G2: 0.6204069909514572
G3: 0.6204069909514572
IA explicable en Python

Passons à la pratique !

IA explicable en Python

Preparing Video For Download...