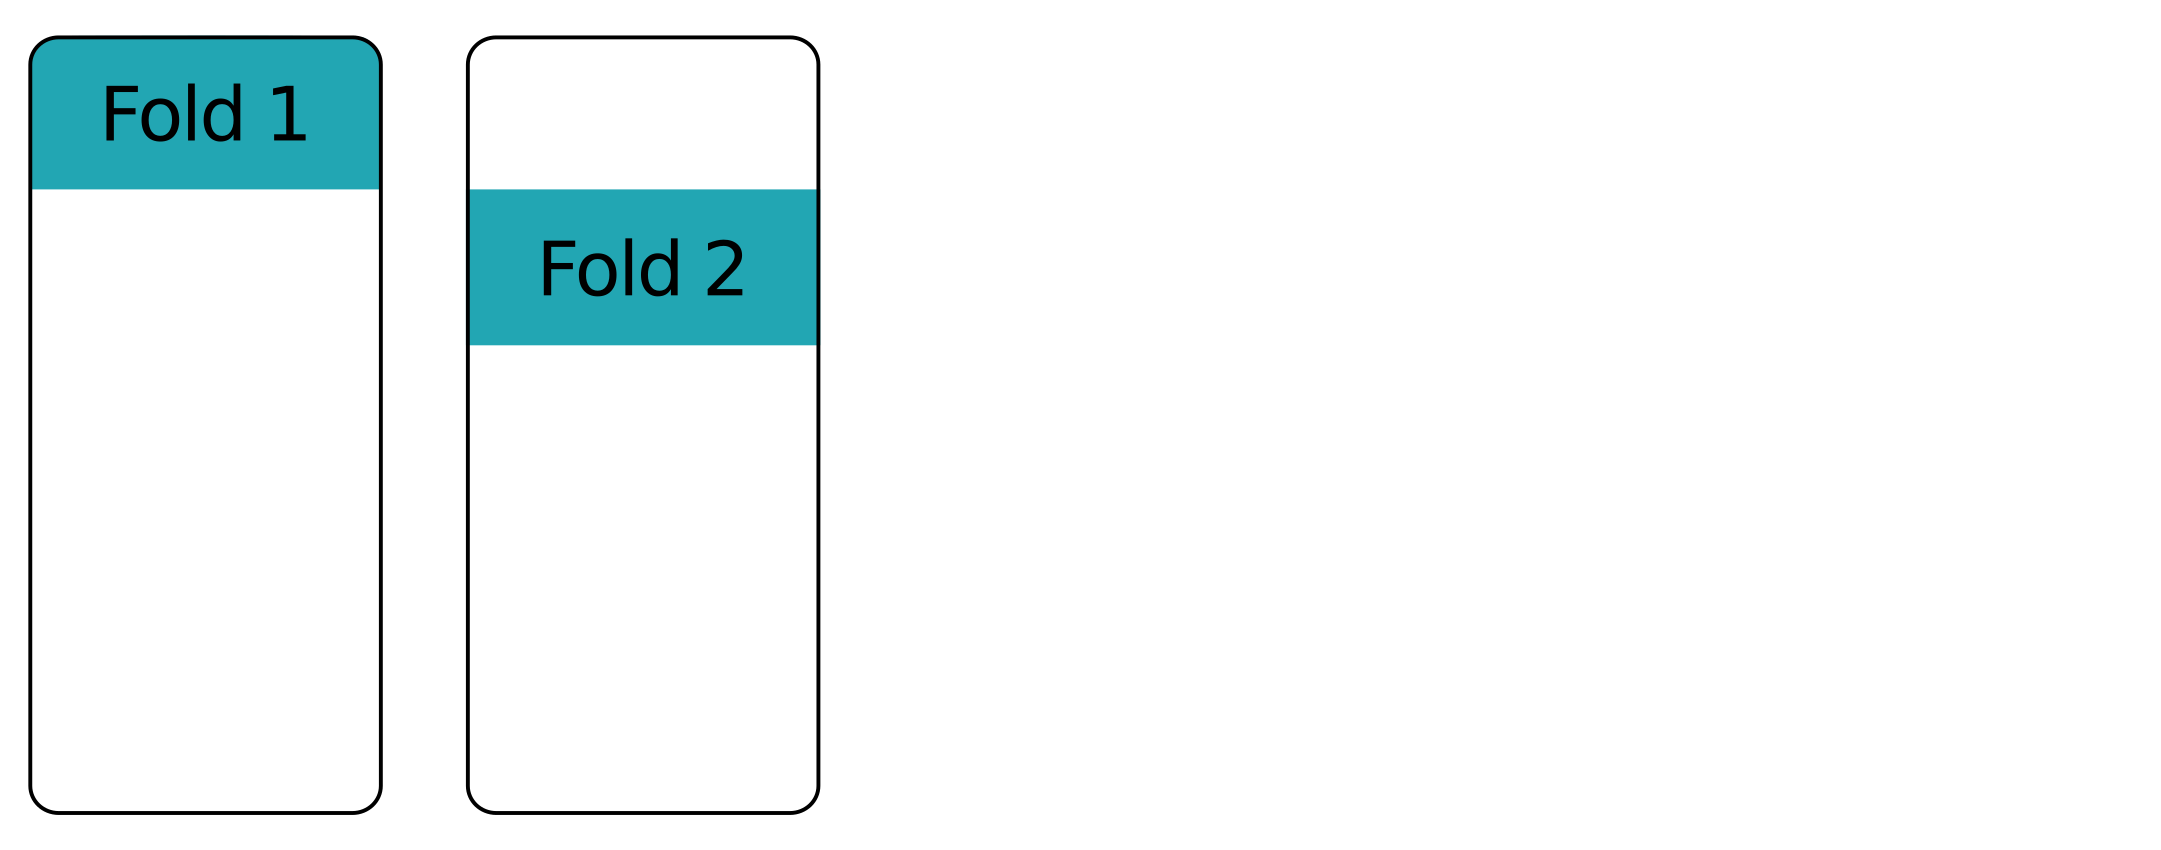Maschinelles Lernen mit PySpark
Andrew Collier
Data Scientist, Fathom Data


cars.select('mass', 'cyl', 'consumption').show(5)
+------+---+-----------+
| mass|cyl|consumption|
+------+---+-----------+
|1451.0| 6| 9.05|
|1129.0| 4| 6.53|
|1399.0| 4| 7.84|
|1147.0| 4| 7.84|
|1111.0| 4| 9.05|
+------+---+-----------+
Ein Objekt zum Trainieren des Modells. Das kann auch eine Pipeline sein.
regression = LinearRegression(labelCol='consumption')
Ein Objekt zur Bewertung der Modellgüte.
evaluator = RegressionEvaluator(labelCol='consumption')
from pyspark.ml.tuning import CrossValidator, ParamGridBuilder
Ein Raster von Parameterwerten (vorerst leer).
params = ParamGridBuilder().build()
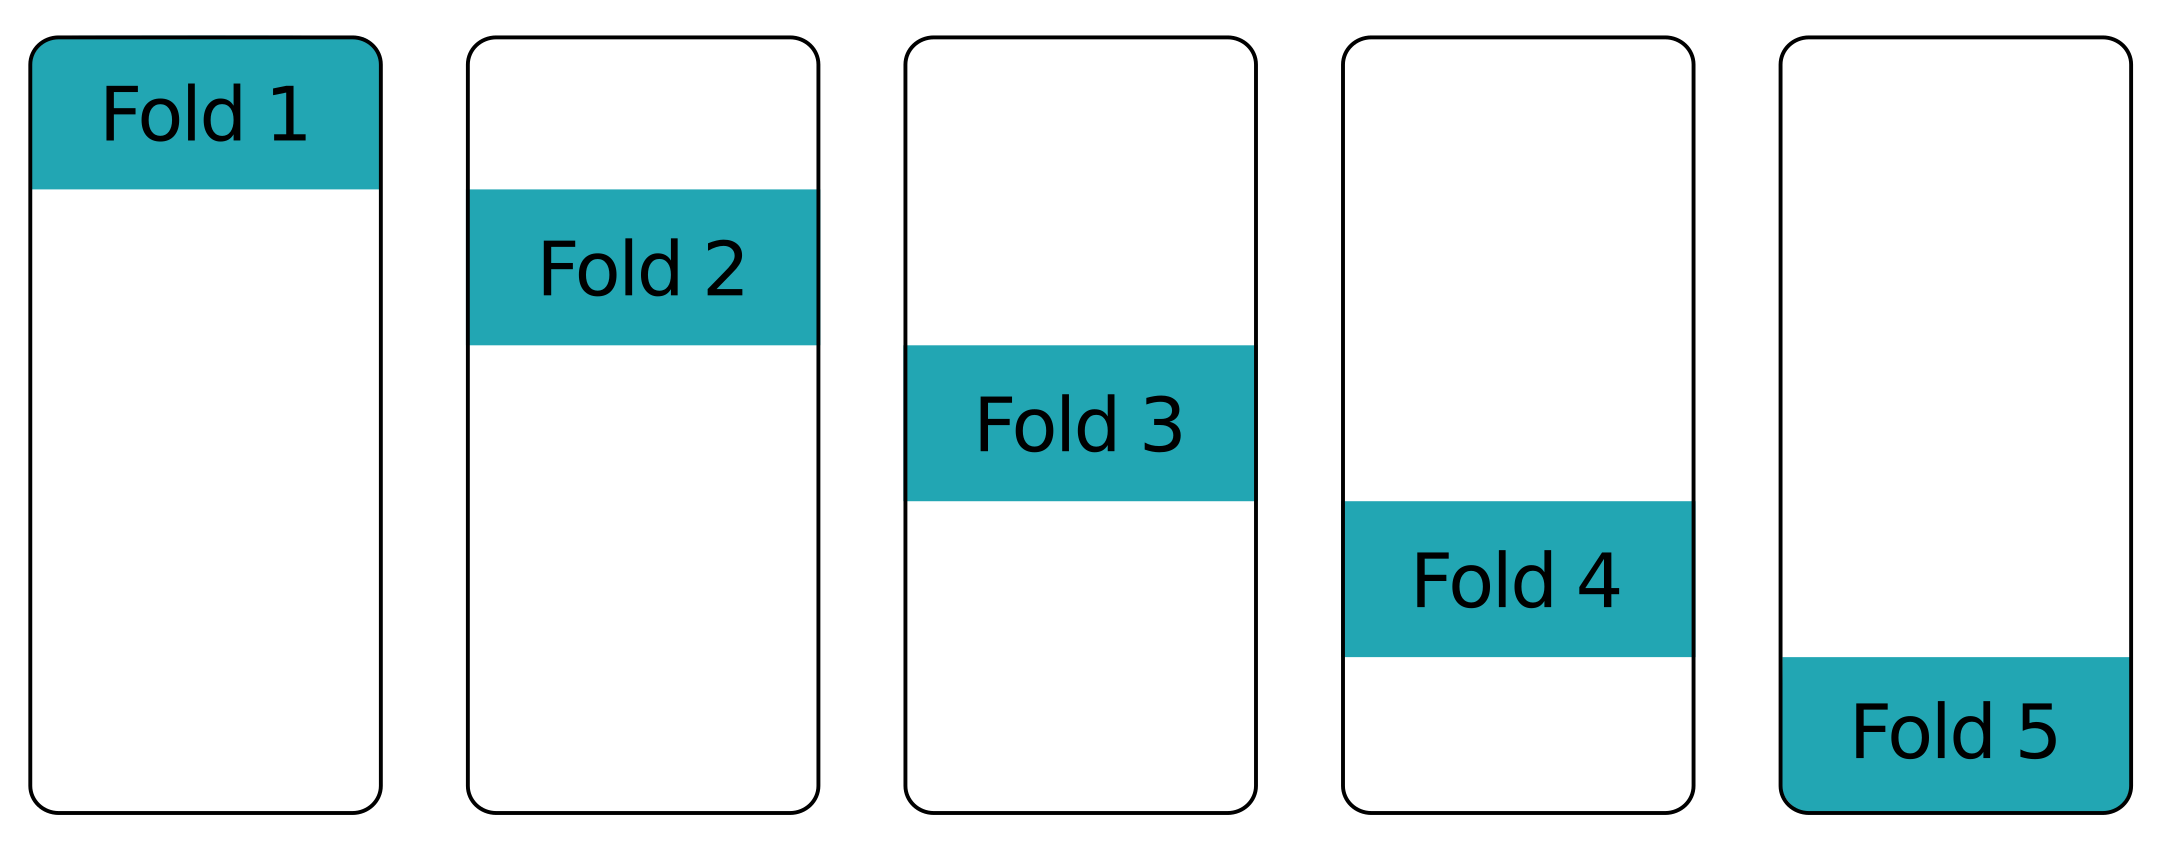
Das Cross-Validation-Objekt.
cv = CrossValidator(estimator=regression,
estimatorParamMaps=params,
evaluator=evaluator,
numFolds=10, seed=13)
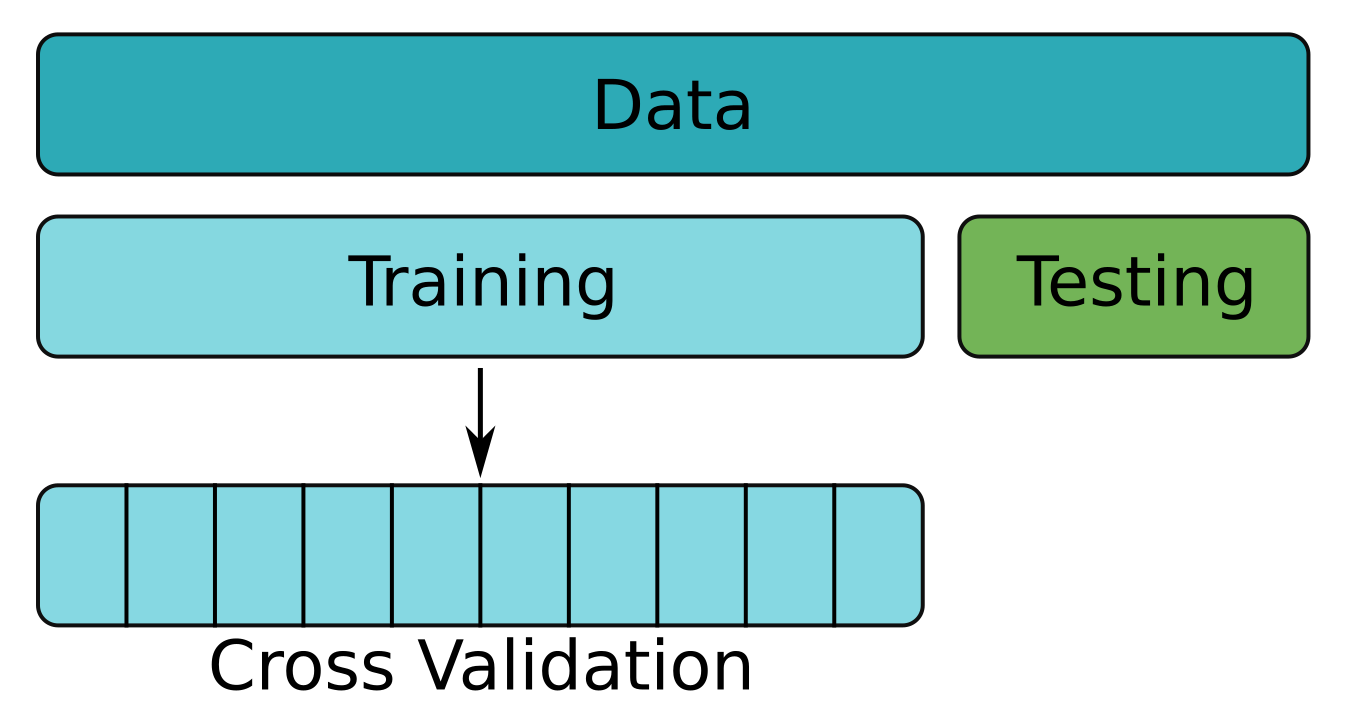
Wende Cross-Validation auf die Trainingsdaten an.
cv = cv.fit(cars_train)
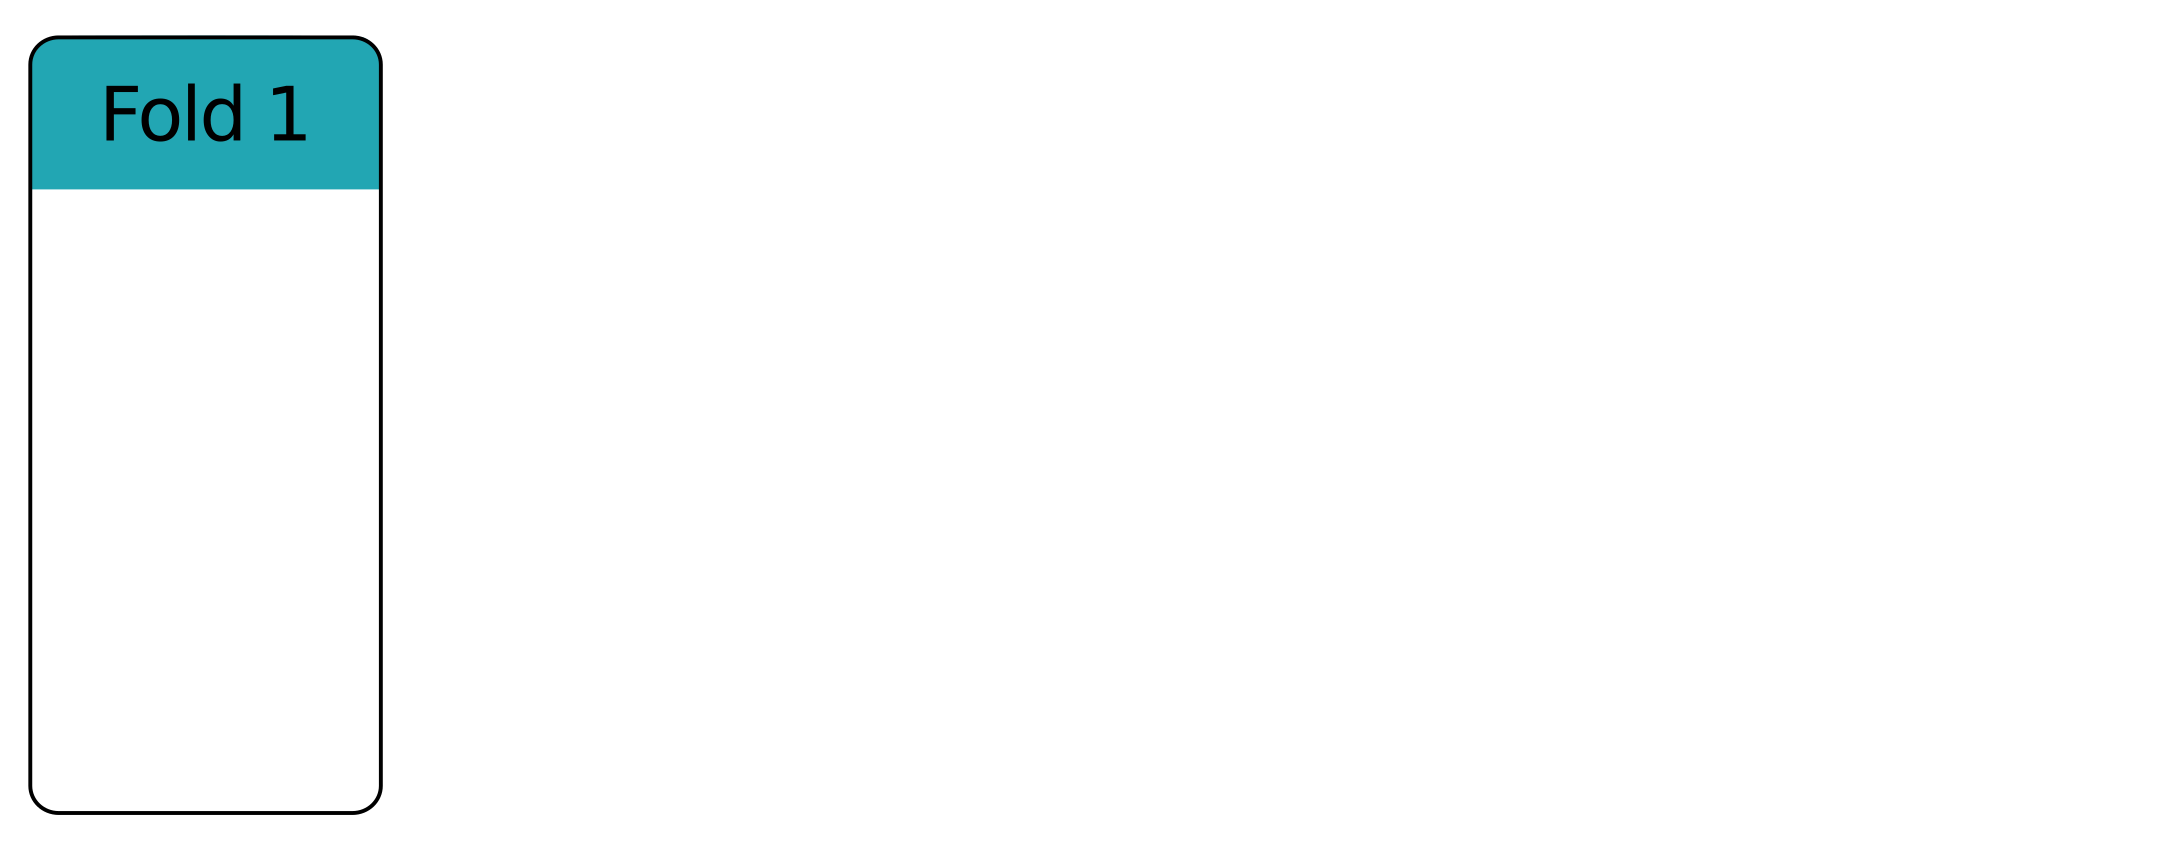
Wie groß ist der durchschnittliche RMSE über die Folds?
cv.avgMetrics
[0.800663722151572]
Triff Vorhersagen auf den ursprünglichen Testdaten.
evaluator.evaluate(cv.transform(cars_test))
# RMSE auf Testdaten
0.745974203928479
Deutlich kleiner als der crossvalidierte RMSE.
# RMSE aus Cross-Validation
0.800663722151572
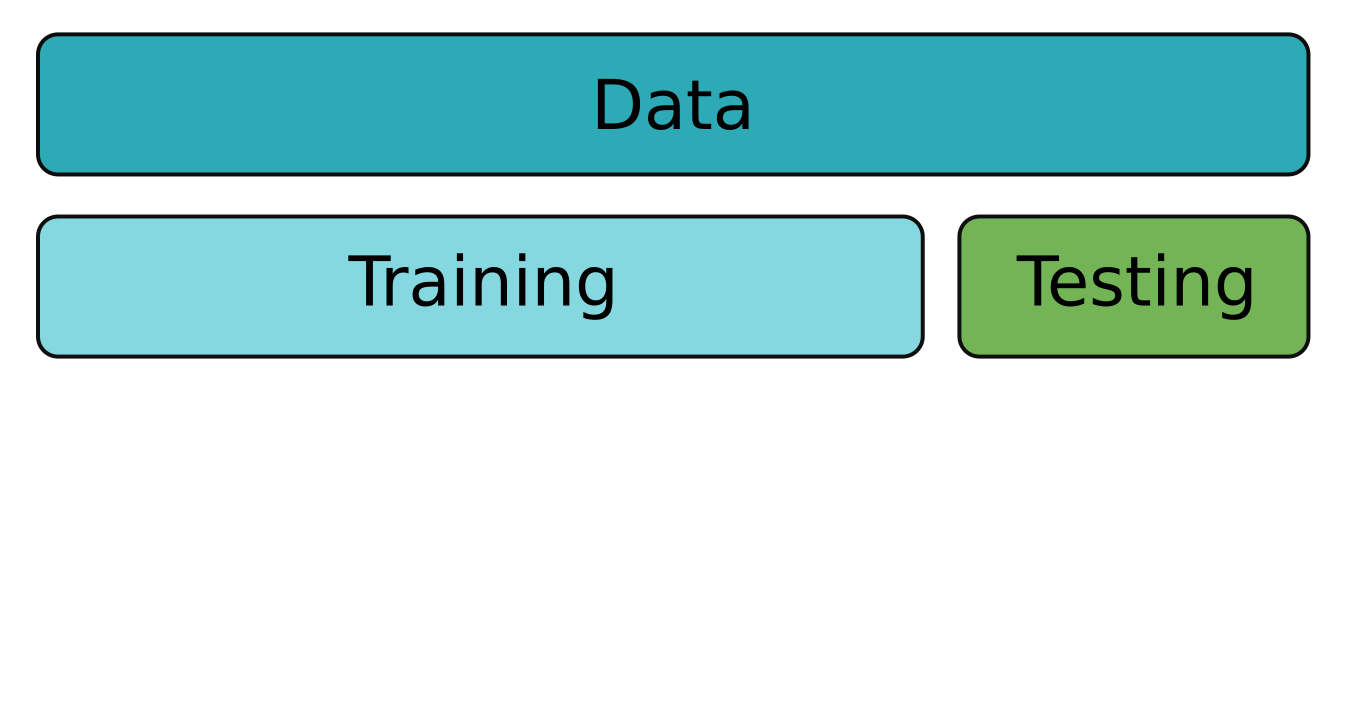
Ein einfacher Train-Test-Split hätte die Modellgüte zu optimistisch dargestellt.
Maschinelles Lernen mit PySpark