Pipeline

Maschinelles Lernen mit PySpark

Andrew Collier

Data Scientist, Fathom Data

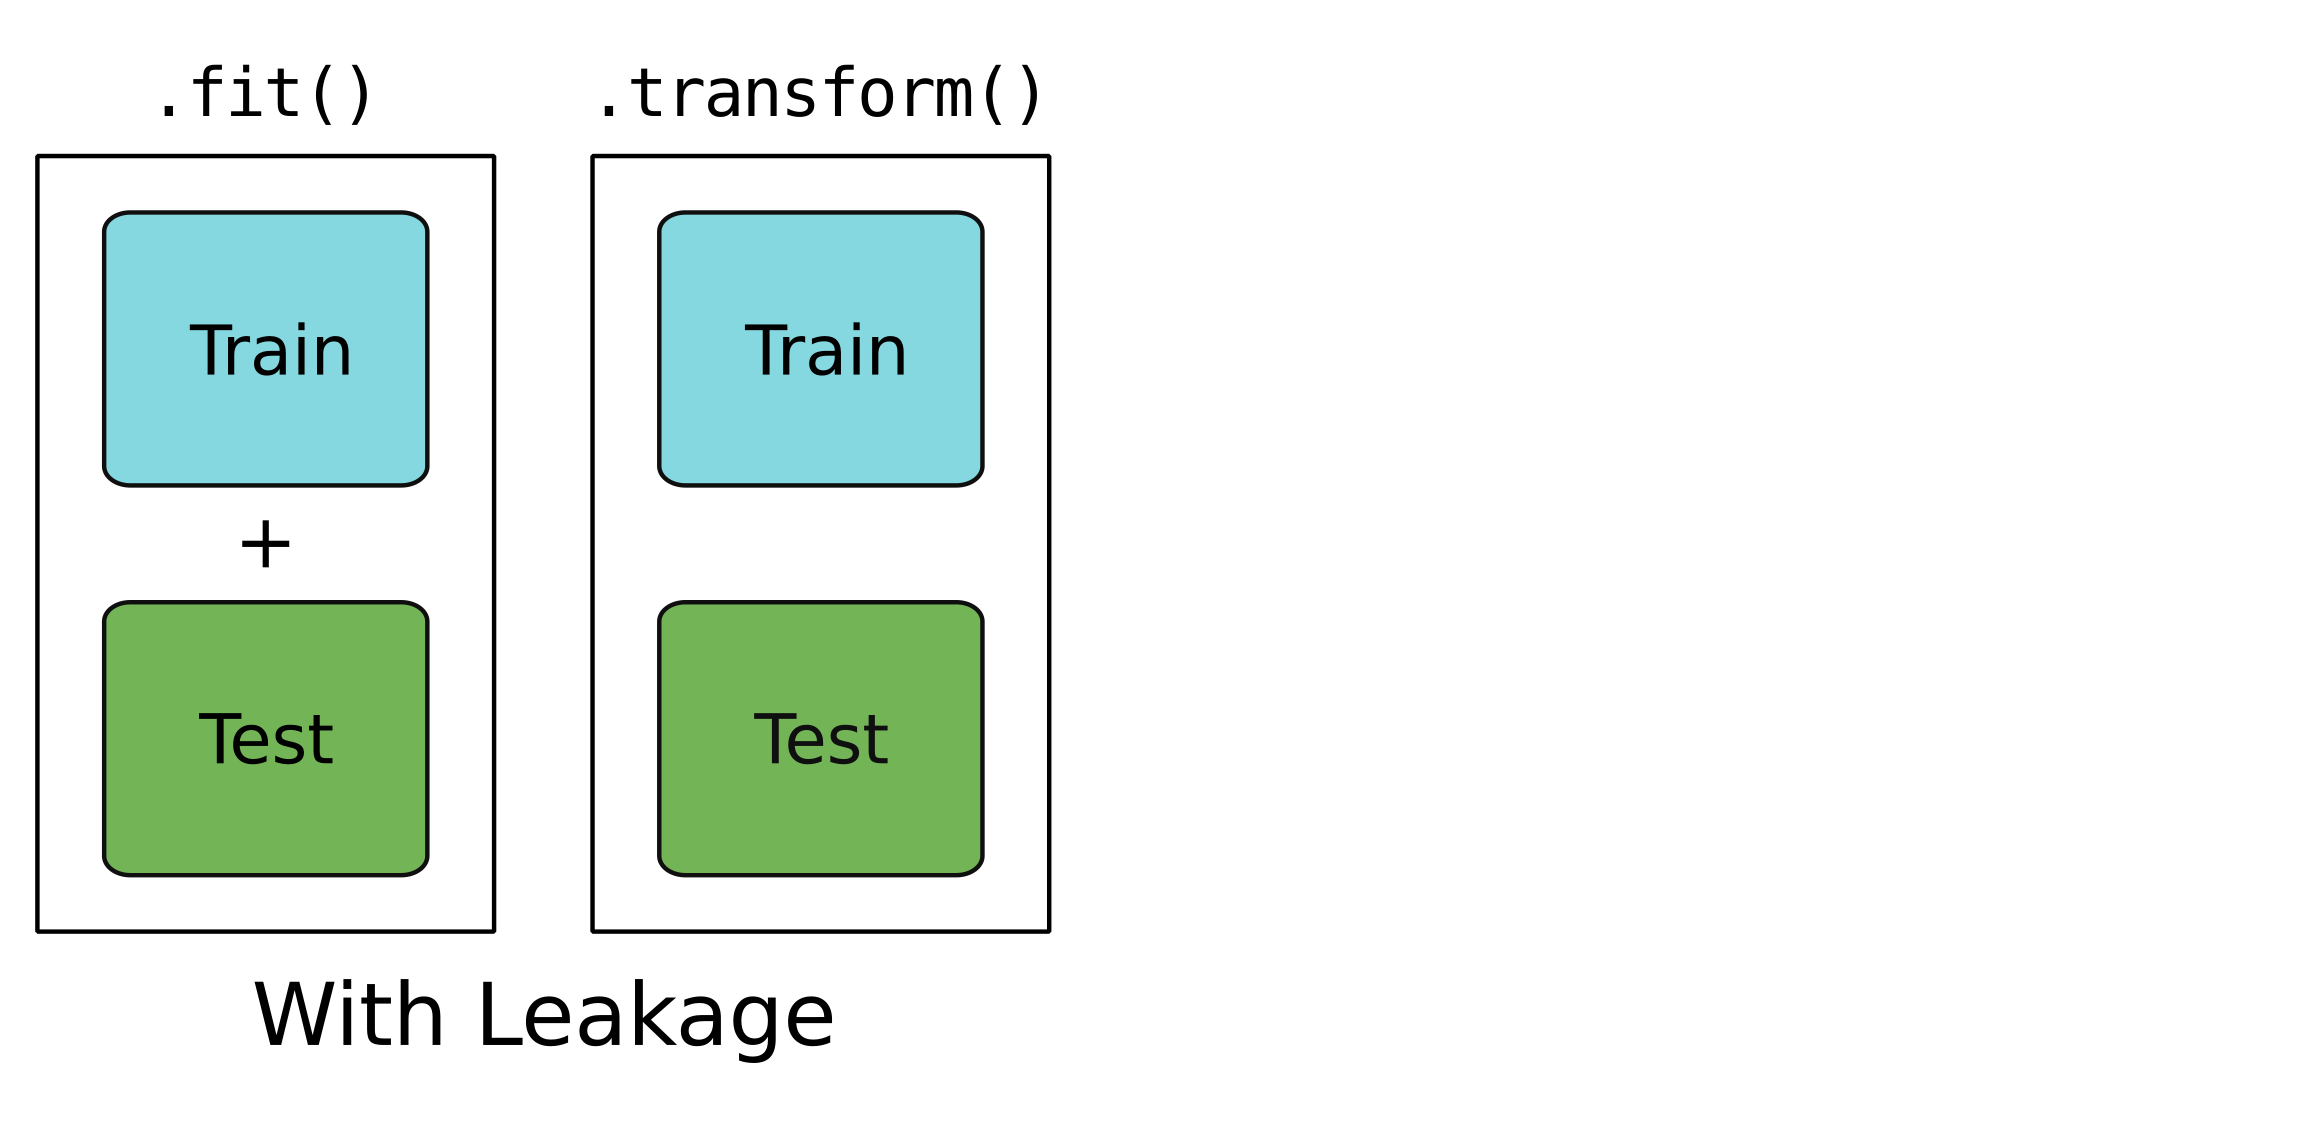
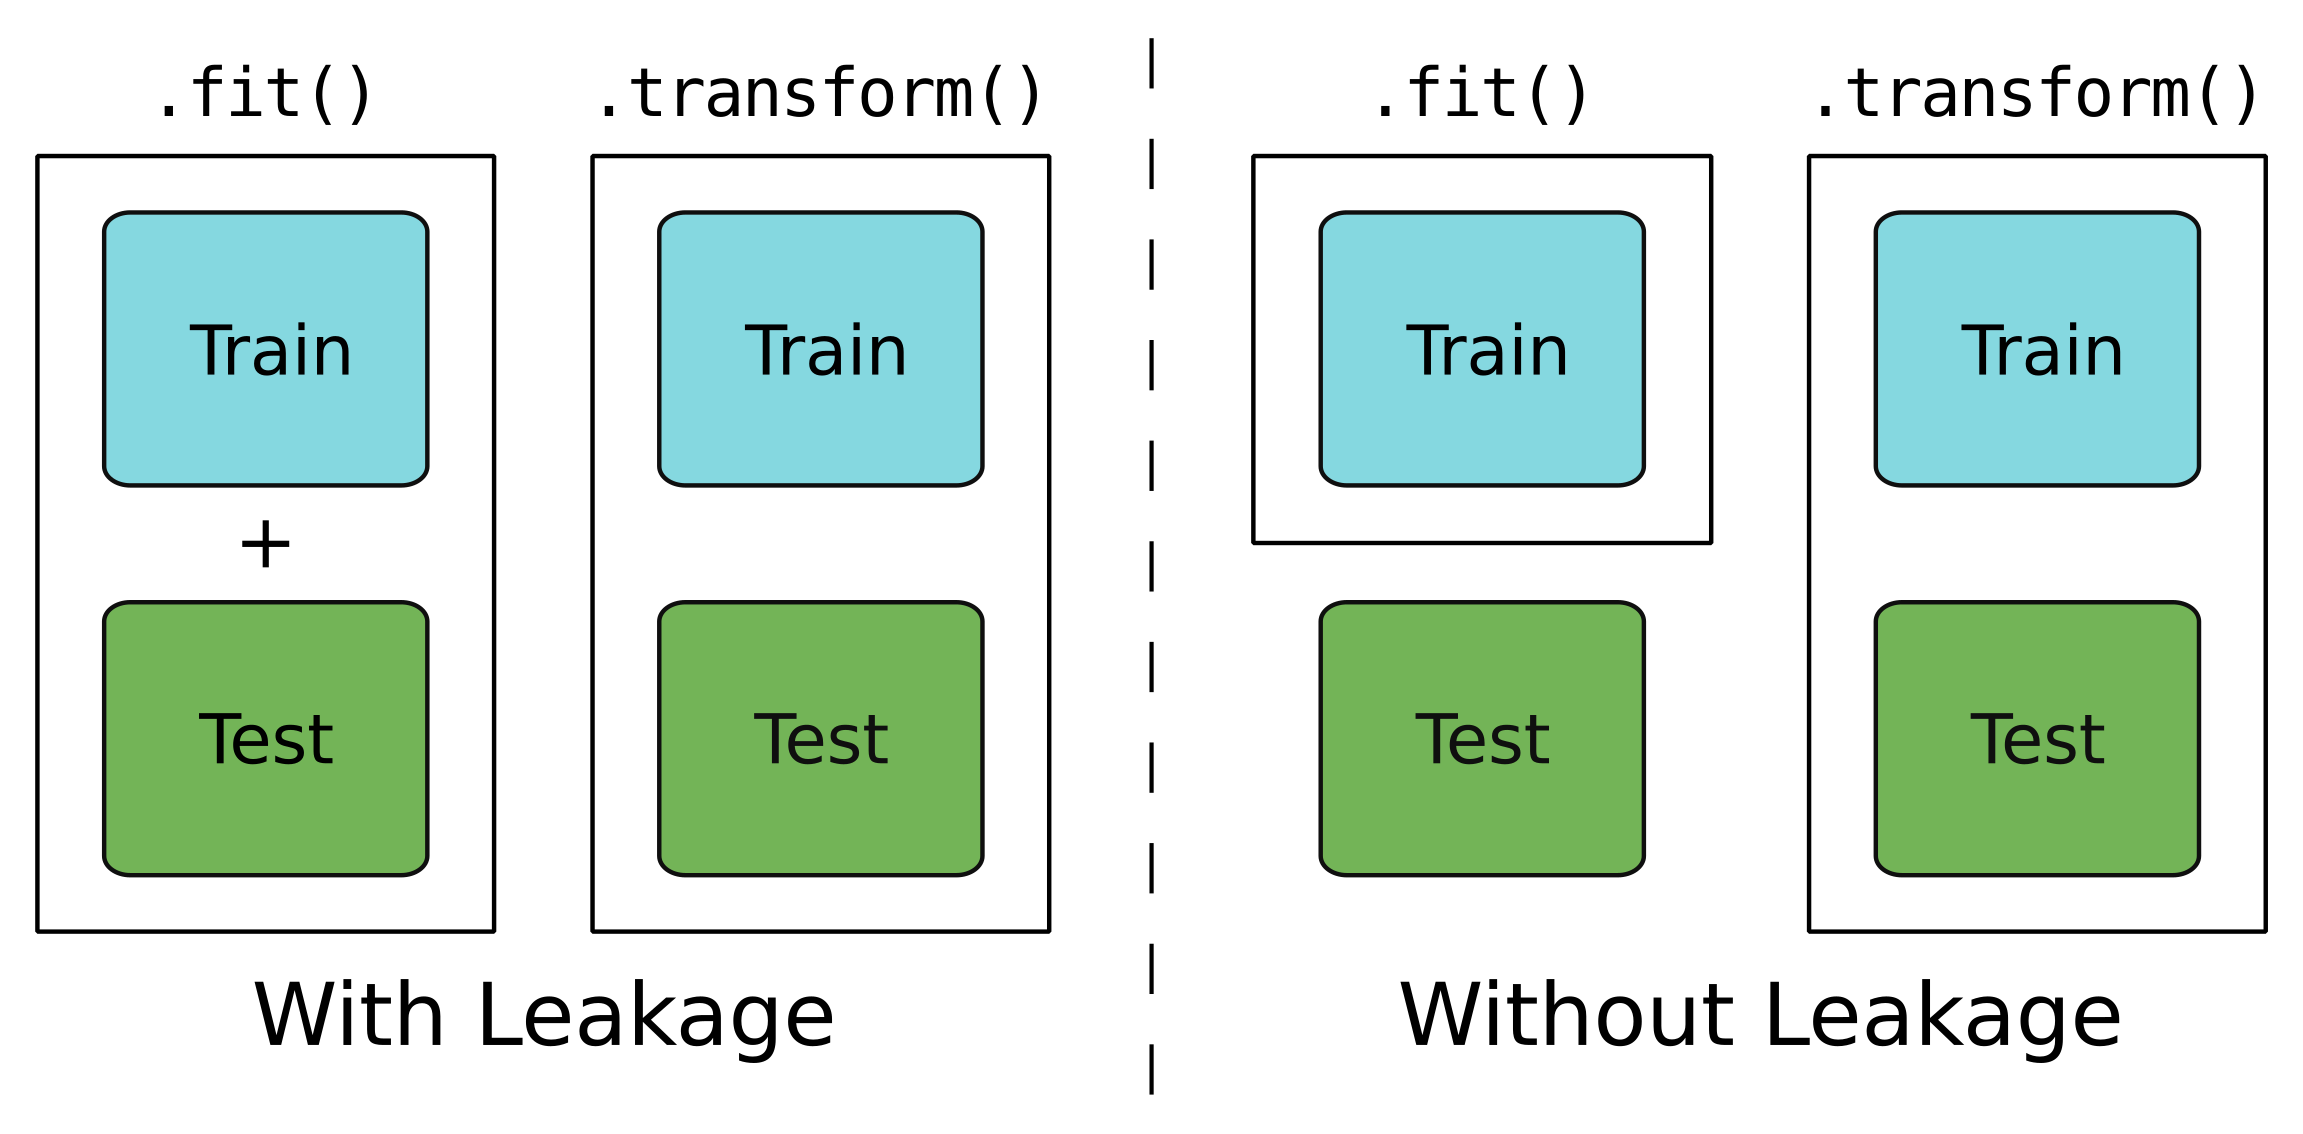
Leakage?

Die Methode fit()

Nur für Trainingsdaten.

Die Methode transform()

Für Test- und Trainingsdaten.

Maschinelles Lernen mit PySpark

Ein leaky Modell

Modell, bei dem Testdaten zum Training genutzt werden

Maschinelles Lernen mit PySpark

Ein dichtes Modell

Modell, bei dem nur Trainingsdaten zum Training genutzt werden

Maschinelles Lernen mit PySpark

Pipeline

Eine Pipeline besteht aus einer Reihe von Schritten.

Eine Pipeline mit mehreren Stufen

Du könntest jeden Schritt einzeln anwenden – oder gleich die ganze Pipeline!

Maschinelles Lernen mit PySpark

Autos-Modell: Schritte

indexer = StringIndexer(inputCol='type', outputCol='type_idx')

onehot = OneHotEncoder(inputCols=['type_idx'], outputCols=['type_dummy'])
assemble = VectorAssembler( inputCols=['mass', 'cyl', 'type_dummy'], outputCol='features' )
regression = LinearRegression(labelCol='consumption')
Maschinelles Lernen mit PySpark

Autos-Modell: Schritte anwenden

Trainingsdaten

indexer = indexer.fit(cars_train)
cars_train = indexer.transform(cars_train)
onehot = onehot.fit(cars_train)
cars_train = onehot.transform(cars_train)
cars_train = assemble.transform(cars_train)
# Modell auf Trainingsdaten fitten
regression = regression.fit(cars_train)

Testdaten

cars_test  = indexer.transform(cars_test)
cars_test  = onehot.transform(cars_test)
cars_test  = assemble.transform(cars_test)
# Vorhersagen für Testdaten erstellen
predictions = regression.transform(cars_test)
Maschinelles Lernen mit PySpark

Autos-Modell: Pipeline

Schritte in einer Pipeline kombinieren.

from pyspark.ml import Pipeline

pipeline = Pipeline(stages=[indexer, onehot, assemble, regression])

Trainingsdaten

pipeline = pipeline.fit(cars_train)

Testdaten

predictions = pipeline.transform(cars_test)
Maschinelles Lernen mit PySpark

Autos-Modell: Stufen

Auf einzelne Stufen per Attribut .stages zugreifen.

# Das LinearRegression-Objekt (vierte Stufe -> Index 3)
pipeline.stages[3]

print(pipeline.stages[3].intercept)
4.19433571782916
print(pipeline.stages[3].coefficients)
DenseVector([0.0028, 0.2705, -1.1813, -1.3696, -1.1751, -1.1553, -1.8894])
Maschinelles Lernen mit PySpark

Pipelines straffen den Workflow!

Maschinelles Lernen mit PySpark

Preparing Video For Download...