Apprentissage automatique avec PySpark
Andrew Collier
Data Scientist, Fathom Data
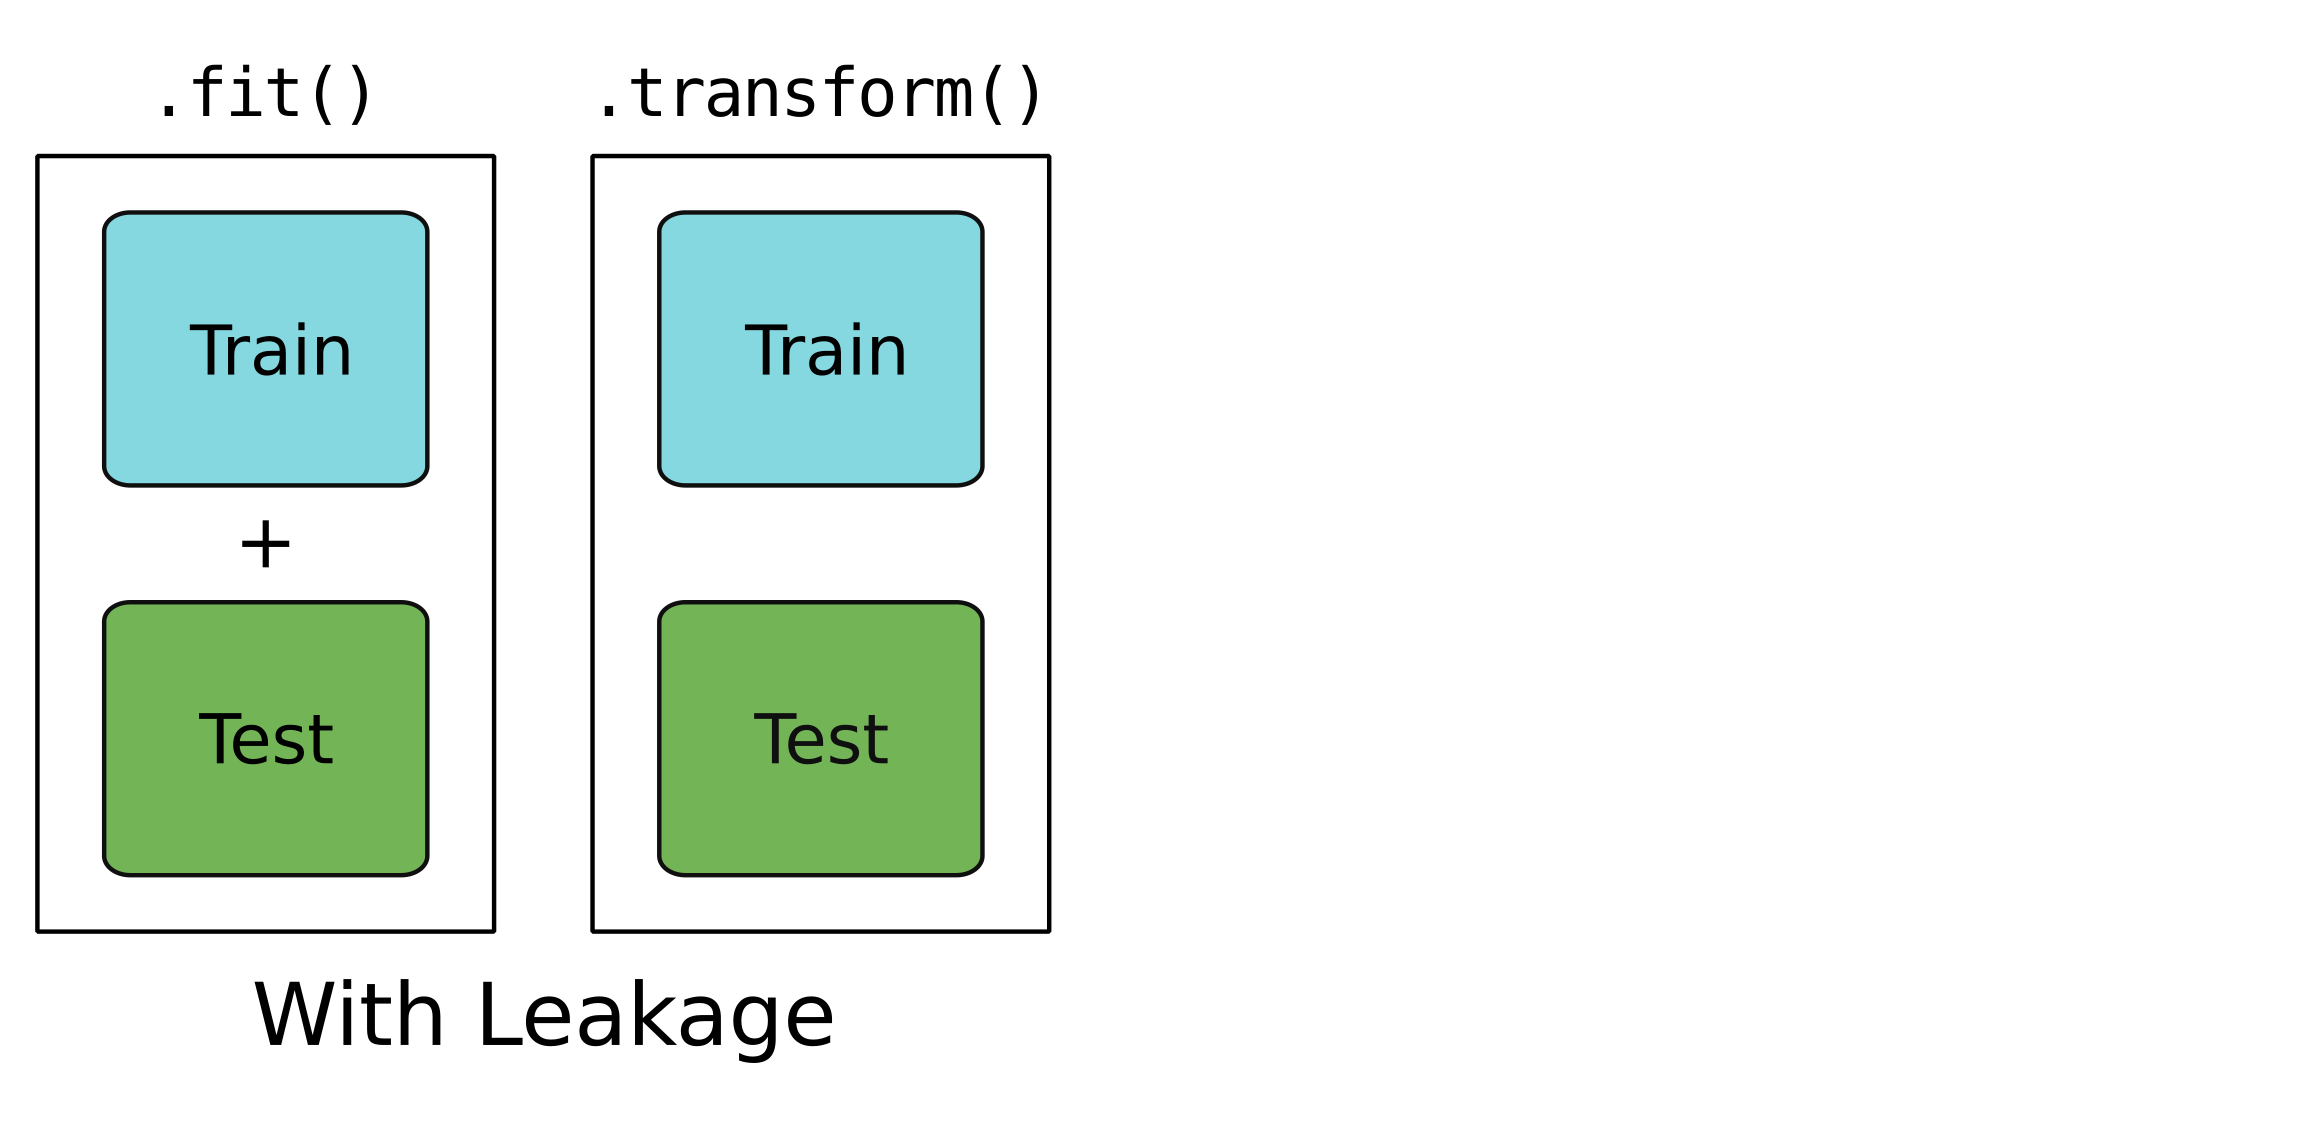
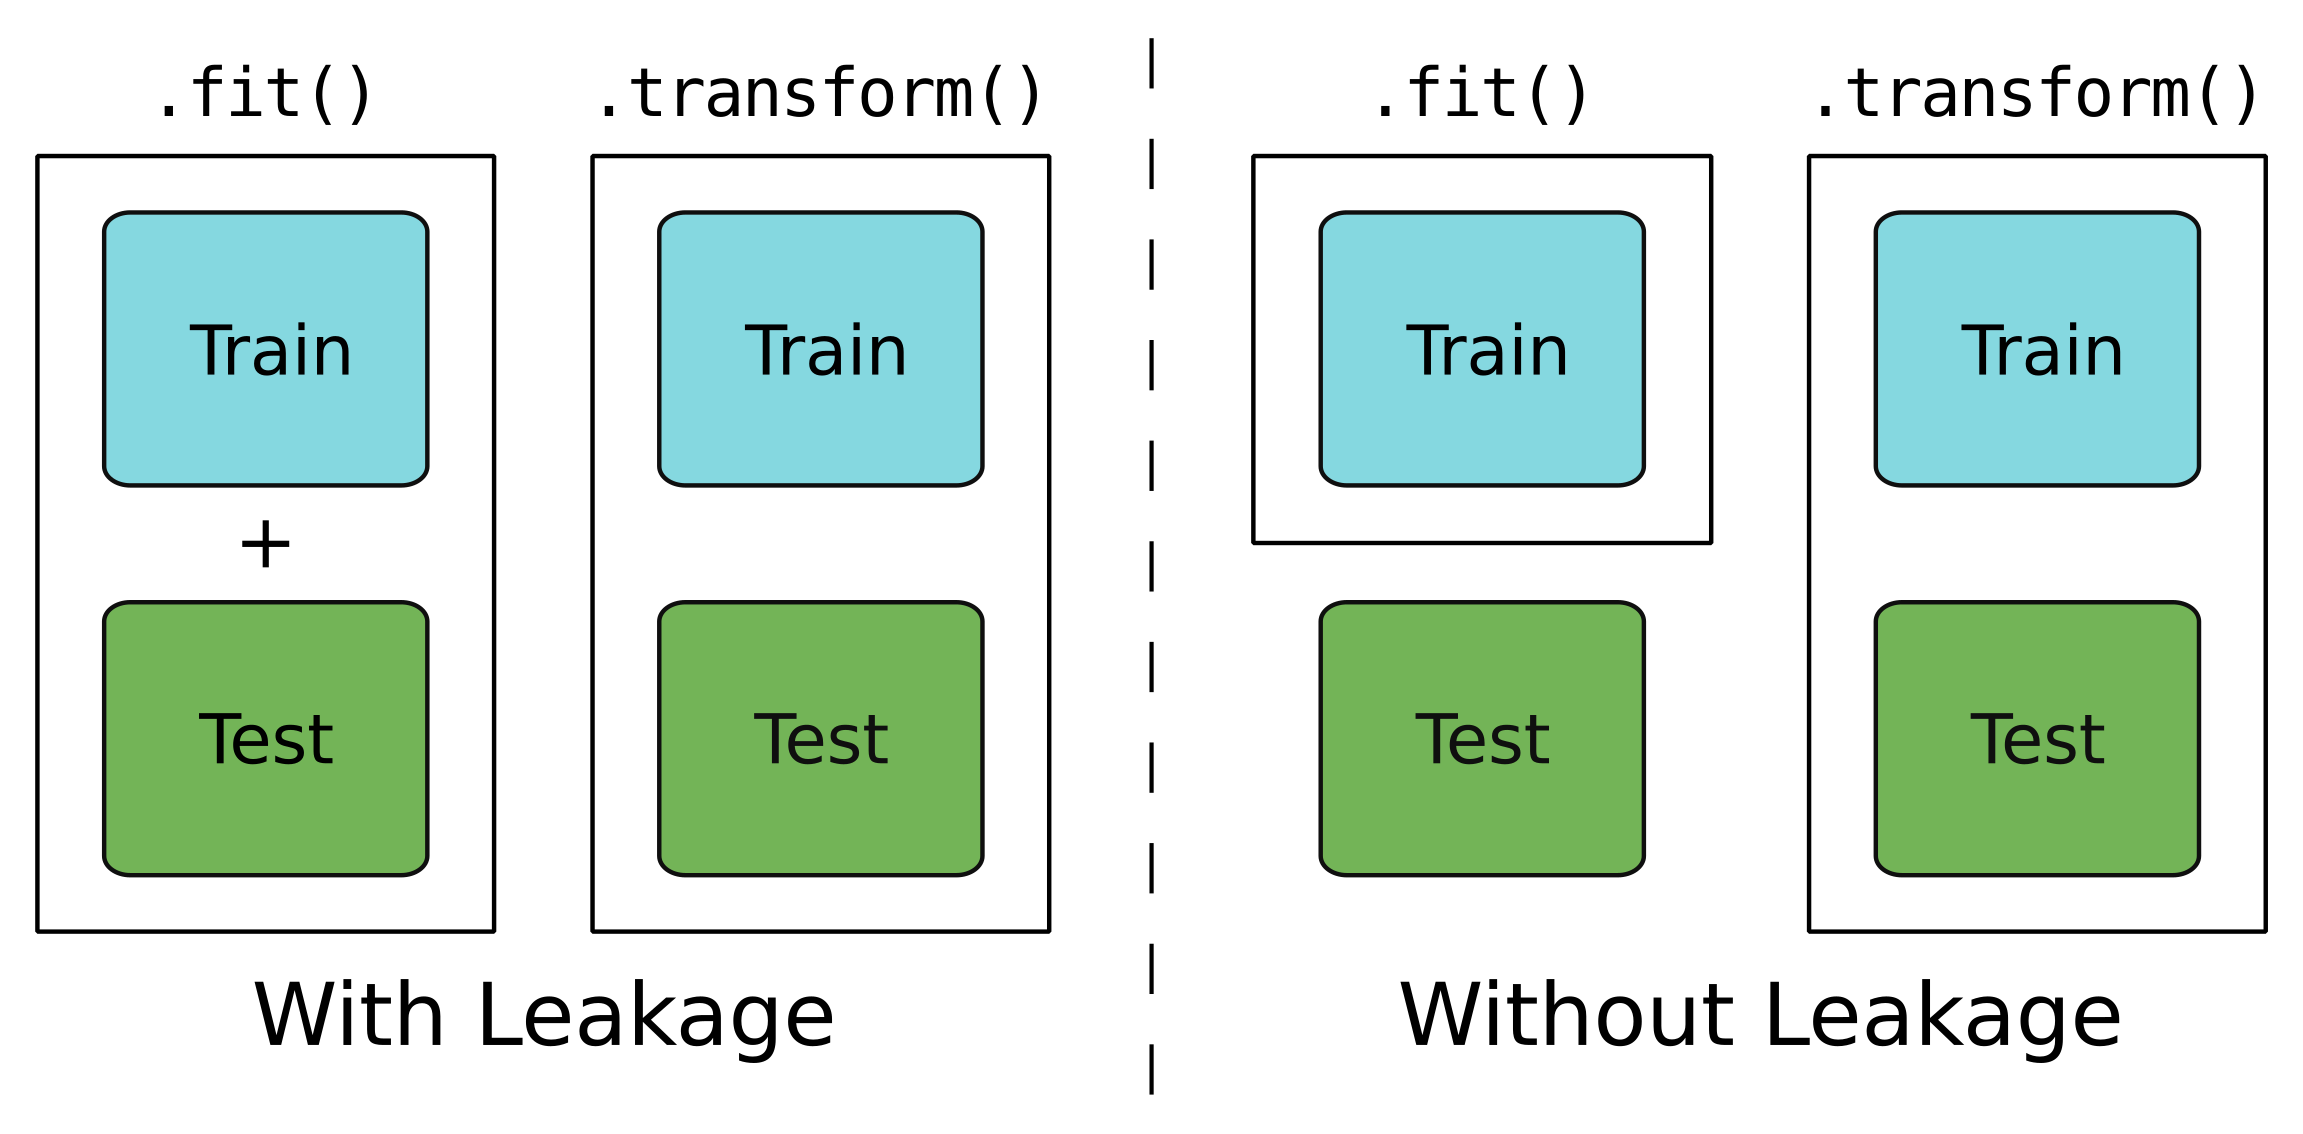
Uniquement pour les données d'entraînement.
Pour les données de test et d'entraînement.


Un pipeline est une suite d'opérations.
Vous pouvez appliquer chaque opération séparément… ou exécuter tout le pipeline !
indexer = StringIndexer(inputCol='type', outputCol='type_idx')onehot = OneHotEncoder(inputCols=['type_idx'], outputCols=['type_dummy'])assemble = VectorAssembler( inputCols=['mass', 'cyl', 'type_dummy'], outputCol='features' )regression = LinearRegression(labelCol='consumption')
indexer = indexer.fit(cars_train)
cars_train = indexer.transform(cars_train)
onehot = onehot.fit(cars_train)
cars_train = onehot.transform(cars_train)
cars_train = assemble.transform(cars_train)
# Fit model to training data
regression = regression.fit(cars_train)
cars_test = indexer.transform(cars_test)
cars_test = onehot.transform(cars_test)
cars_test = assemble.transform(cars_test)
# Make predictions on testing data
predictions = regression.transform(cars_test)
Regroupez les étapes dans un pipeline.
from pyspark.ml import Pipeline
pipeline = Pipeline(stages=[indexer, onehot, assemble, regression])
Données d'entraînement
pipeline = pipeline.fit(cars_train)
Données de test
predictions = pipeline.transform(cars_test)
Accédez aux étapes via l'attribut .stages.
# The LinearRegression object (fourth stage -> index 3) pipeline.stages[3]print(pipeline.stages[3].intercept)
4.19433571782916
print(pipeline.stages[3].coefficients)
DenseVector([0.0028, 0.2705, -1.1813, -1.3696, -1.1751, -1.1553, -1.8894])
Apprentissage automatique avec PySpark