Regroupement en classes et ingénierie

Apprentissage automatique avec PySpark

Andrew Collier

Data Scientist, Fathom Data

Regroupement en classes

Regrouper des valeurs continues en classes

Apprentissage automatique avec PySpark

Classer les tailles en groupes

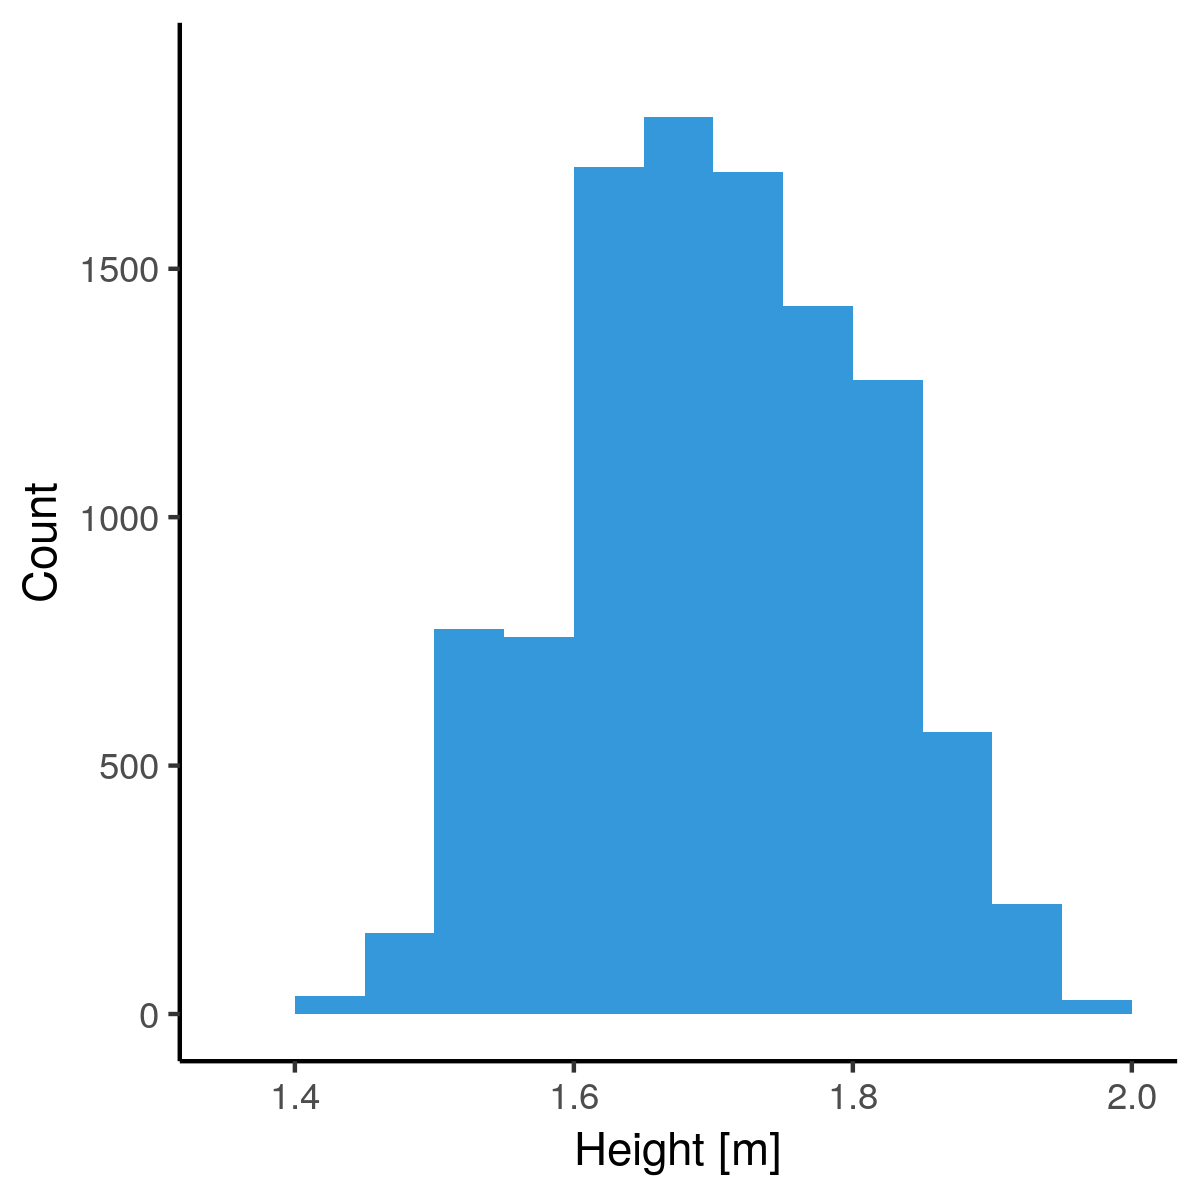
Un histogramme des tailles

+------+
|height|
+------+
|  1.42|
|  1.45|
|  1.47|
|  1.50|
|  1.52|
|  1.57|
|  1.60|
|  1.75|
|  1.85|
|  1.88|
+------+
Apprentissage automatique avec PySpark

Classer les tailles en groupes

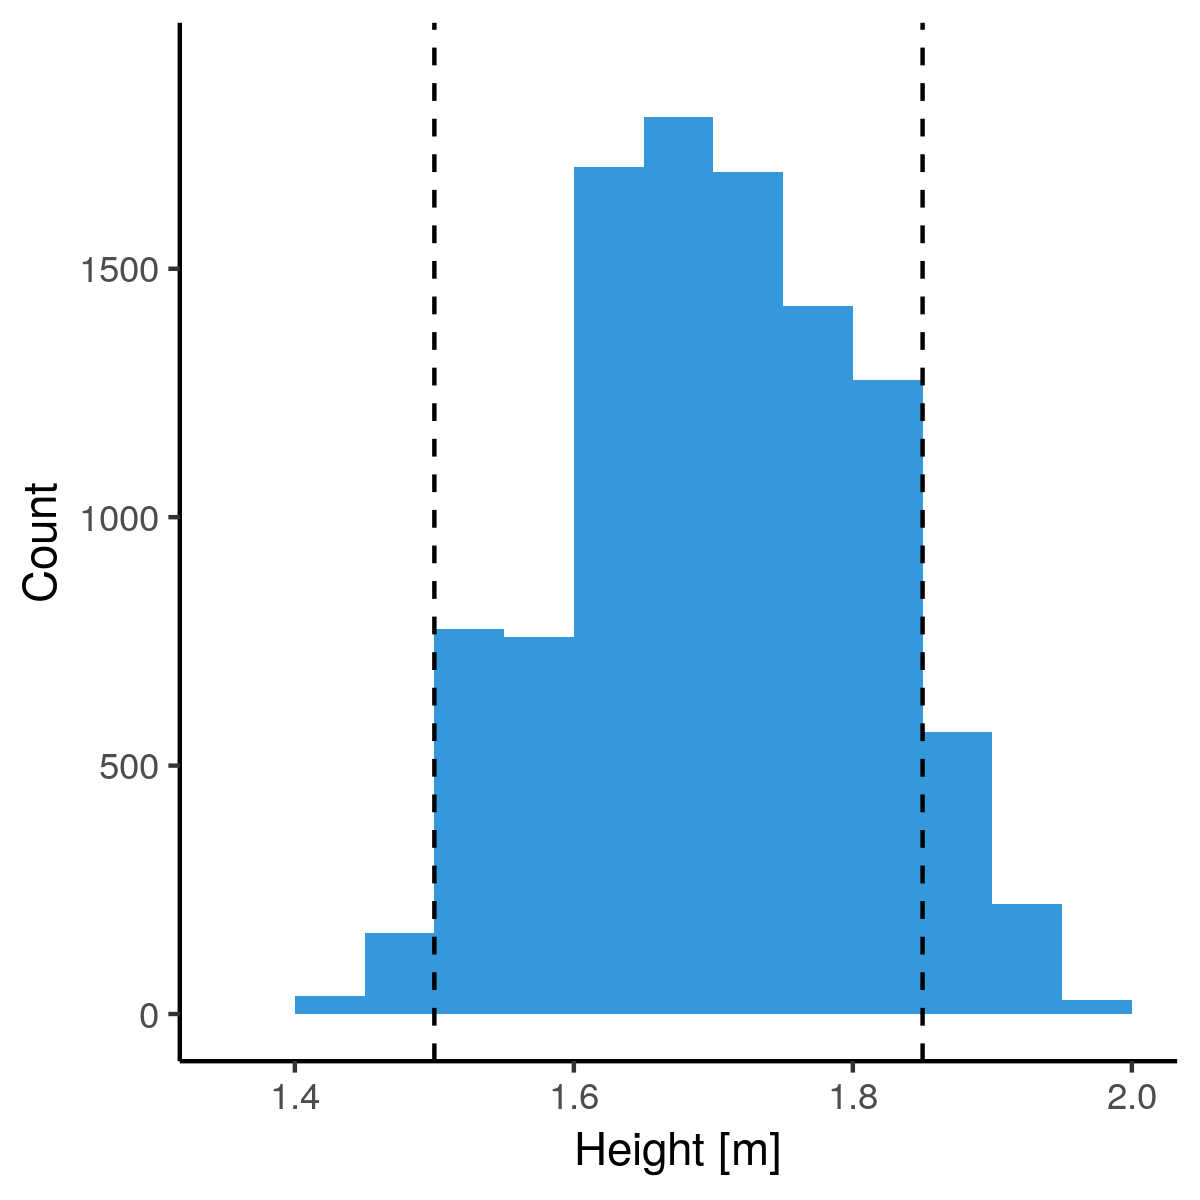
Un histogramme des tailles avec intervalles

+------+
|height|
+------+
|  1.42|
|  1.45|
|  1.47|
|  1.50|
|  1.52|
|  1.57|
|  1.60|
|  1.75|
|  1.85|
|  1.88|
+------+
Apprentissage automatique avec PySpark

Classer les tailles en groupes

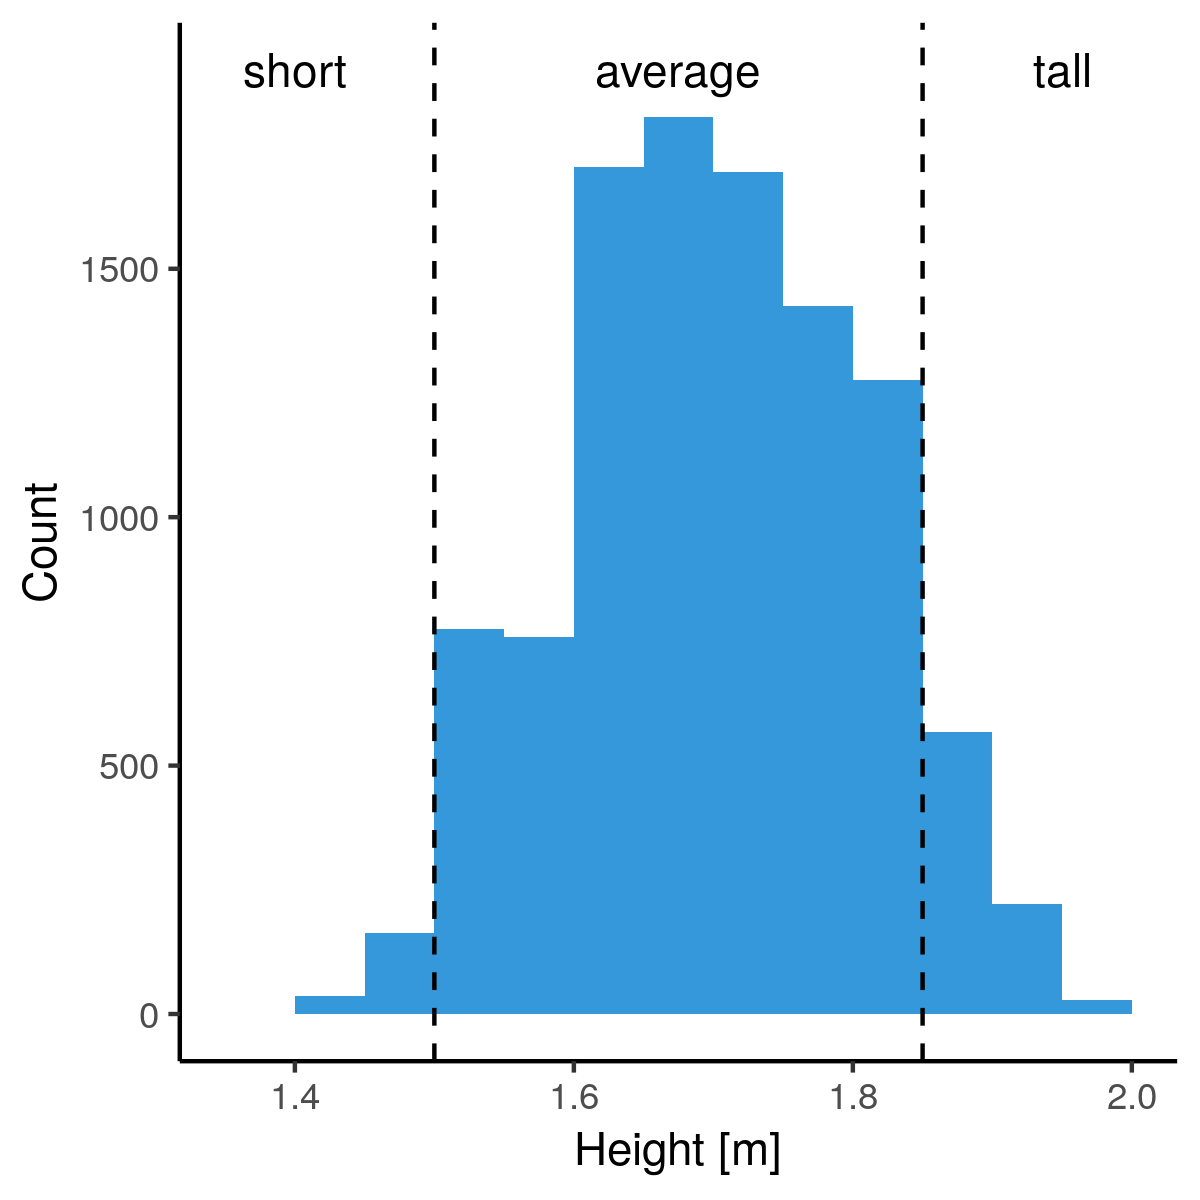
Un histogramme des tailles avec intervalles et libellés

+------+
|height|
+------+
|  1.42|
|  1.45|
|  1.47|
|  1.50|
|  1.52|
|  1.57|
|  1.60|
|  1.75|
|  1.85|
|  1.88|
+------+
Apprentissage automatique avec PySpark

Classer les tailles en groupes

Un histogramme des tailles avec intervalles et libellés

+------+----------+
|height|height_bin|
+------+----------+
|  1.42|     short|
|  1.45|     short|
|  1.47|     short|
|  1.50|     short|
|  1.52|   average|
|  1.57|   average|
|  1.60|   average|
|  1.75|   average|
|  1.85|      tall|
|  1.88|      tall|
+------+----------+
Apprentissage automatique avec PySpark

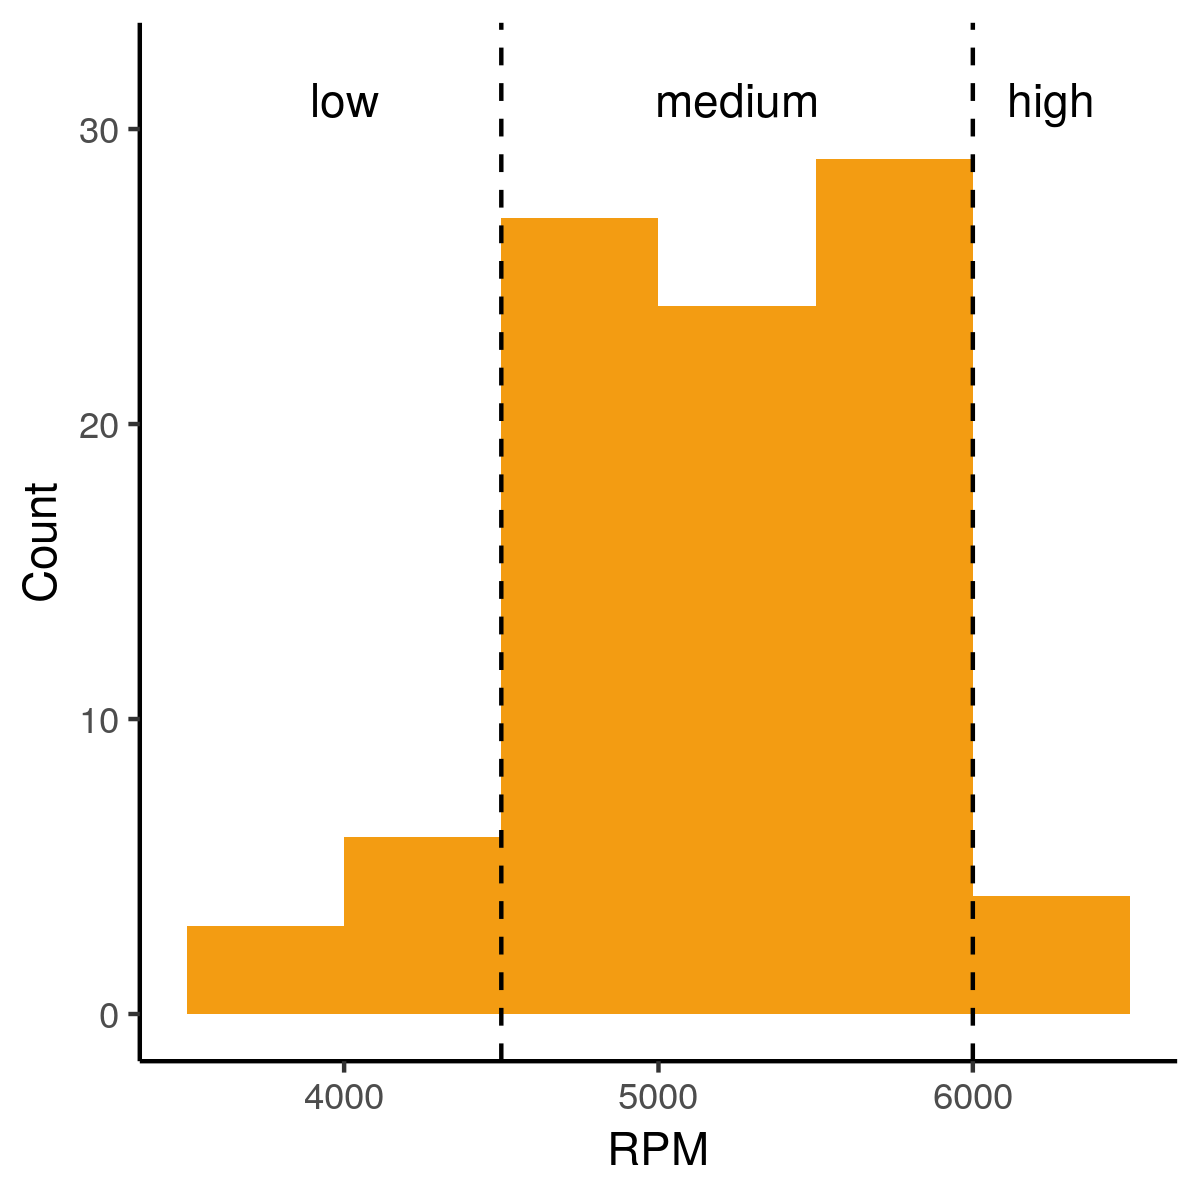
Histogramme des RPM

Le régime moteur (RPM) présente des coupures « naturelles » :

  • $\text{RPM} < 4500$ — bas
  • $\text{RPM} > 6000$ — haut
  • sinon — moyen.

Un histogramme des RPM avec intervalles et libellés

Apprentissage automatique avec PySpark

Classes de RPM

from pyspark.ml.feature import Bucketizer

bucketizer = Bucketizer(splits=[3500, 4500, 6000, 6500],
                        inputCol="rpm",
                        outputCol="rpm_bin")

Appliquer les classes à la colonne rpm.

bucketed = bucketizer.transform(cars)
Apprentissage automatique avec PySpark

Classes de RPM

bucketed.select('rpm', 'rpm_bin').show(5)
+----+-------+
| rpm|rpm_bin|
+----+-------+
|3800|    0.0|
|4500|    1.0|
|5750|    1.0|
|5300|    1.0|
|6200|    2.0|
+----+-------+
bucketed.groupBy('rpm_bin').count().show()
+-------+-----+
|rpm_bin|count|
+-------+-----+
|    0.0|    8| <- bas
|    1.0|   67| <- moyen
|    2.0|   17| <- haut
+-------+-----+
Apprentissage automatique avec PySpark

Encodage indicateur des classes de RPM

Les classes de RPM sont transformées en variables indicatrices (one-hot encoding).

+-------+-------------+
|rpm_bin|    rpm_dummy|
+-------+-------------+
|    0.0|(2,[0],[1.0])| <- bas
|    1.0|(2,[1],[1.0])| <- moyen
|    2.0|    (2,[],[])| <- haut
+-------+-------------+

La classe « haut » sert de référence et n'a pas de variable indicatrice.

Apprentissage automatique avec PySpark

Modèle avec RPM en classes

regression.coefficients
DenseVector([1.3814, 0.1433])
+-------+-------------+
|rpm_bin|    rpm_dummy|
+-------+-------------+
|    0.0|(2,[0],[1.0])| <- bas
|    1.0|(2,[1],[1.0])| <- moyen
|    2.0|    (2,[],[])| <- haut
+-------+-------------+
regression.intercept
8.1835

Consommation pour RPM « bas » :

8.1835 + 1.3814 = 9.5649

Consommation pour RPM « moyen » :

8.1835 + 0.1433 = 8.3268
Apprentissage automatique avec PySpark

Aller plus loin en feature engineering

Opérations sur une seule colonne :

  • log()
  • sqrt()
  • pow()

Opérations sur deux colonnes :

  • produit
  • ratio.
Apprentissage automatique avec PySpark

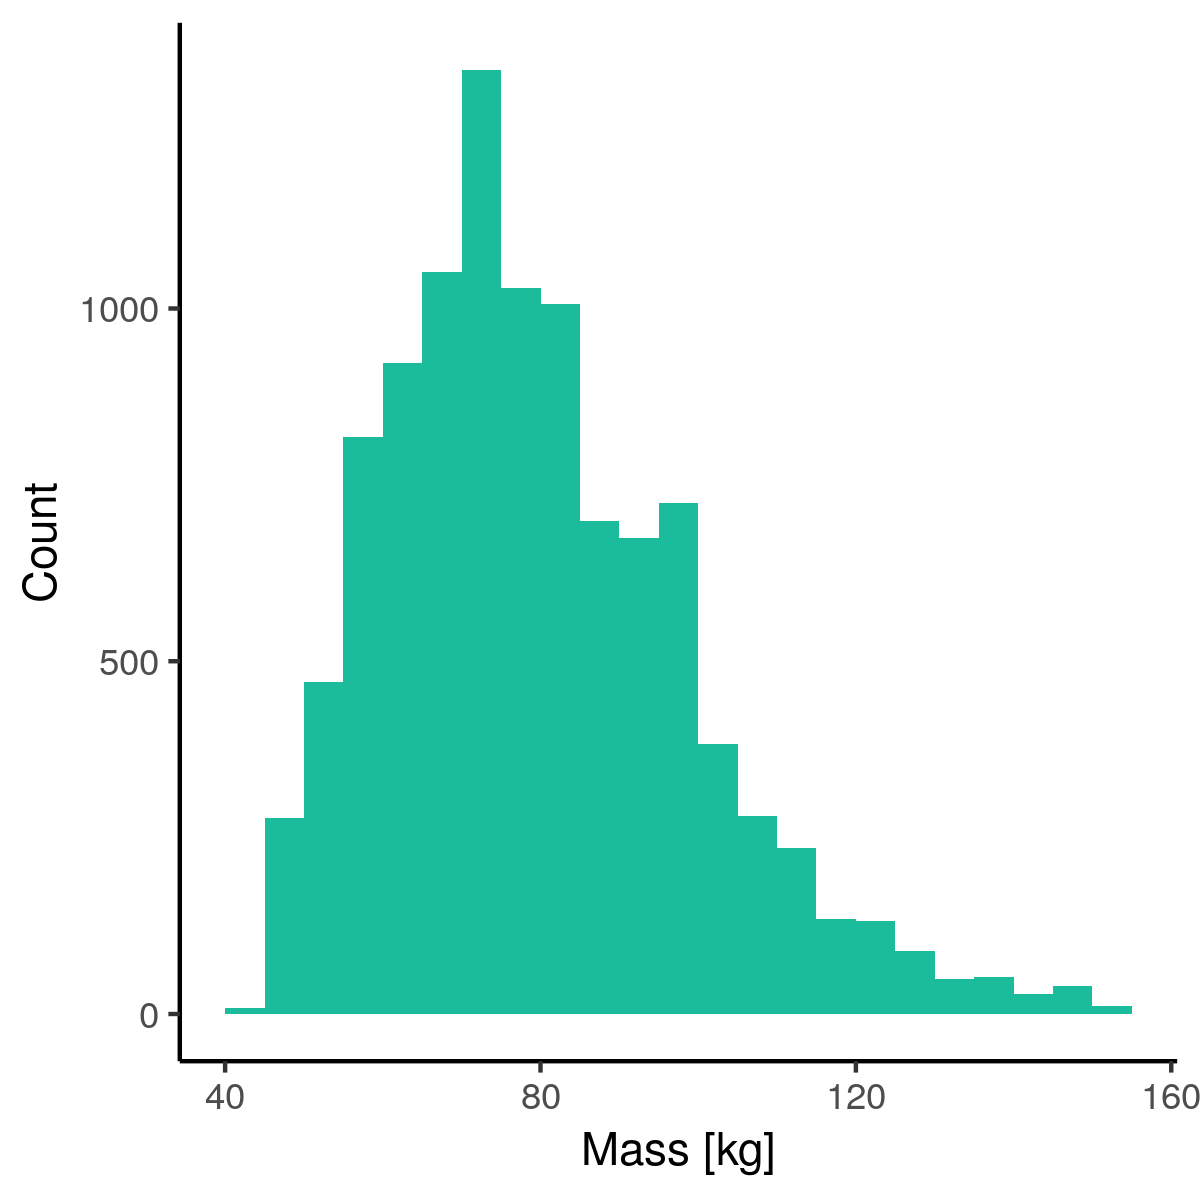
Masse et taille vers IMC

Un histogramme des tailles

Un histogramme des masses

Apprentissage automatique avec PySpark

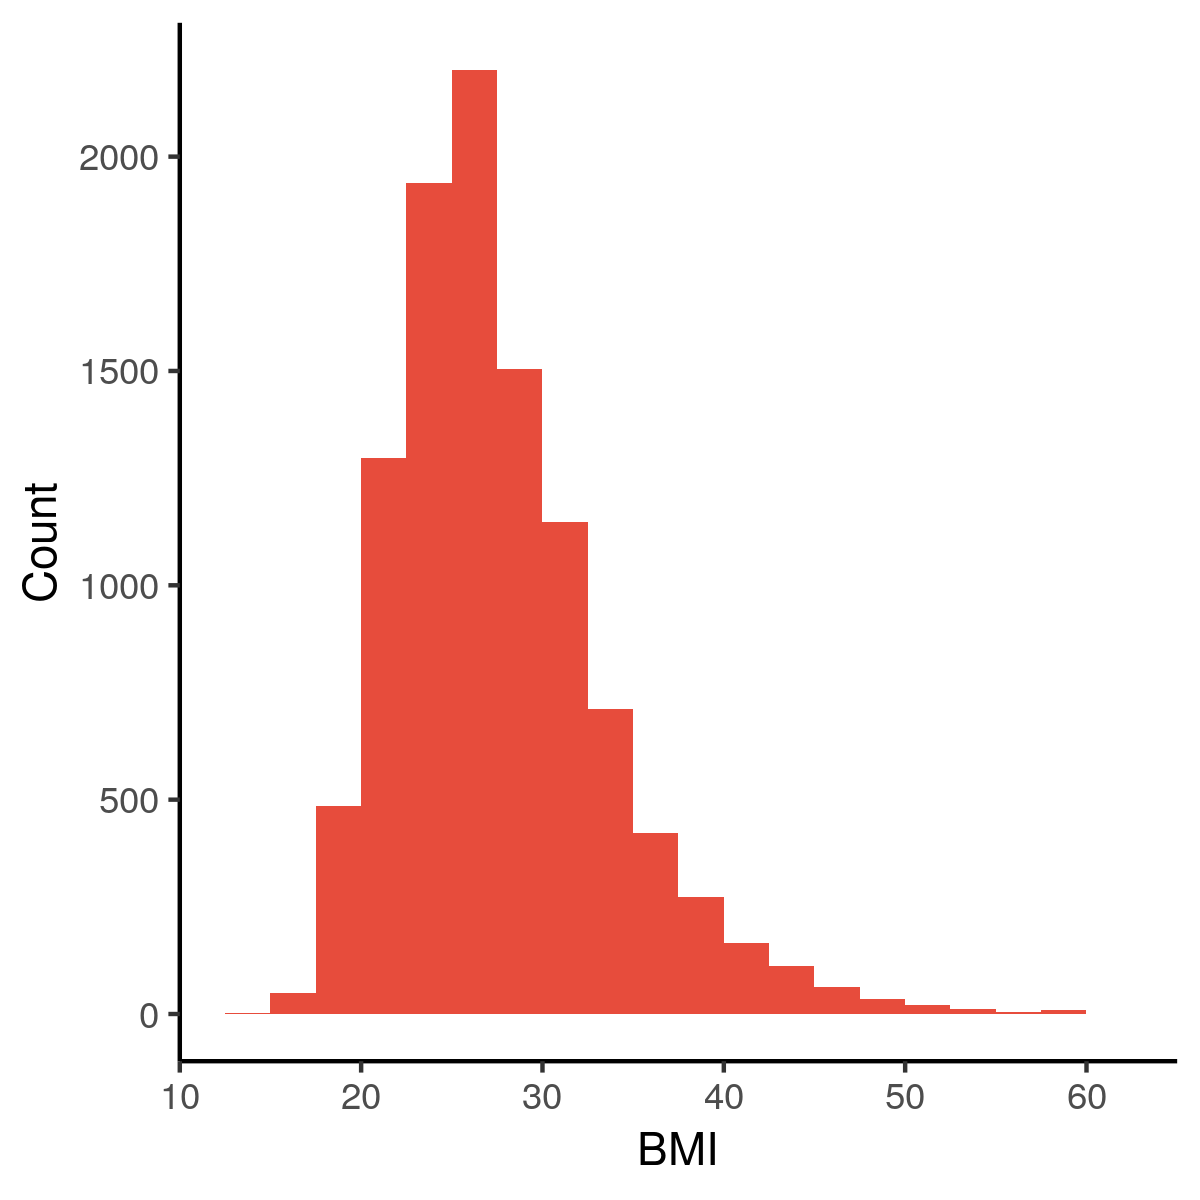
Masse et taille vers IMC

Un histogramme de l'IMC

+------+-----+----+
|height| mass| bmi|    bmi = mass / height^2
+------+-----+----+
|  1.52| 77.1|33.2|
|  1.60| 58.1|22.7|
|  1.57|122.0|49.4|
|  1.75| 95.3|31.0|
|  1.80| 99.8|30.7|
|  1.65| 90.7|33.3|
|  1.60| 70.3|27.5|
|  1.78| 81.6|25.8|
|  1.65| 77.1|28.3|
|  1.78|128.0|40.5|
+------+-----+----+
Apprentissage automatique avec PySpark

Ingénierie : densité

cars = cars.withColumn('density_line', cars.mass / cars.length)       # Linear density
cars = cars.withColumn('density_quad', cars.mass / cars.length**2)    # Area density
cars = cars.withColumn('density_cube', cars.mass / cars.length**3)    # Volume density
+------+------+------------+------------+------------+
|  mass|length|density_line|density_quad|density_cube|
+------+------+------------+------------+------------+
|1451.0| 4.775|303.87434554|63.638606397|13.327456837|
|1129.0| 4.623|244.21371403|52.825808790|11.426737787|
|1399.0| 4.547|307.67539036|67.665579583|14.881367843|
+------+------+------------+------------+------------+
Apprentissage automatique avec PySpark

Créons quelques features !

Apprentissage automatique avec PySpark

Preparing Video For Download...