Best Practices zur Datenvalidierung
Verantwortungsvolle KI-Datenverwaltung

Maria Prokofieva
Lead ML engineer
Subgruppenanalyse




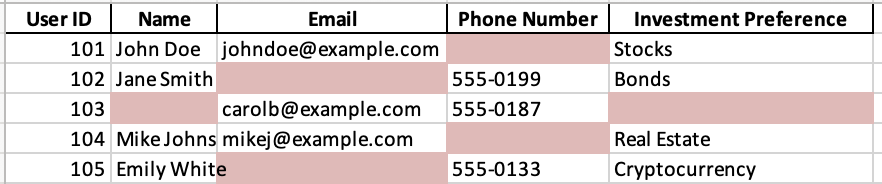
Fehlende Daten
- Häufig in großen Datensätzen
- Datenlöschung
- Imputation und modellbasierte Ansätze
- Subgruppenanalyse zur Validierung
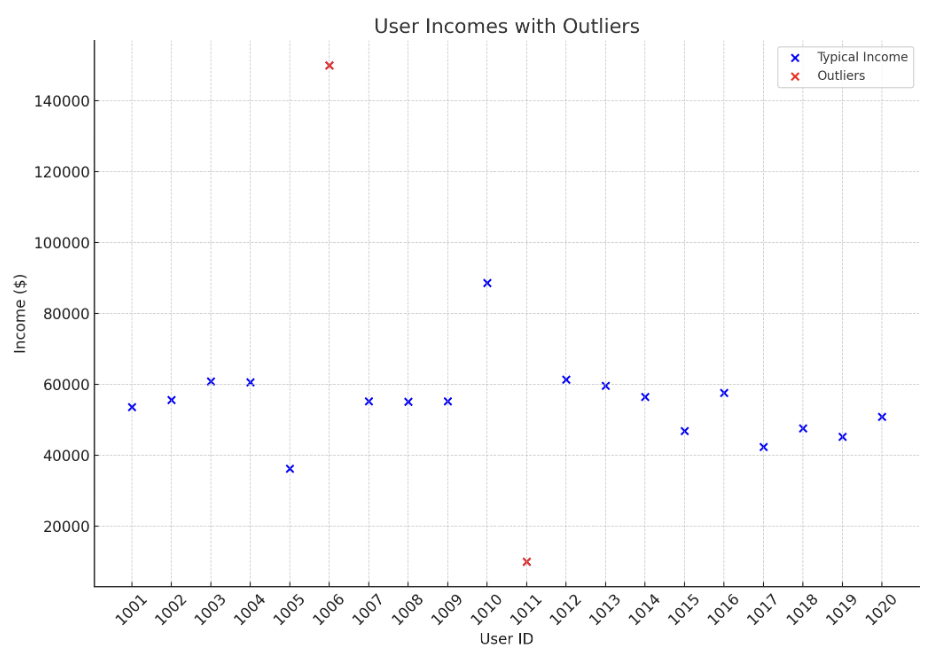
Ausreißerentfernung
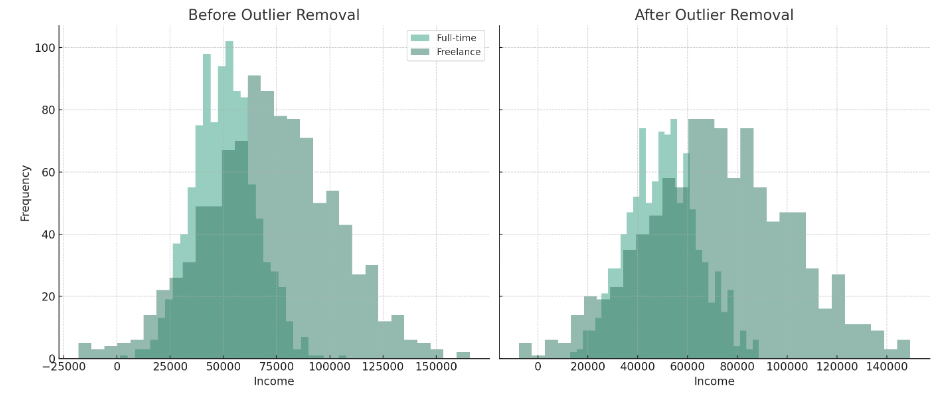
- Statistische Methoden wie z-Scores und IQR oder robustes Skalieren
- Fairness über Datensegmente hinweg validieren
Feature-Skalierung
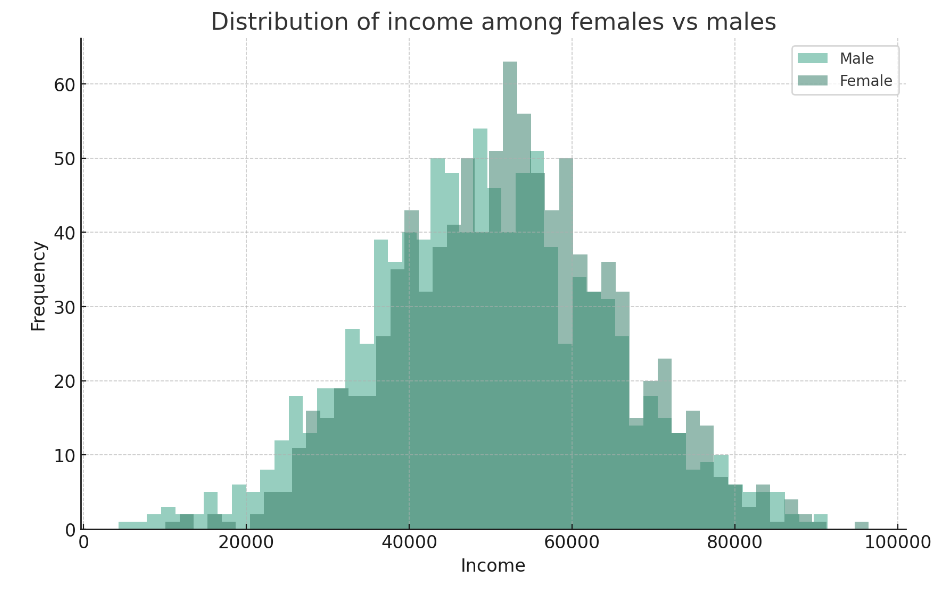
- Features skalieren, um Eingaben zu transformieren
- Validieren: Verteilungen zwischen Gruppen prüfen
Dimensionsreduktion
- Eingangsfeatures reduzieren, Kerninformationen bewahren
- Kann Verzerrungen erzeugen
- Fairnessbewusste Techniken wie t-SNE nutzen
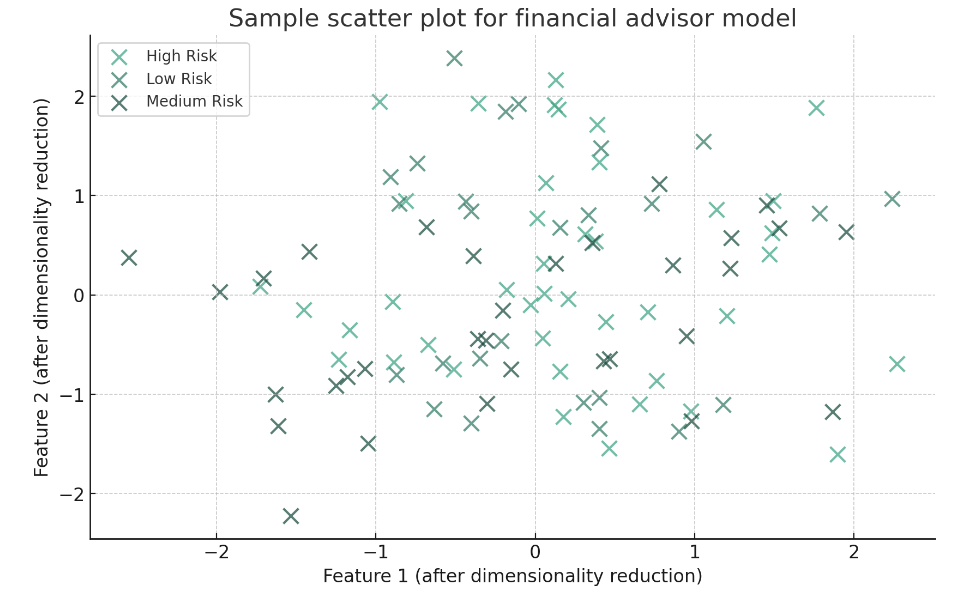
Finanzberater:in
- Features „Jahreseinkommen“ und „Anlagehäufigkeit“
- Ausreißer anpassen und skalieren
- Subgruppenanalyse