Análise de sentimento multimodal

Modelos multimodais com Hugging Face

James Chapman

Curriculum Manager, DataCamp

Vision Language Models (VLMs)
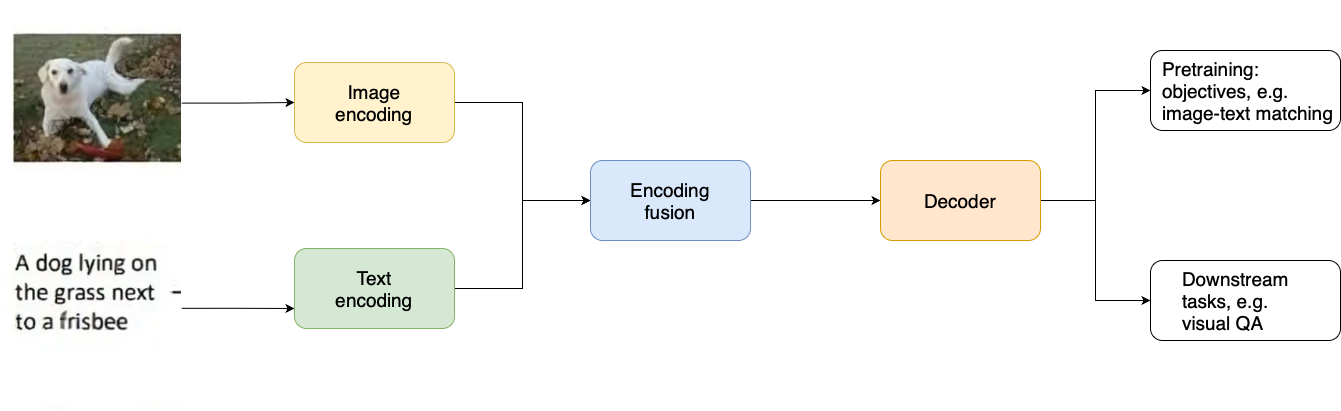
Diagrama de arquiteturas de modelos visão-linguagem em geral

  • Imagem e texto codificados separadamente
  • Fusão de features
  • Criar representações compartilhadas
    • Várias tarefas com um único modelo
Modelos multimodais com Hugging Face

Tarefas de raciocínio visual

  • VQA: Imagem + pergunta → Respostas diretas sobre o conteúdo
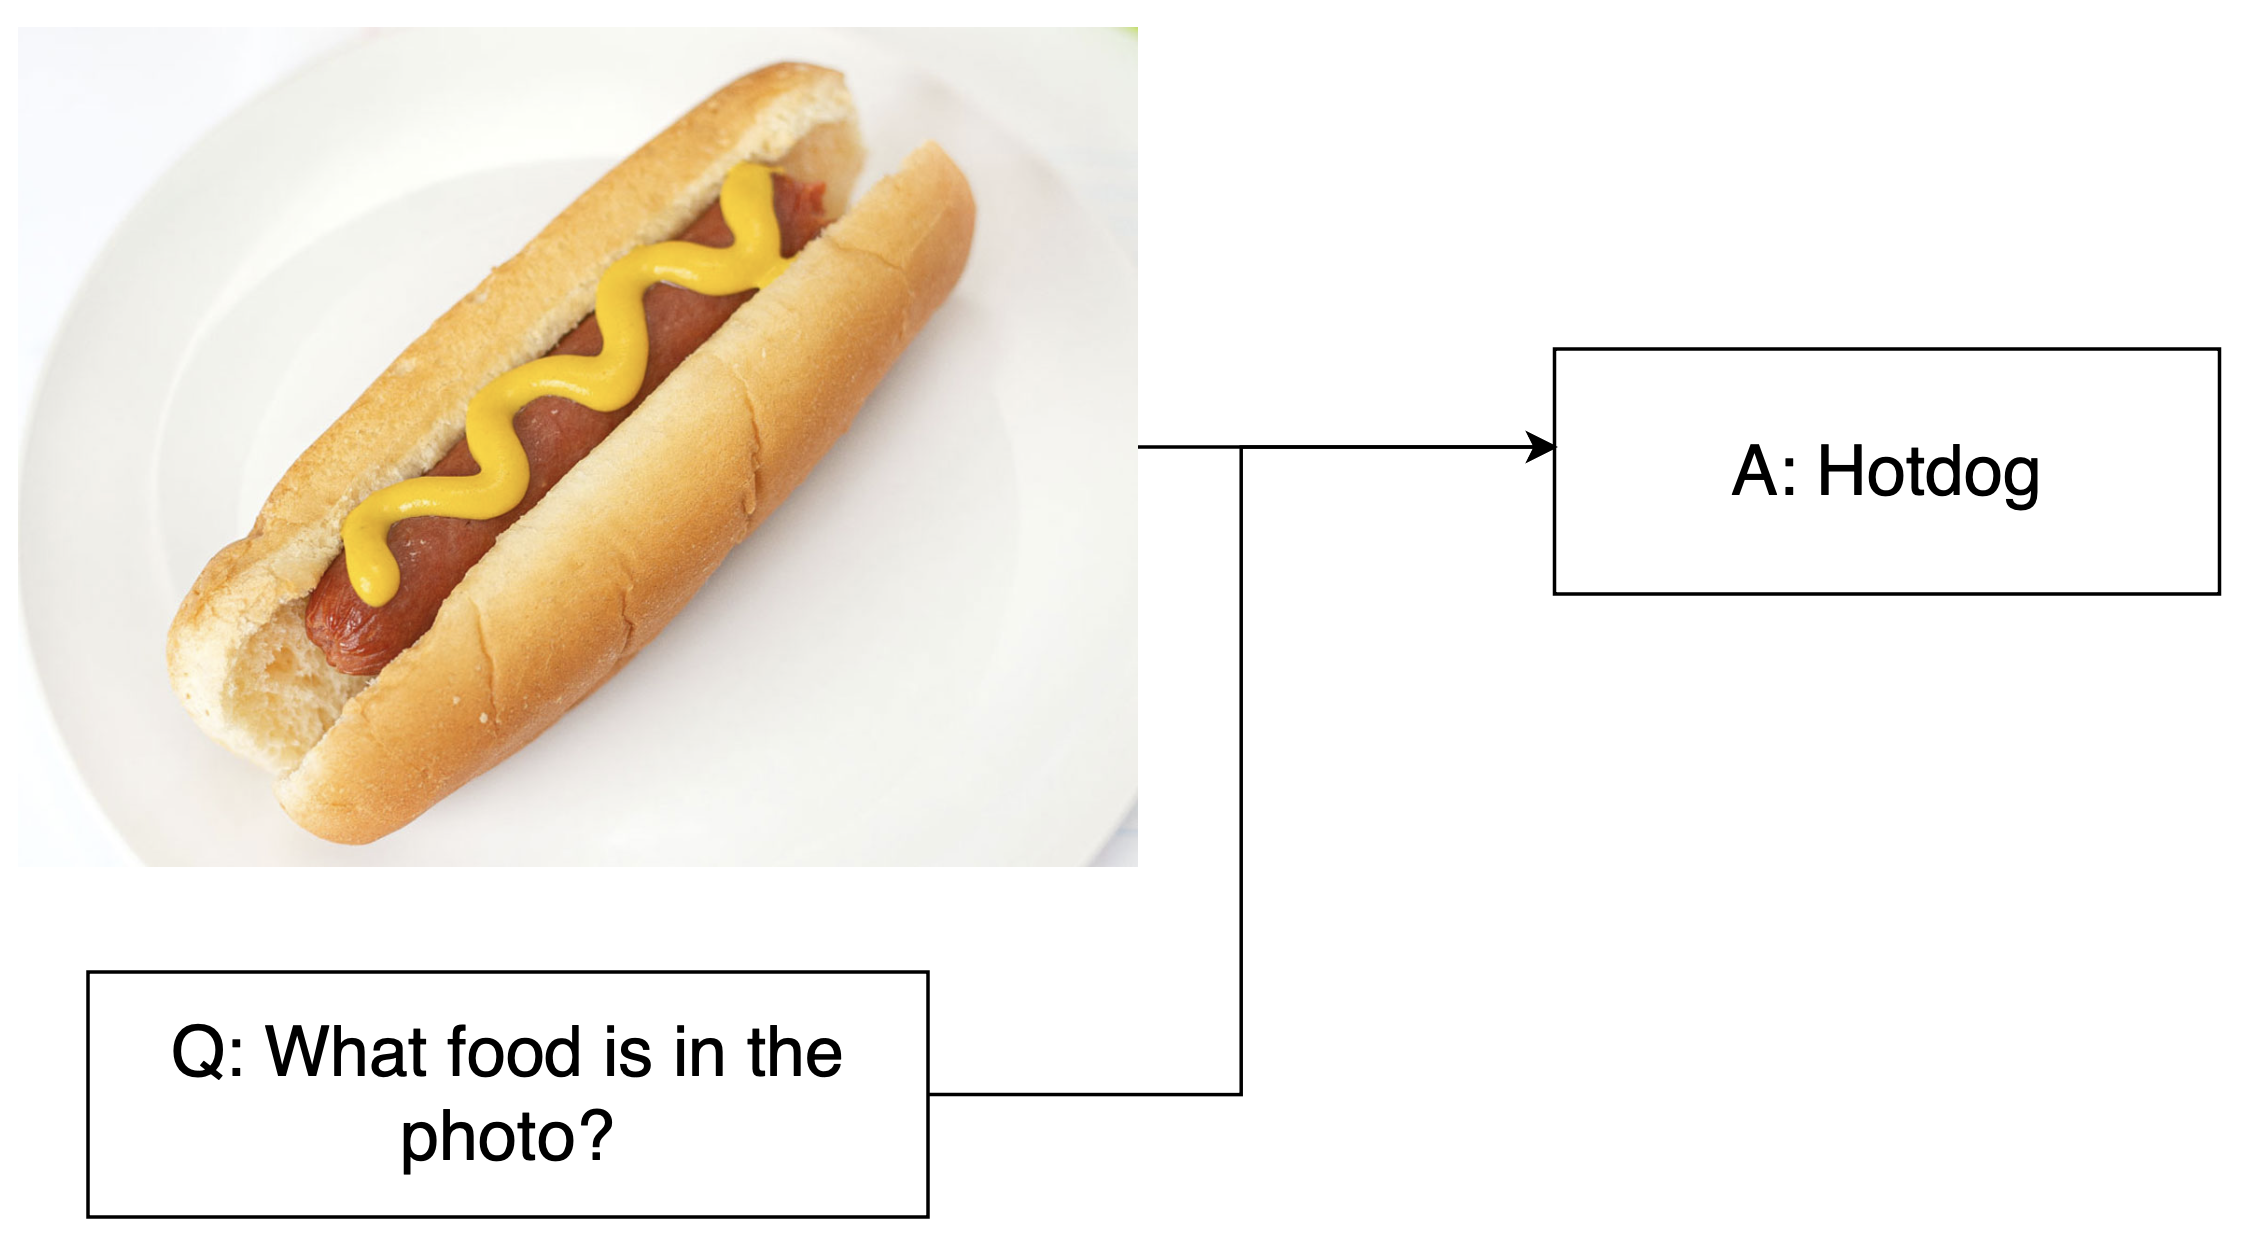
Resposta visual a perguntas envolvendo um cachorro-quente

1 https://arxiv.org/pdf/1505.00468
Modelos multimodais com Hugging Face

Tarefas de raciocínio visual

  • VQA: Imagem + pergunta → Respostas diretas sobre o conteúdo
  • Matching: Imagem + afirmação → Validações Verdadeiro/Falso

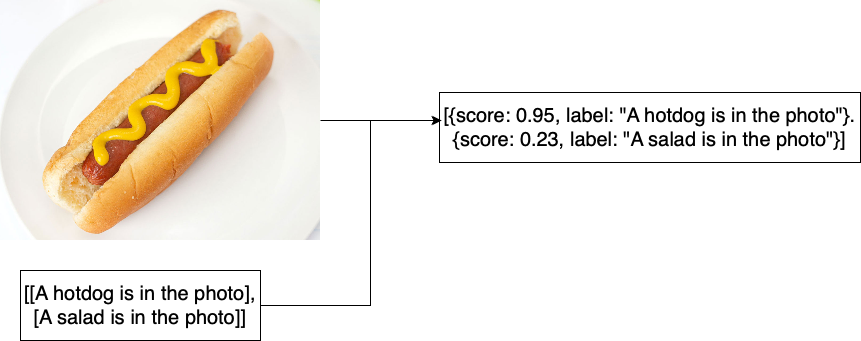
Exemplo de correspondências com um cachorro-quente e afirmações associadas

Modelos multimodais com Hugging Face

Tarefas de raciocínio visual

  • VQA: Imagem + pergunta → Respostas diretas sobre o conteúdo
  • Matchings: Imagem + afirmação → Validações Verdadeiro/Falso
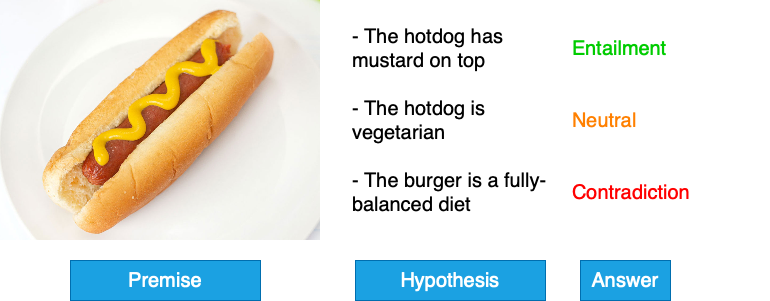
  • Entailment: Imagem + textos contrastantes → Verificação de relação semântica

Exemplo de entailment com um cachorro-quente e hipóteses de implicação, neutras e contraditórias

Modelos multimodais com Hugging Face

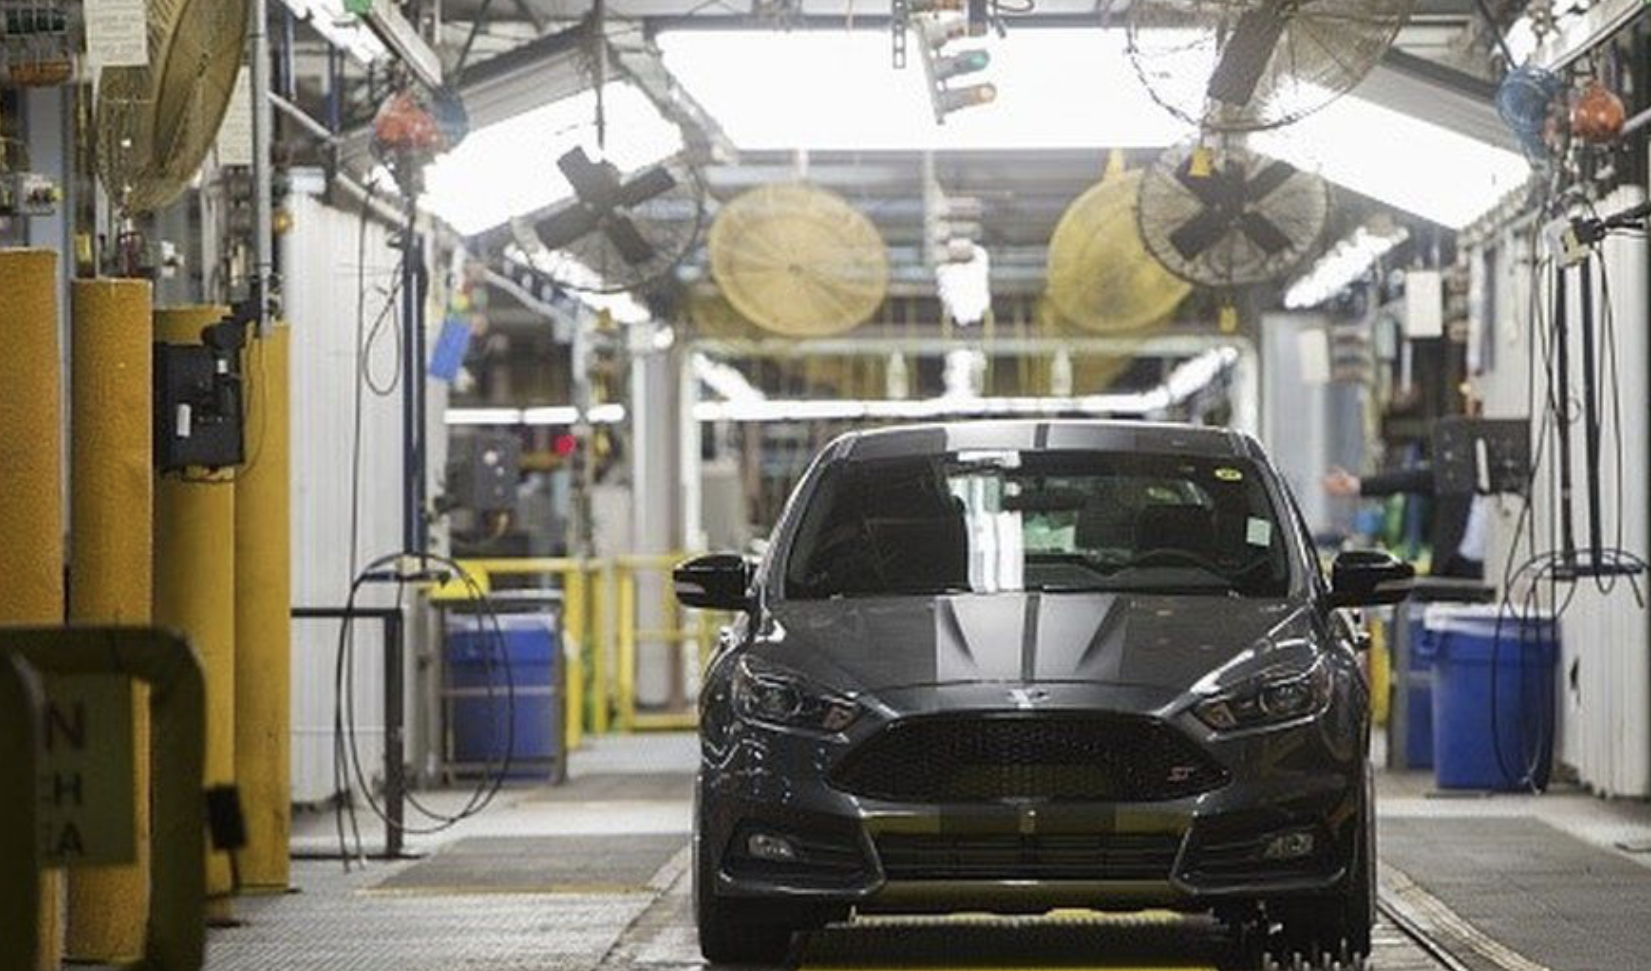
Caso de uso: impacto no preço da ação
from datasets import load_dataset
dset = "RealTimeData/bbc_news_alltime"
dataset = load_dataset(dset, '2017-01', 
                       split="train")


image = dataset[87]["top_image"] content = dataset[87]["content"] print(content)
'Ford\'s decision to cancel a $1.6bn 
investment in Mexico and 
invest an extra $700m in Michigan ...

imagem de uma reportagem sobre investimentos em produção de carros

Modelos multimodais com Hugging Face

Qwen 2 VLMs

from transformers import Qwen2VLForConditionalGeneration
from qwen_vl_utils import process_vision_info


vl_model = Qwen2VLForConditionalGeneration.from_pretrained( "Qwen/Qwen2-VL-2B-Instruct", device_map="auto", torch_dtype="auto" )
Modelos multimodais com Hugging Face

O pré-processador

from transformers import Qwen2VLProcessor

min_pixels = 224 * 224
max_pixels = 448 * 448
vl_model_processor = Qwen2VLProcessor.from_pretrained(
    "Qwen/Qwen2-VL-2B-Instruct", min_pixels=min_pixels, max_pixels=max_pixels
)
Modelos multimodais com Hugging Face

Prompts multimodais

text_query = f"Is the sentiment of the following content good or bad for the Ford share price:
{article_text}. Provide reasoning."


chat_template = [ { "role": "user", "content": [ {"type": "image", "image": article_image}, {"type": "text", "text": text_query} ] } ]
Modelos multimodais com Hugging Face

Classificação com VLM

text = vl_model_processor.apply_chat_template(chat_template, tokenize=False,
                                              add_generation_prompt=True)

image_inputs, _ = process_vision_info(chat_template)
inputs = vl_model_processor(text=[text], images=image_inputs, padding=True, return_tensors="pt")
generated_ids = vl_model.generate(**inputs, max_new_tokens=500)
generated_ids_trimmed = [out_ids[len(in_ids) :] for in_ids, out_ids\ in zip(inputs.input_ids, generated_ids)]
Modelos multimodais com Hugging Face

Classificação com VLM

output_text = vl_model_processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text[0])
The sentiment of the provided text is negative. The author is expressing concern and
skepticism ...
Modelos multimodais com Hugging Face

Vamos praticar!

Modelos multimodais com Hugging Face

Preparing Video For Download...