Reconhecimento de fala e geração de áudio

Modelos multimodais com Hugging Face

James Chapman

Curriculum Manager, DataCamp

Fala
 

Quais são as partes importantes das formas de onda da fala?

  • Pitch: freq. média — homens 85–180 Hz, mulheres 165–255 Hz
  • Ênfase: depende do idioma, sotaque e emoção
  • Ritmo: influenciado por contexto, emoção e idioma


Publicação em rede social

Modelos multimodais com Hugging Face

Reconhecimento automático de fala

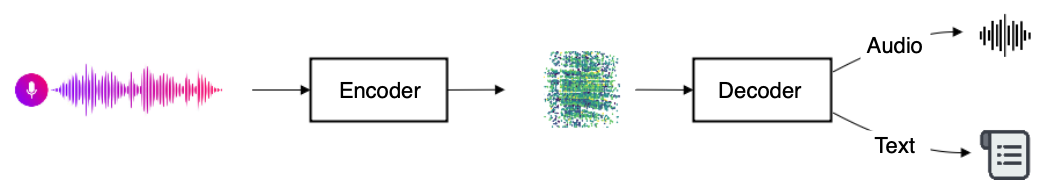
Áudio é codificado e depois decodificado em áudio ou texto.

  • Texto e áudio são ambos sequenciais
  • Exemplos: transcrição, tradução, text-to-speech
Modelos multimodais com Hugging Face

Reconhecimento automático de fala

  • Modelo tiny: 39M parâmetros, 150 MB de tamanho
  • Dados de treino: 680k horas (rotuladas)
from transformers import WhisperProcessor, WhisperForConditionalGeneration
processor = WhisperProcessor.from_pretrained("openai/whisper-tiny")
model = WhisperForConditionalGeneration.from_pretrained("openai/whisper-tiny")
1 https://github.com/openai/whisper
Modelos multimodais com Hugging Face

Reconhecimento automático de fala

from datasets import load_dataset, Audio
dataset = load_dataset("CSTR-Edinburgh/vctk")["train"]
dataset = dataset.cast_column("audio", Audio(sampling_rate=16_000))

sample = dataset[0]["audio"]
input_preprocessed = processor(sample["array"], sampling_rate=sample["sampling_rate"], return_tensors="pt")
predicted_ids = model.generate(input_preprocessed.input_features)
transcription = processor.batch_decode(predicted_ids, skip_special_tokens=True) print(transcription)
['Please cool Stella.']
Modelos multimodais com Hugging Face

Geração de áudio

Três componentes para gerar áudio:

  • Pré-processador: reamostragem e extração de atributos
  • Modelo: transformação de atributos
  • Vocoder: modelo generativo separado para formas de onda
from transformers import SpeechT5Processor, SpeechT5ForSpeechToSpeech, SpeechT5HifiGan

processor = SpeechT5Processor.from_pretrained("microsoft/speecht5_vc") model = SpeechT5ForSpeechToSpeech.from_pretrained("microsoft/speecht5_vc") vocoder = SpeechT5HifiGan.from_pretrained("microsoft/speecht5_hifigan")
Modelos multimodais com Hugging Face

Embeddings de fala

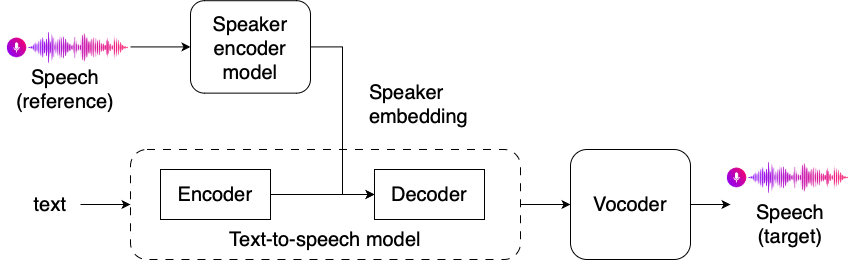
Diagrama de como um embedding de fala entra no pipeline de geração

Modelos multimodais com Hugging Face

Gerando embeddings de locutor

  • Codificador pré-treinado: array de forma de onda → array codificado (tipicamente 512 dimensões)
from speechbrain.inference.speaker import EncoderClassifier
speaker_model = EncoderClassifier.from_hparams(source="speechbrain/spkrec-xvect-voxceleb")
speaker_embeddings = speaker_model.encode_batch(torch.tensor(dataset[0]["audio"]["array"]))

speaker_embeddings = torch.nn.functional.normalize(speaker_embeddings, dim=2).unsqueeze(0)
Modelos multimodais com Hugging Face

Geração de áudio

inputs = processor(audio=dataset[0]["audio"], 
                   sampling_rate=dataset[0]["audio"]["sampling_rate"], 
                   return_tensors="pt")


speech = model.generate_speech(inputs["input_values"], speaker_embedding, vocoder=vocoder)
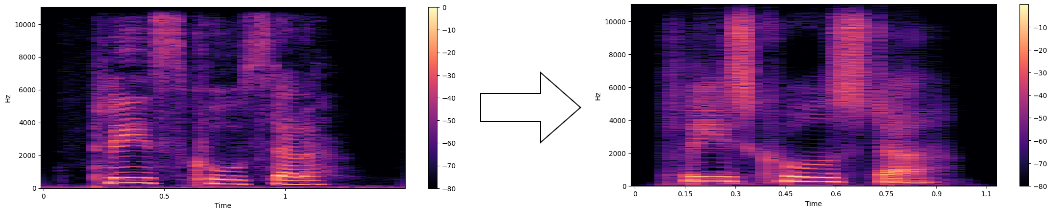
Espectrograma antes e depois

Modelos multimodais com Hugging Face

Vamos praticar!

Modelos multimodais com Hugging Face

Preparing Video For Download...