Classificação de imagens zero-shot

Modelos multimodais com Hugging Face

James Chapman

Curriculum Manager, DataCamp

CLIP
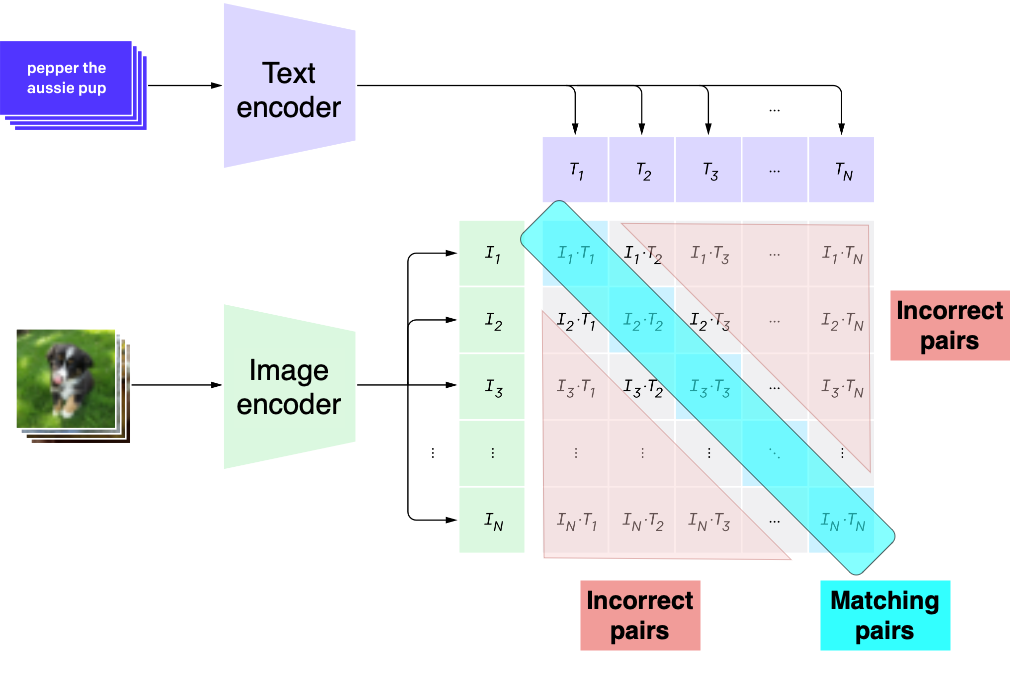
  • Pré-treinamento contrastivo de linguagem e imagem
  • Pontua a similaridade entre imagens e texto
  • Treinado em 400M de pares imagem-texto
  • Dois codificadores:
    • Codificador de visão
    • Codificador de texto
  • Combinações próximas imagem-texto geram arrays parecidos

Diagrama de codificação de texto e imagem do CLIP

1 https://openai.com/index/clip/
Modelos multimodais com Hugging Face

Zero-shot learning

  • Executar tarefas para as quais o modelo não foi treinado
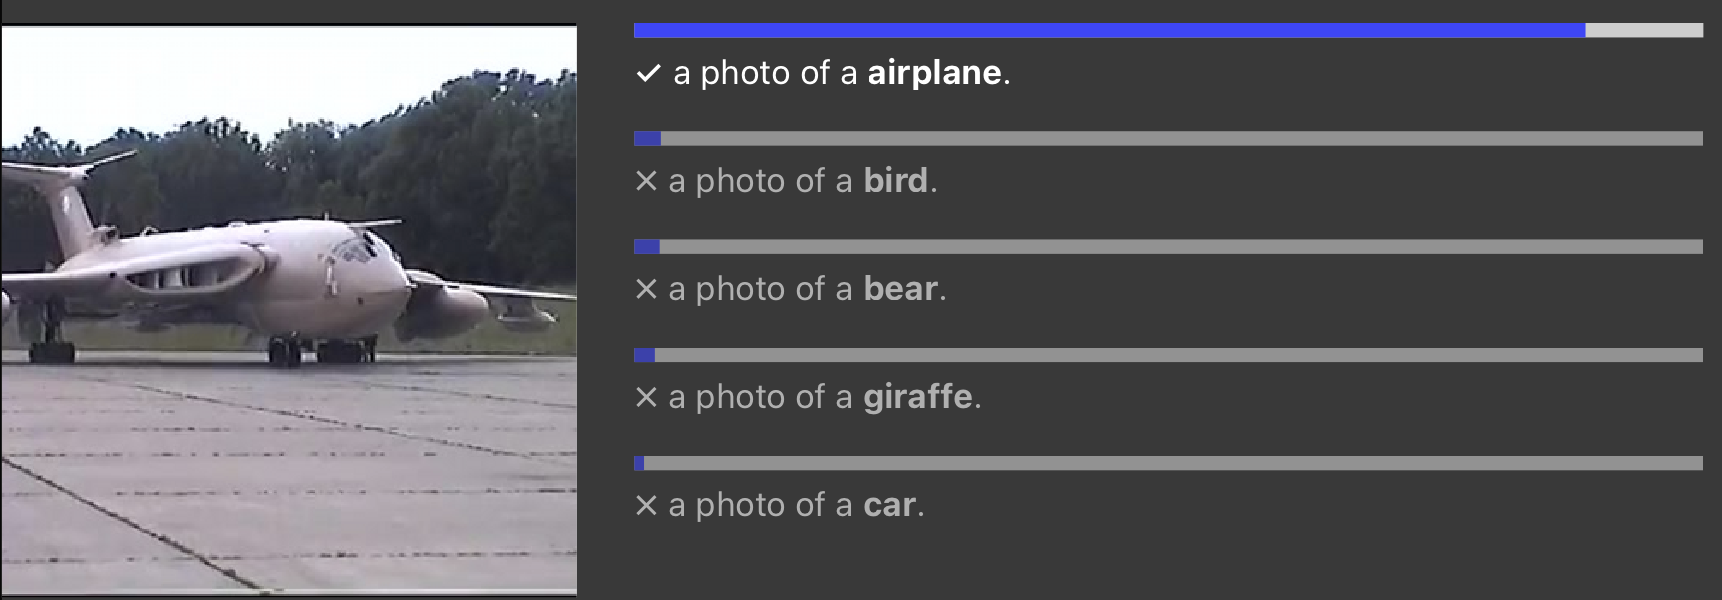
Ranking de zero-shot learning de um avião

1 https://openai.com/index/clip/
Modelos multimodais com Hugging Face

Caso de uso: categorização de produtos
from datasets import load_dataset
import matplotlib.pyplot as plt

dset = "rajuptvs/ecommerce_products_clip"
dataset = load_dataset(dset)

print(dataset["train"][0]["Description"])
plt.imshow(dataset["train"][0]["image"]) plt.show()
Blive High quality premium Full sleeves printed 
Shirt direct from the manufacturers.Gives you 
a clean and classy look while also 
making you feel comfortable.Trusted 
brand online and no compromise on quality.

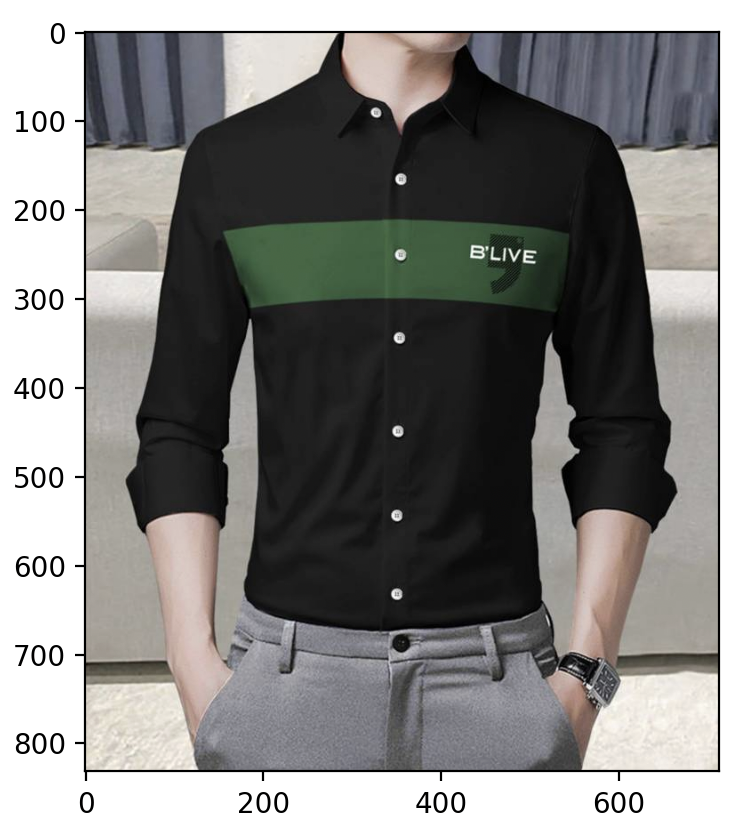
Foto de uma camisa do conjunto de dados

Modelos multimodais com Hugging Face

Zero-shot learning com CLIP

model = CLIPModel.from_pretrained("openai/clip-vit-base-patch32")
processor = CLIPProcessor.from_pretrained("openai/clip-vit-base-patch32")


categories = ["shirt", "trousers", "shoes", "dress", "hat", "bag", "watch"]
inputs = processor(text=categories, images=dataset["train"][0]["image"], return_tensors="pt", padding=True) outputs = model(**inputs)
probs = outputs.logits_per_image.softmax(dim=1)
categories[probs.argmax().item()]
shirt
Modelos multimodais com Hugging Face

A pontuação CLIP

  • Similaridade da imagem codificada com a descrição codificada
  • Varia de 100 (acordo perfeito) a 0 (sem acordo)
from torchmetrics.functional.multimodal import clip_score


image = dataset["train"][0]["image"] description = dataset["train"][0]["Description"]
from torchvision.transforms import ToTensor image = ToTensor()(image)*255
score = clip_score(image, description, "openai/clip-vit-base-patch32")
print(f"CLIP score: {score}")
CLIP score: 28.495952606201172
Modelos multimodais com Hugging Face

Vamos praticar!

Modelos multimodais com Hugging Face

Preparing Video For Download...