Visão computacional

Modelos multimodais com Hugging Face

James Chapman

Curriculum Manager, DataCamp

Modelos de visão
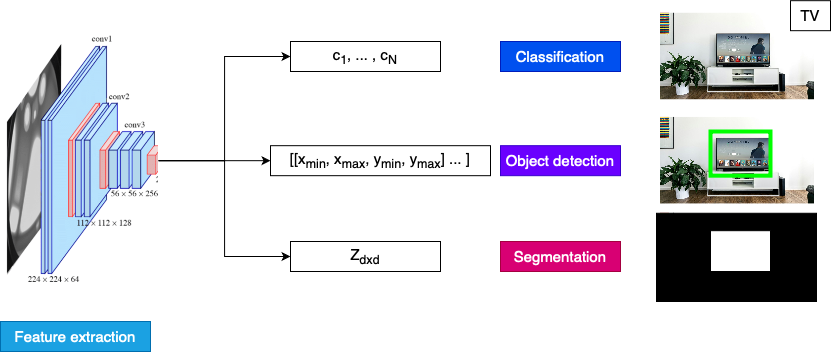
Diagrama de tarefas de visão

1 https://arxiv.org/abs/1409.1556
Modelos multimodais com Hugging Face

Classificação

from datasets import load_dataset
dataset = load_dataset("nlphuji/flickr30k")
image = dataset['test'][134]["image"]
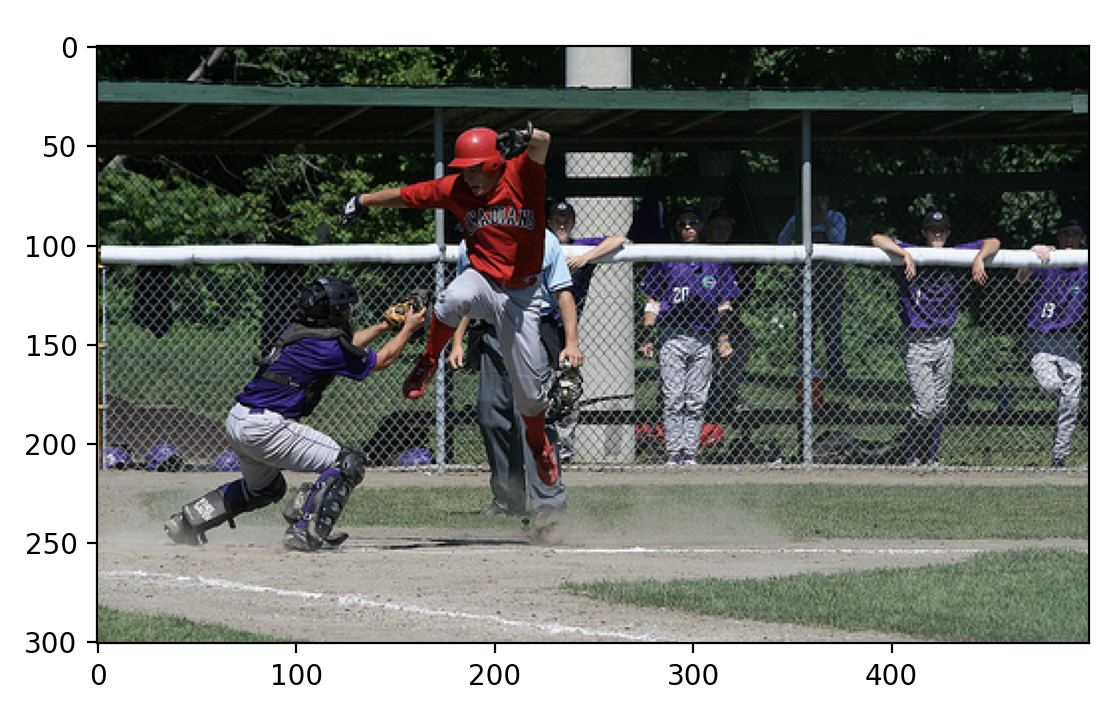
Imagem de um jogo de beisebol

from transformert import pipeline
pipe = pipeline("image-classification", 
"google/mobilenet_v2_1.0_224") # entrada 224x224

pred = pipe(image) print("Classe prevista:", pred[0]['label'])
Classe prevista: ballplayer, baseball player
Modelos multimodais com Hugging Face

Detecção de objetos

dataset['test'][52]["image"]
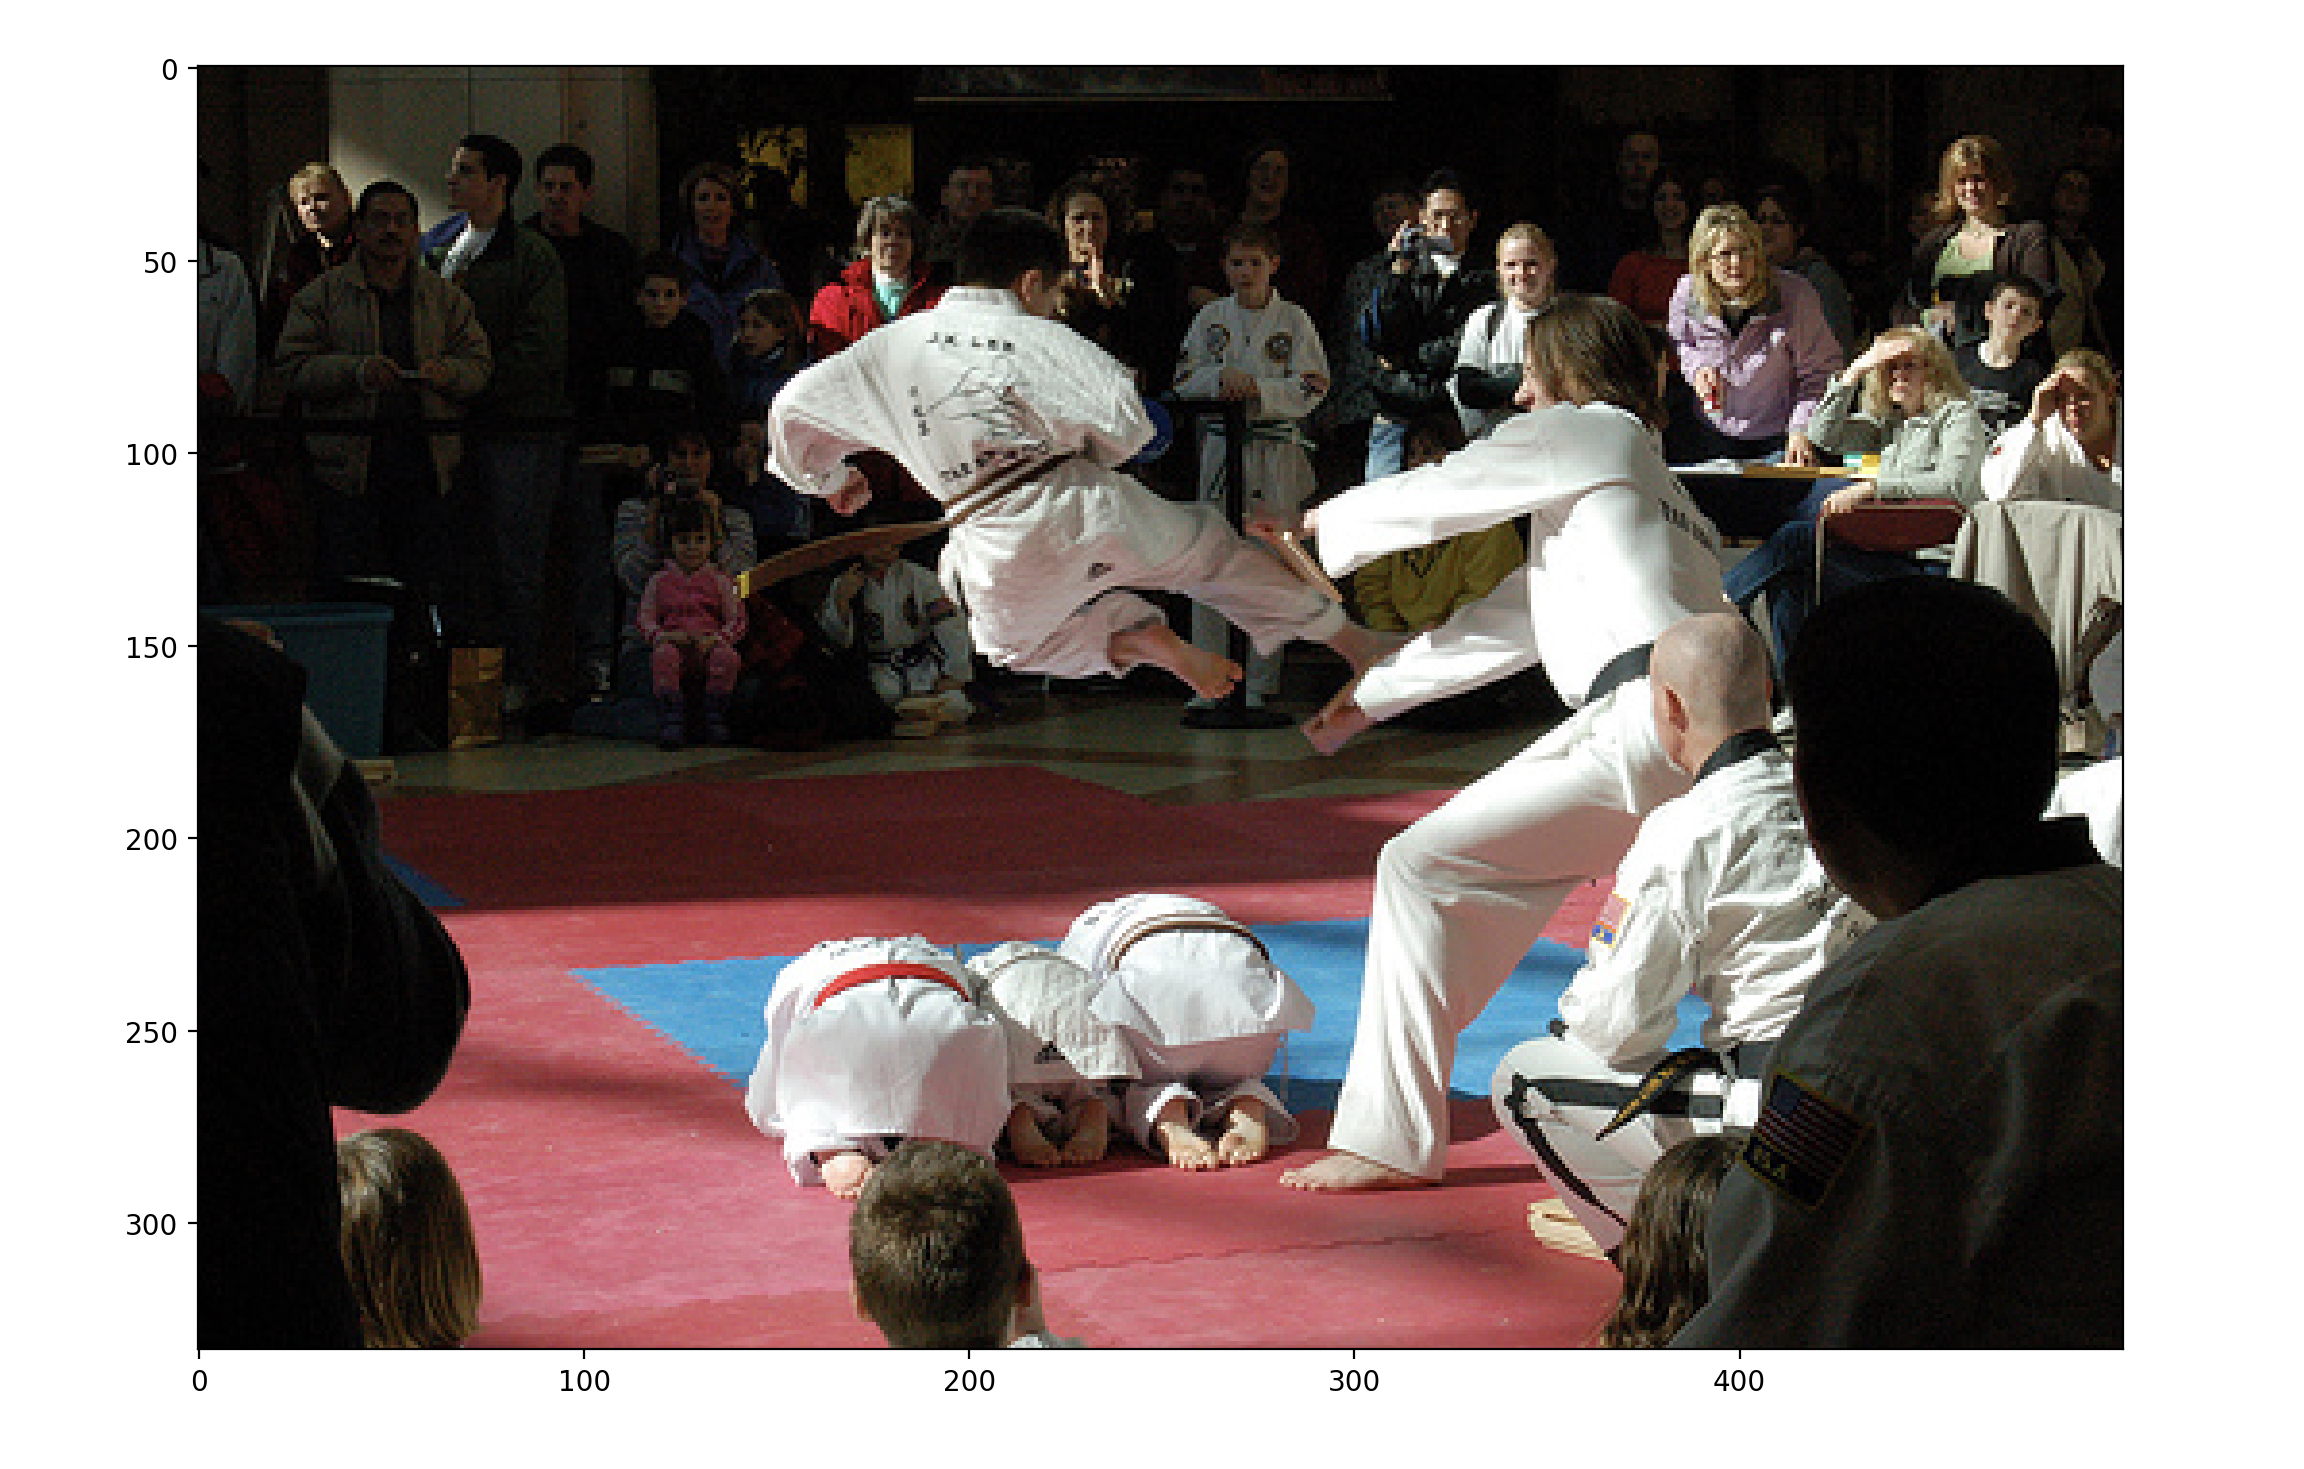
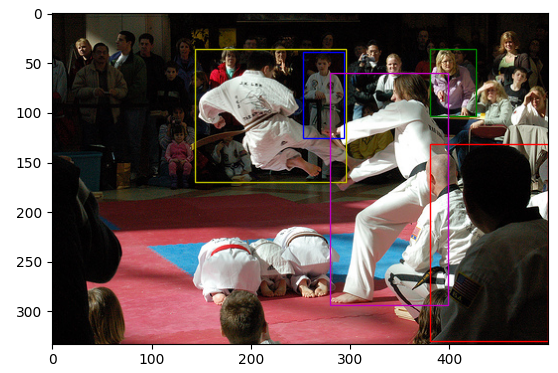
Competição de artes marciais, agora com caixas delimitadoras

Modelos multimodais com Hugging Face

Detecção de objetos

pipe = pipeline("object-detection", "facebook/detr-resnet-50", revision="no_timm")

outputs = pipe(image, threshold=0.95)
for obj in outputs: box = obj['box']
print(f"Detected {obj['label']} with confidence {obj['score']:.2f} at ({box['xmin']}, {box['ymin']}) to ({box['xmax']}, {box['ymax']})")
Detected person with confidence 0.97 at (381, 131) to (499, 330)
Detected person with confidence 0.96 at (381, 36) to (427, 103)
Detected person with confidence 0.98 at (253, 39) to (294, 125)
Detected person with confidence 1.00 at (144, 36) to (296, 170)
Detected person with confidence 0.95 at (280, 60) to (399, 294)
Modelos multimodais com Hugging Face

Detecção de objetos

import matplotlib.pyplot as plt
import matplotlib.patches as patches
ax = plt.gca()
colors = ['r', 'g', 'b', 'y', 'm', 'c', 'k']

plt.imshow(image)
for n, obj in enumerate(outputs): box = obj['box']
rect = patches.Rectangle( (box['xmin'], box['ymin']), box['xmax']-box['xmin'], box['ymax']-box['ymin'],
linewidth=1, edgecolor=colors[n], facecolor='none')
ax.add_patch(rect)
plt.show()

Competição de artes marciais, agora com caixas delimitadoras

Modelos multimodais com Hugging Face

Segmentação

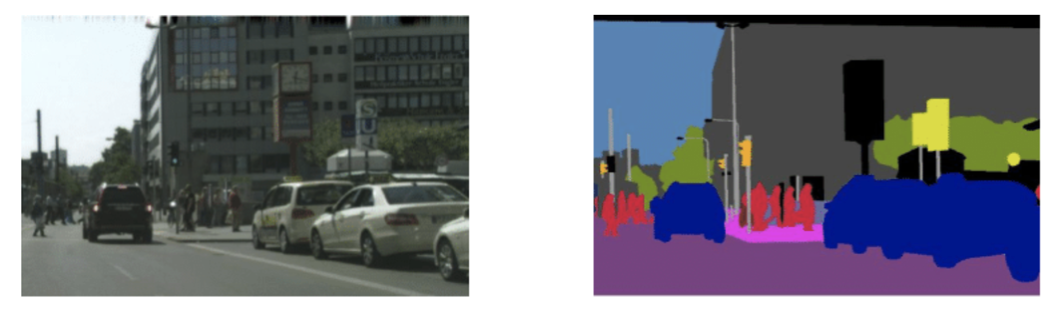
segmentação semântica

  • Saída: matriz 2D com as mesmas dimensões da entrada
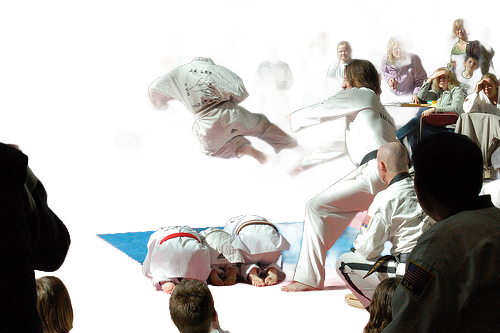
  • Remoção de fundo: cada pixel é 1 (primeiro plano) ou 0 (fundo)
  • Imagem $\times$ Saída → Imagem sem fundo
Modelos multimodais com Hugging Face

Segmentação

pipe = pipeline("image-segmentation", 
                model="briaai/RMBG-1.4", 
                trust_remote_code=True)

outputs = pipe(image)

plt.imshow(outputs) plt.show()

Imagem de competição de artes marciais, agora sem fundo

Modelos multimodais com Hugging Face

Vamos praticar!

Modelos multimodais com Hugging Face

Preparing Video For Download...