Perguntas e respostas visuais (VQA)

Modelos multimodais com Hugging Face

James Chapman

Curriculum Manager, DataCamp

Tarefas de QA multimodal
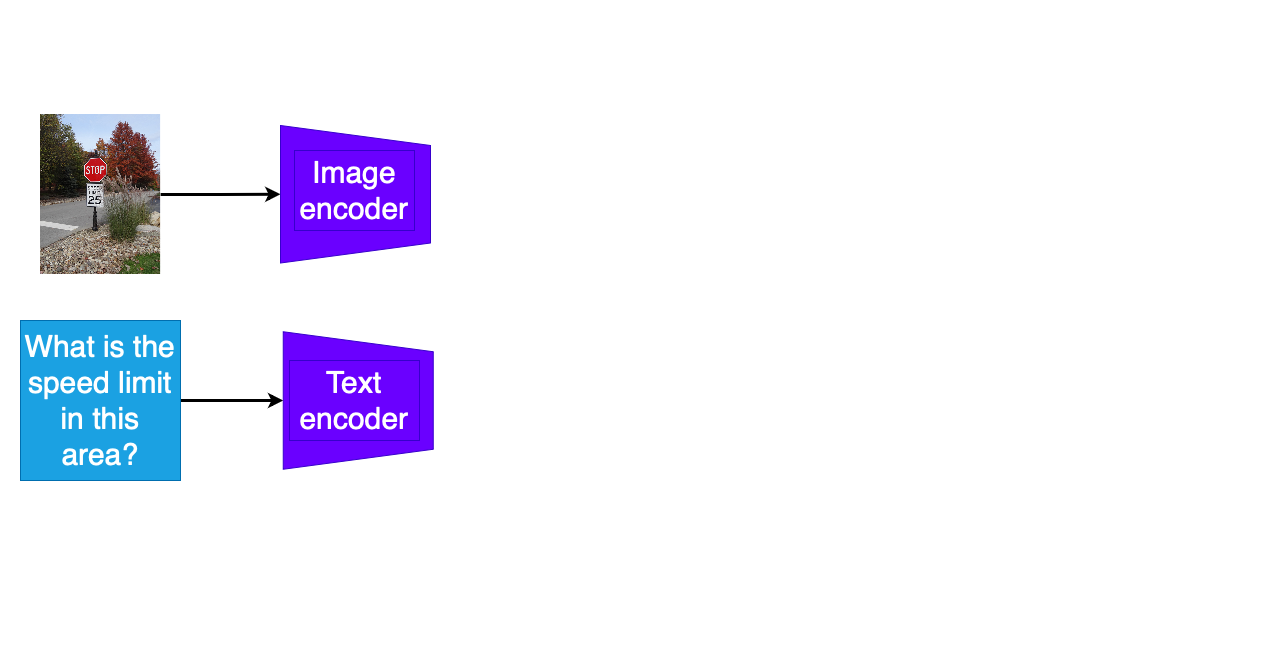
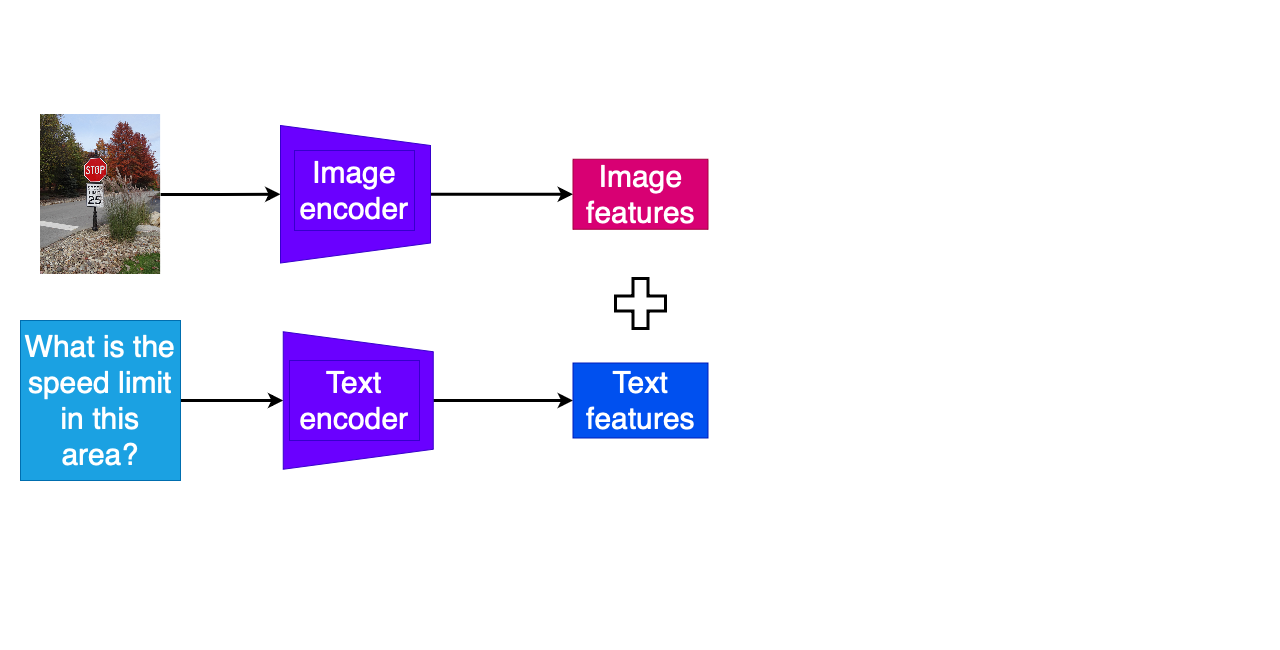
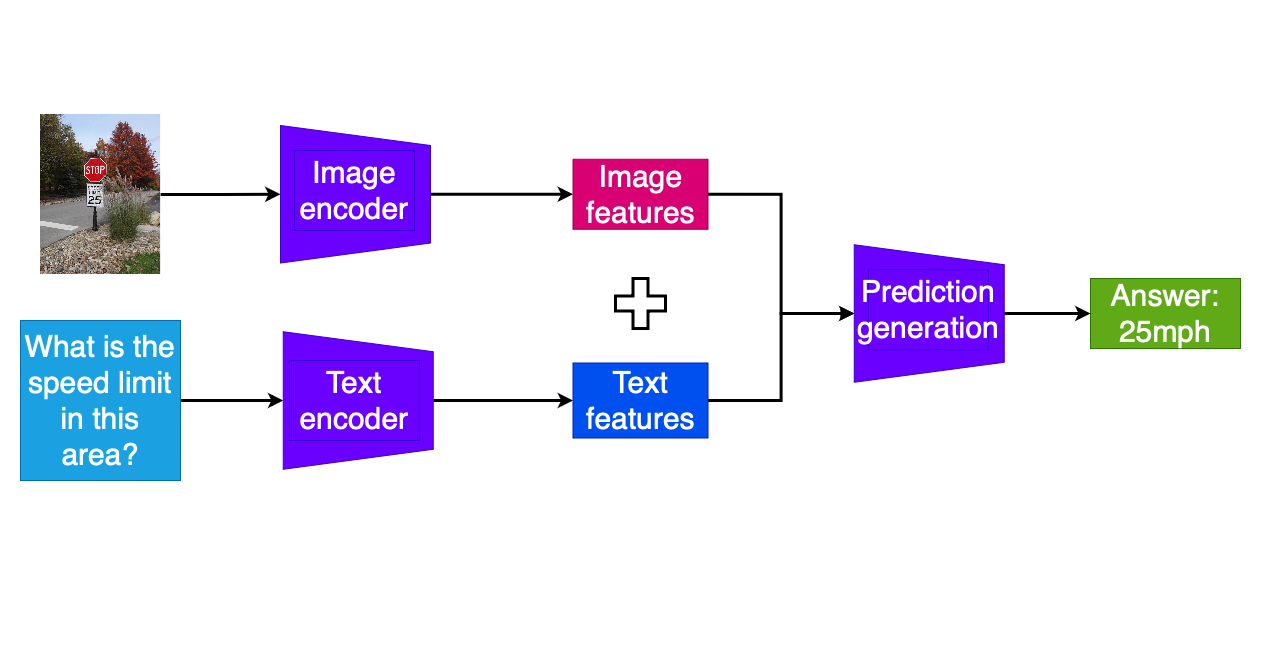
Diagrama mostrando o processamento de imagem e texto em um modelo de VQA

  1. Codificação separada do texto da pergunta e da outra modalidade
Modelos multimodais com Hugging Face

Tarefas de QA multimodal

Diagrama mostrando o processamento de imagem e texto em um modelo de VQA

  1. Codificação separada do texto da pergunta e da outra modalidade
  2. Combinação dos recursos codificados
Modelos multimodais com Hugging Face

Tarefas de QA multimodal

Diagrama mostrando o processamento de imagem e texto em um modelo de VQA

  1. Codificação separada do texto da pergunta e da outra modalidade
  2. Combinação dos recursos codificados
  3. Camadas extras do modelo para prever tokens da resposta
Modelos multimodais com Hugging Face

VQA

import requests
from PIL import Image

url = "https://www.worldanimalprotection
.org/cdn-cgi/image/width=1920,format=
auto/globalassets/images/elephants/1
033551-elephant.jpg"


image = Image.open(requests.get(url, stream=True).raw)
text = "What animal is in this photo?"

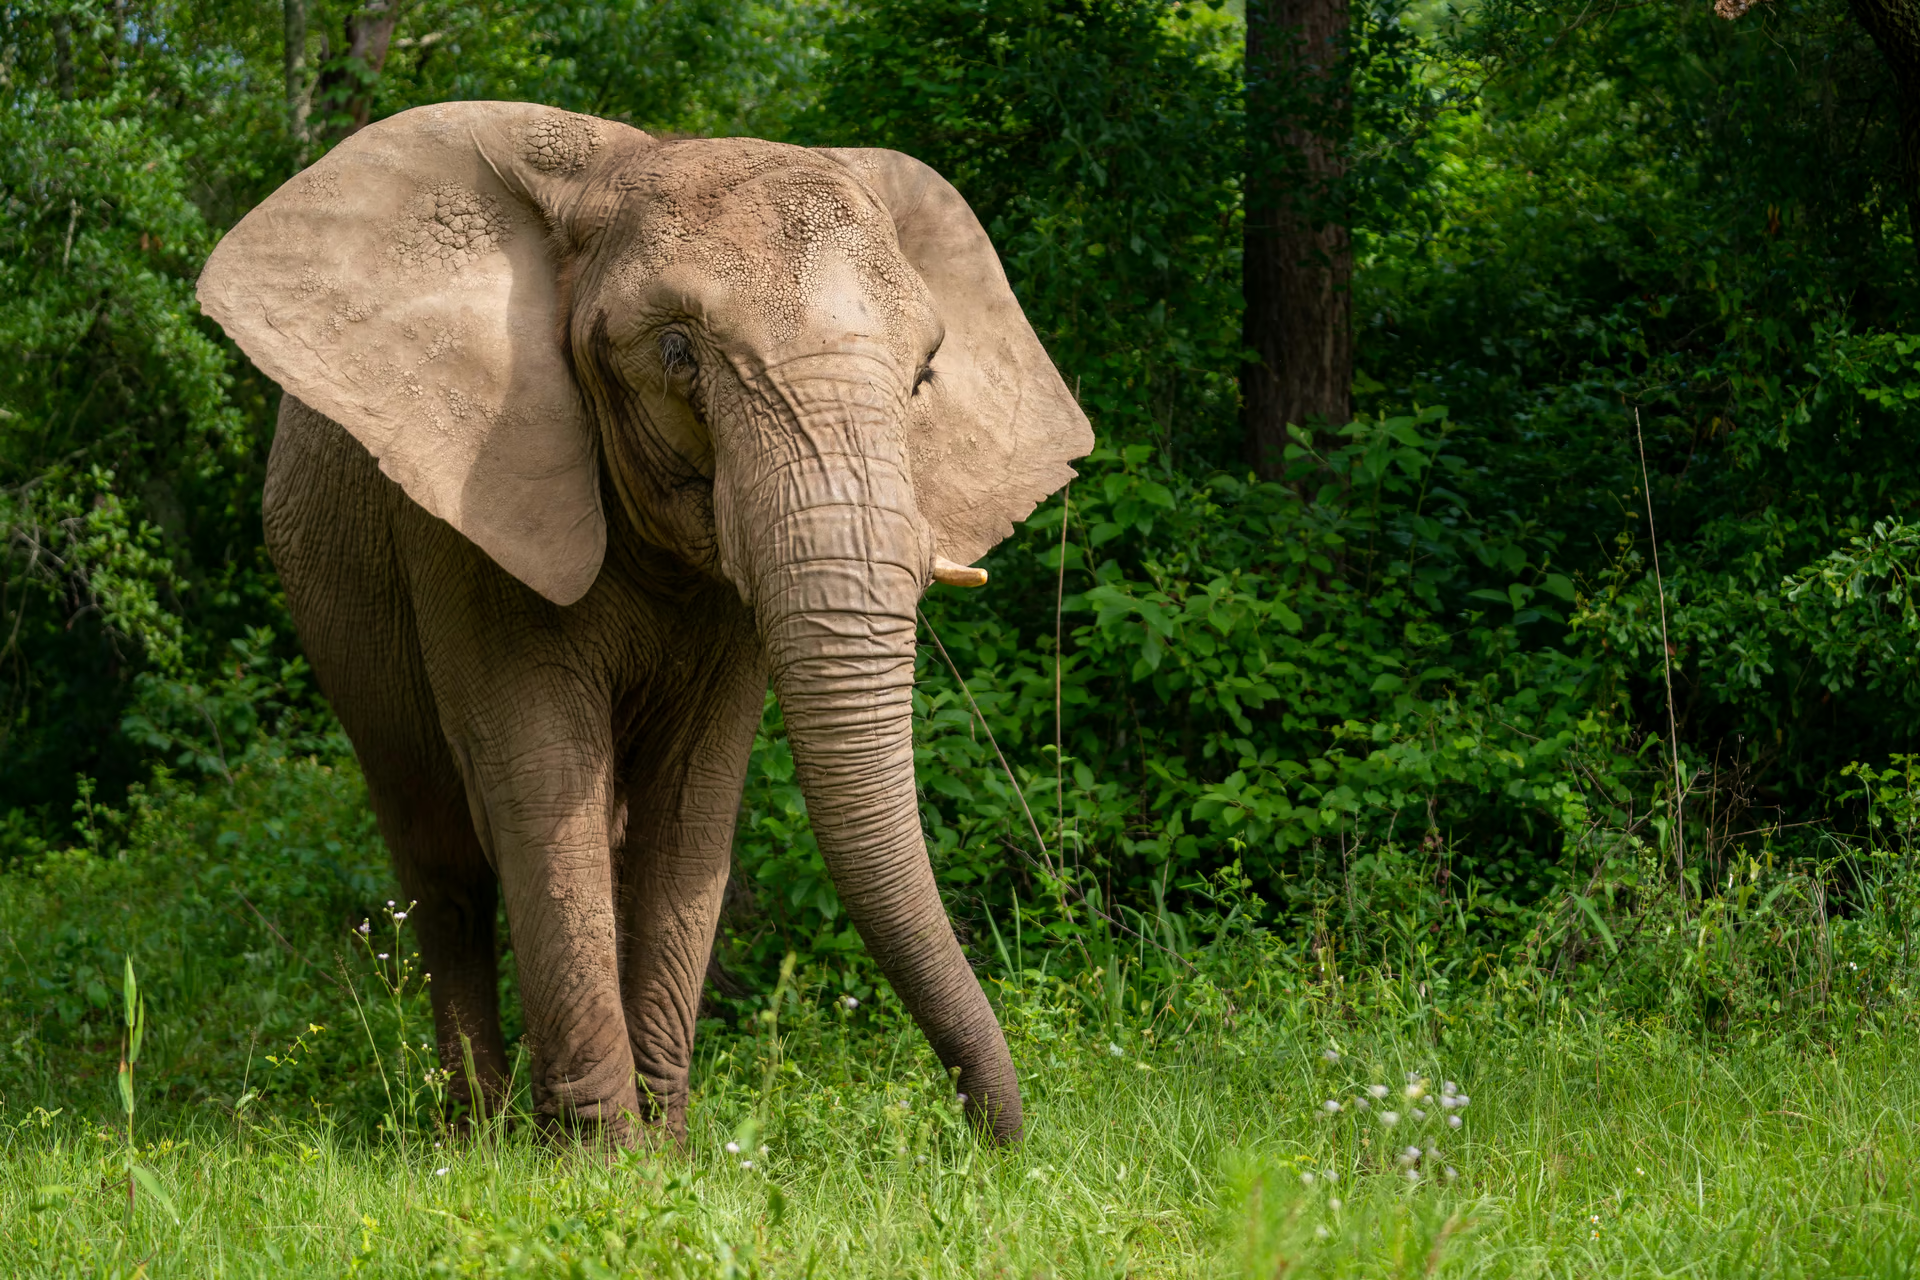
Foto de um elefante na natureza

Modelos multimodais com Hugging Face

VQA


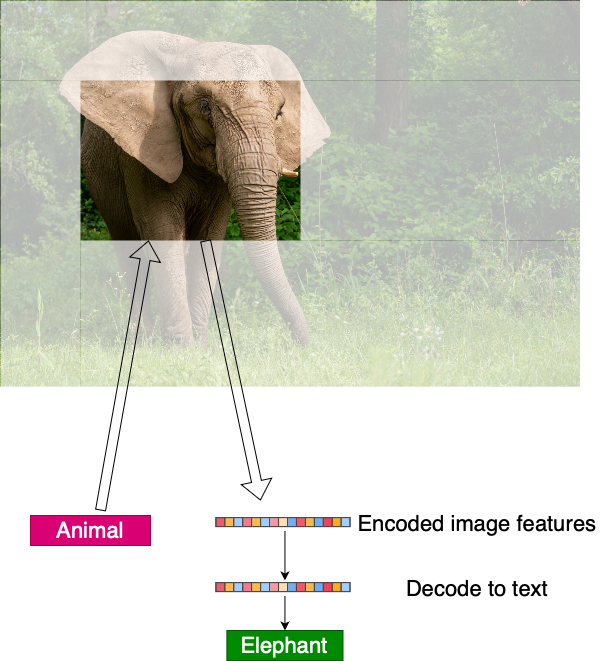
  • O modelo conhece recursos de imagem e texto de muitos objetos
  • Modelos reutilizáveis sem ajuste fino extra

Diagrama mostrando o foco em um animal e sua identificação

Modelos multimodais com Hugging Face

VQA

from transformers import ViltProcessor, ViltForQuestionAnswering


processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-vqa") model = ViltForQuestionAnswering.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
encoding = processor(image, text, return_tensors="pt")
outputs = model(**encoding)
idx = outputs.logits.argmax(-1).item()
print("Predicted answer:", model.config.id2label[idx])
Predicted answer: elephant
Modelos multimodais com Hugging Face

Document VQA

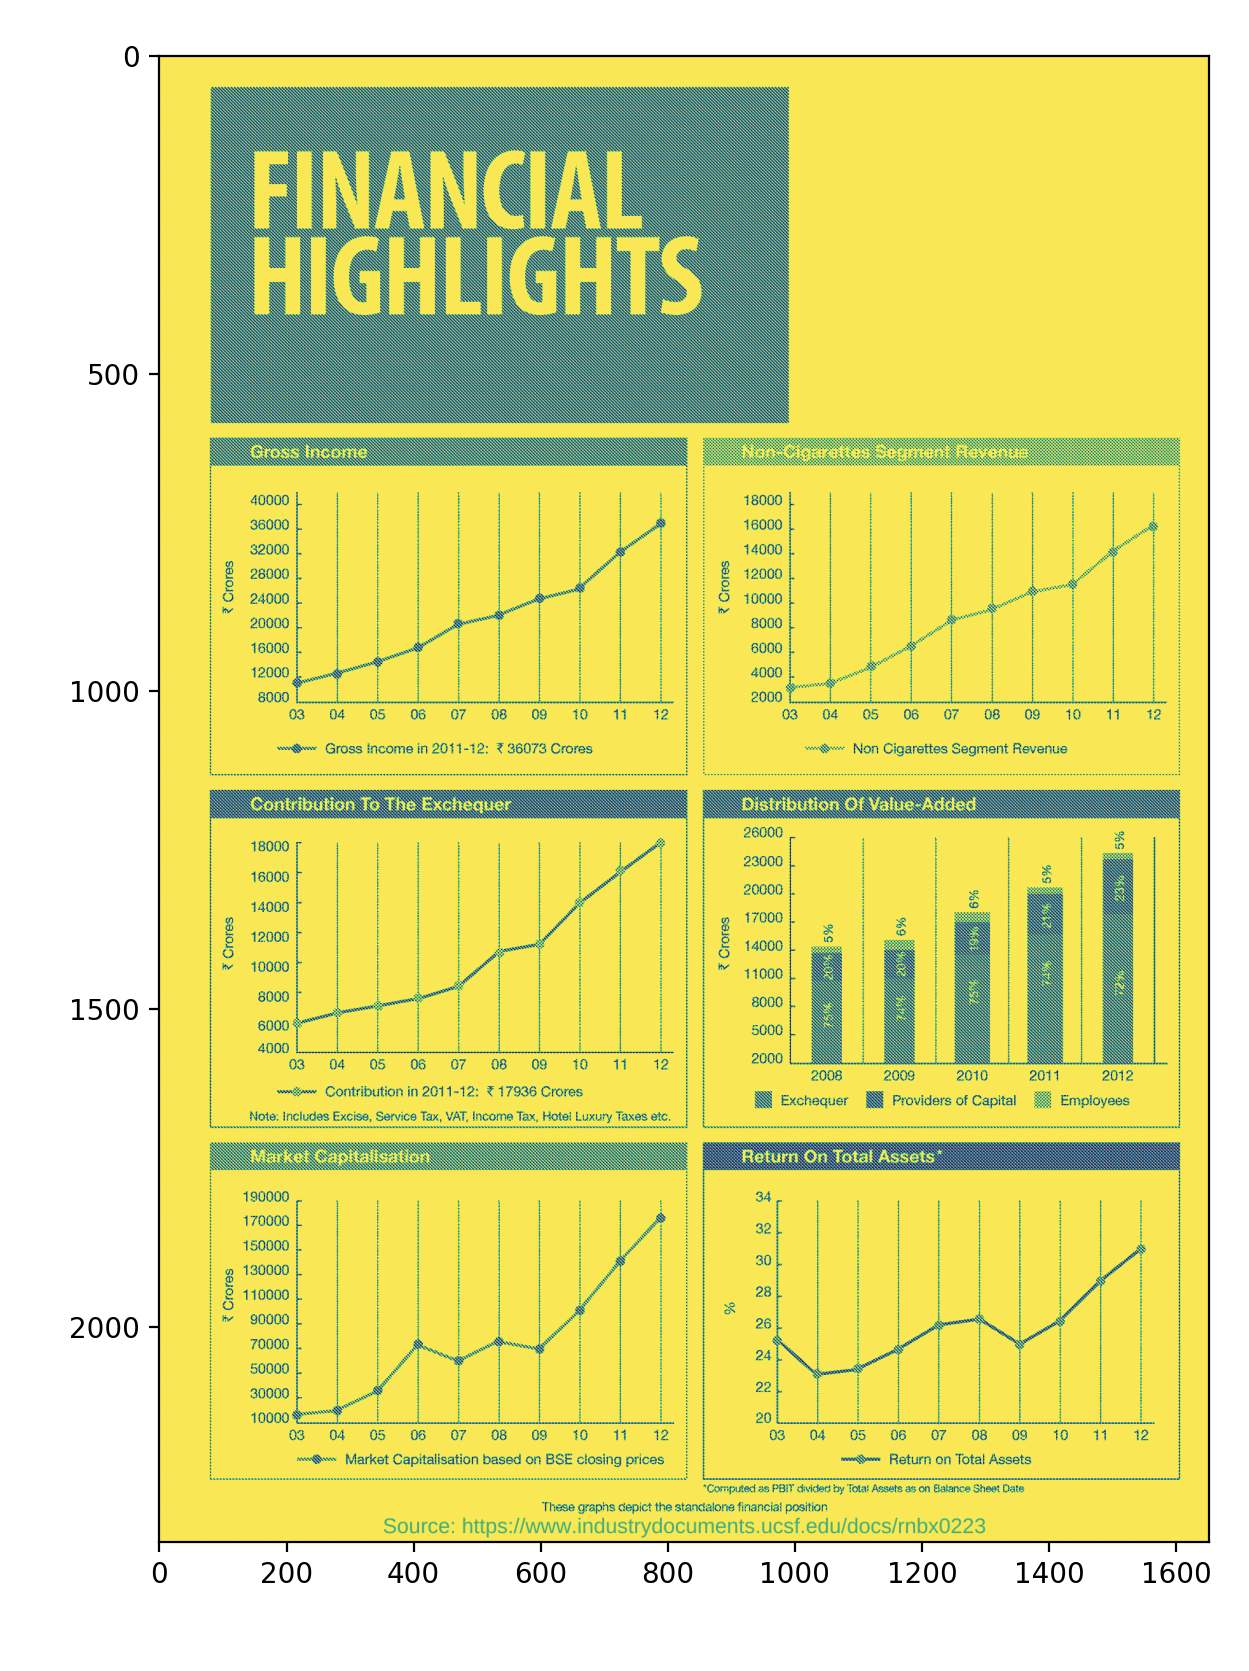
  • Extensão do VQA para detectar gráficos, tabelas e texto (OCR) em imagens
from datasets import load_dataset
from transformers import pipeline

dataset = load_dataset("lmms-lab/DocVQA")


import matplotlib.pyplot as plt plt.imshow(dataset["test"][2]["image"]) plt.show()

Imagem de documento com gráficos e diagramas de barras

Modelos multimodais com Hugging Face

Document VQA

Logo do Google Tesseract

  • Dependências extras para executar OCR
  • pytesseract instalado via pip
  • Tesseract OCR via instalador do pacote (ex.: apt-get, exe ou homebrew/macports)

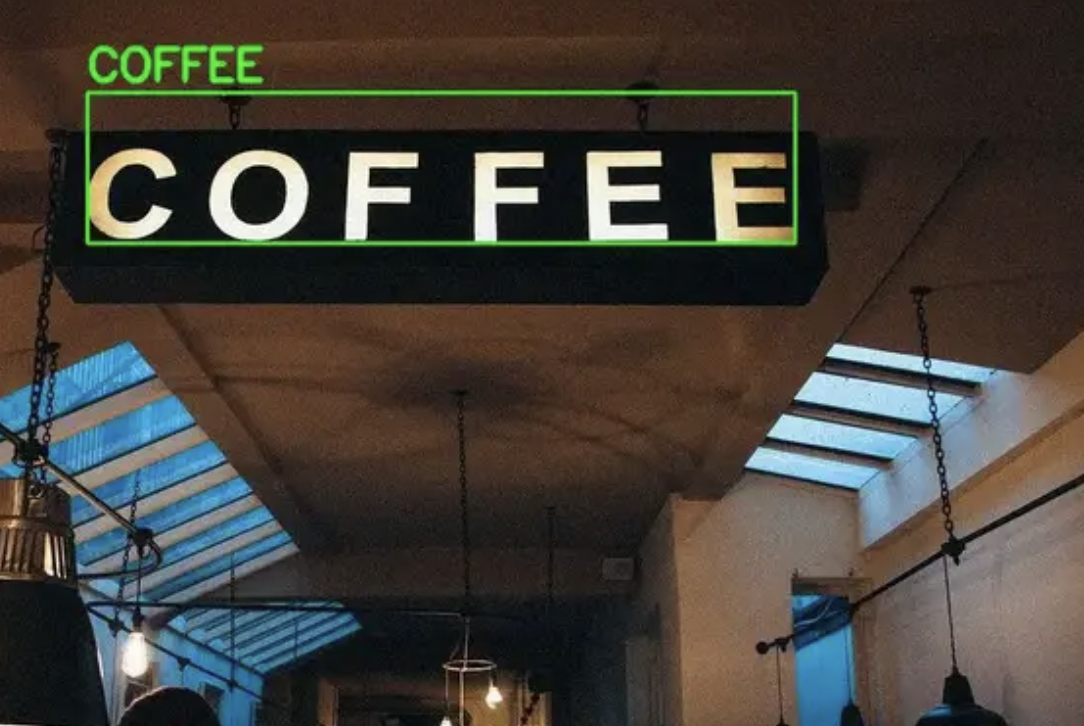
Foto de uma placa de café com o OCR

Modelos multimodais com Hugging Face

Document VQA

from transformers import pipeline
pipe = pipeline("document-question-answering", "impira/layoutlm-document-qa")

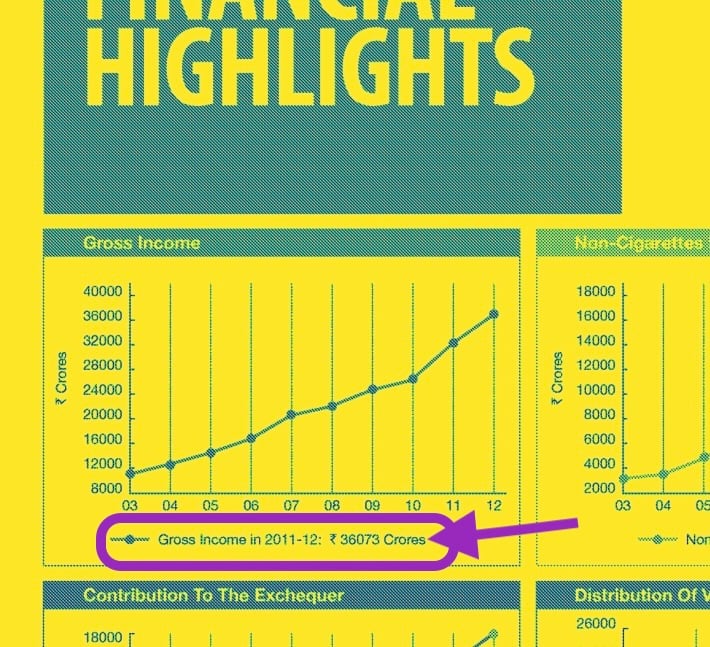
result = pipe( dataset["test"][2]["image"], "What was the gross income in 2011-2012?" )
Modelos multimodais com Hugging Face

Document VQA

print(result)
[{'score': 0.05149758607149124,
  'answer': '3 36073 Crores', ...}]

Imagem de documento com gráficos e diagramas de barras

Modelos multimodais com Hugging Face

Vamos praticar!

Modelos multimodais com Hugging Face

Preparing Video For Download...