Ajuste fino de modelos de texto para fala

Modelos multimodais com Hugging Face

James Chapman

Curriculum Manager, DataCamp

Objetivo do ajuste fino em texto para fala


  • Aprender sons em novos idiomas e dialetos
  • Aplicar a novos contextos

Ex.: grande modelo de pré-treinamento em inglês ⇏ fala italiana realista
balões de fala em inglês e italiano em desenho

Modelos multimodais com Hugging Face

Objetivo do ajuste fino em texto para fala
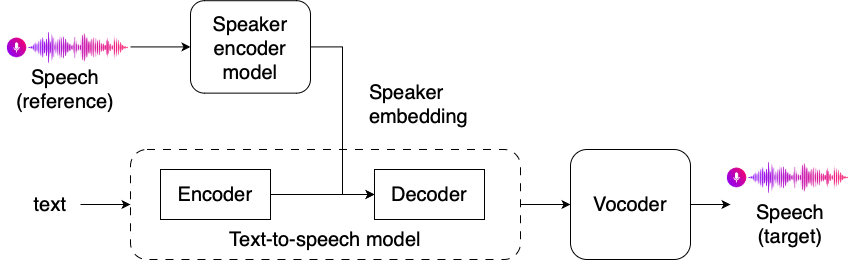
Diagrama de como um embedding de voz se encaixa no pipeline de geração de fala

  • Embedding de locutor + recursos do modelo TTS → modelo generativo
  • Novos embeddings de locutor, sozinhos, não bastam sem ajuste fino
Modelos multimodais com Hugging Face

Preparando um conjunto de áudio

Conjunto de dados VoxPopuli: fala transcrita em 18 idiomas do parlamento da UE

from datasets import load_dataset
dataset = load_dataset("facebook/voxpopuli", "it", split="train", 
                       trust_remote_code=True)
print(dataset.features)
['audio', 'raw_text', 'normalized_text', 'gender', 'speaker_id', ... ]
  • É preciso pré-processar o áudio + adicionar embeddings de voz:
speaker_model = EncoderClassifier.from_hparams(source="speechbrain/spkrec-xvect-voxceleb", 
                                       savedir="pretrained_models/spkrec-xvect-voxceleb")
Modelos multimodais com Hugging Face

Pré-processamento de áudio

from transformers import SpeechT5Processor
processor = SpeechT5Processor.from_pretrained("microsoft/speecht5_tts")


def prepare_dataset(example): audio = example["audio"] example = processor(text=example["normalized_text"], audio_target=audio["array"], sampling_rate=audio["sampling_rate"], return_attention_mask=False)
example["labels"] = example["labels"][0]
with torch.no_grad(): speaker_embeddings = speaker_model.encode_batch(torch.tensor(audio["array"])) speaker_embeddings = torch.nn.functional.normalize(speaker_embeddings, dim=2) example["speaker_embeddings"] = speaker_embeddings.squeeze().cpu().numpy() return example
dataset = dataset.map(prepare_dataset)
Modelos multimodais com Hugging Face

Parâmetros de treinamento

from transformers import Seq2SeqTrainingArguments


training_args = Seq2SeqTrainingArguments( per_device_train_batch_size=4,
gradient_accumulation_steps=8,
learning_rate=1e-5,
warmup_steps=500,
label_names=["labels"],
data_collator=data_collator )
Modelos multimodais com Hugging Face

Juntando tudo

model = SpeechT5ForTextToSpeech.from_pretrained("microsoft/speecht5_tts")
processor = SpeechT5Processor.from_pretrained("microsoft/speecht5_tts")
vocoder = SpeechT5HifiGan.from_pretrained("microsoft/speecht5_hifigan")

Treinador:

trainer = Seq2SeqTrainer(args=training_args, model=model,
    train_dataset=dataset["train"], eval_dataset=dataset["test"],
                         tokenizer=processor)

Execute o treinamento: trainer.train()

Modelos multimodais com Hugging Face

Usando o novo modelo

text = "se sono italiano posso cantare l'opera lirica"


speaker_embedding = torch.tensor(dataset[5]["speaker_embeddings"]).unsqueeze(0)
inputs = processor(text=text, return_tensors="pt")
speech = model.generate_speech(inputs["input_ids"], speaker_embedding, vocoder=vocoder)
make_spectrogram(speech)
Modelos multimodais com Hugging Face

Usando o novo modelo

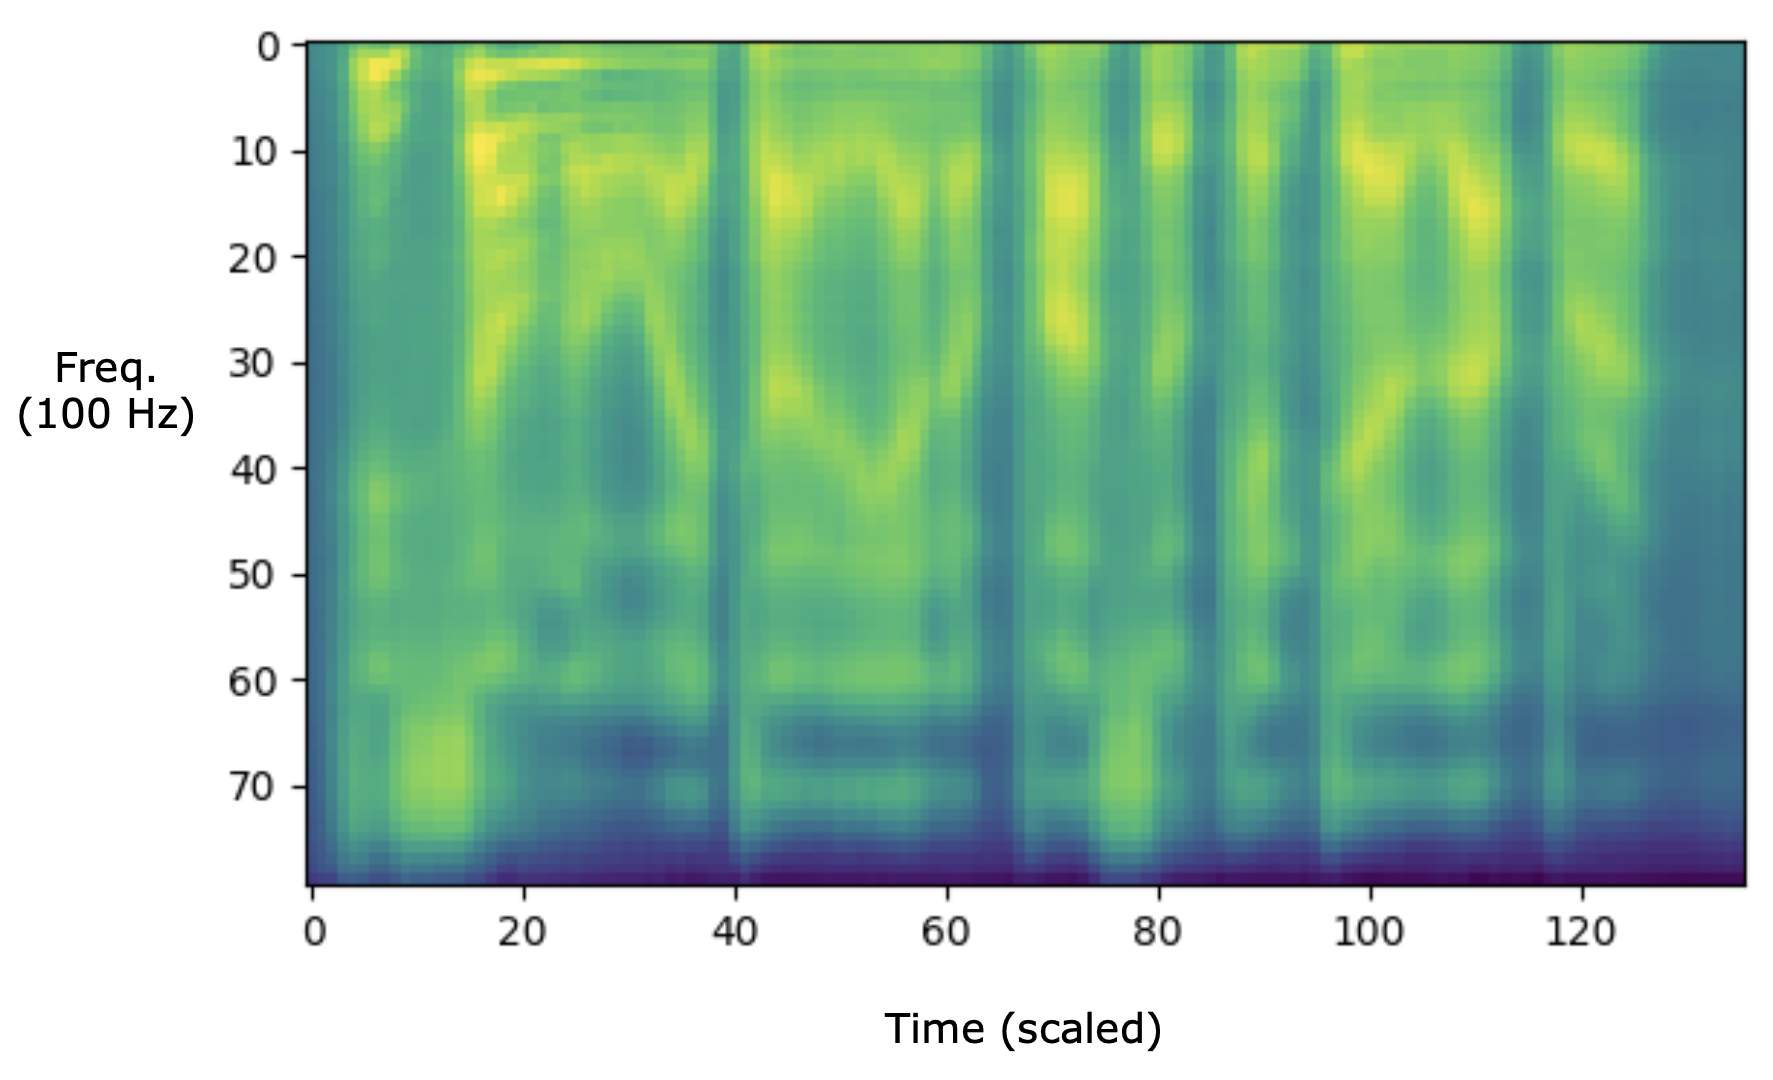
Espectrograma de fala em italiano

Modelos multimodais com Hugging Face

Vamos praticar!

Modelos multimodais com Hugging Face

Preparing Video For Download...