Reconnaissance vocale et génération audio

Modèles multimodaux avec Hugging Face

James Chapman

Curriculum Manager, DataCamp

Parole
 

Quelles sont les composantes clés des ondes vocales ?

  • Hauteur : fréquence moy. hommes 85–180 Hz, femmes 165–255 Hz
  • Accentuation : dépend de la langue, de l'accent et de l'émotion
  • Rythme : influencé par le contexte, l'émotion et la langue


Publication sur les réseaux sociaux

Modèles multimodaux avec Hugging Face

Reconnaissance automatique de la parole
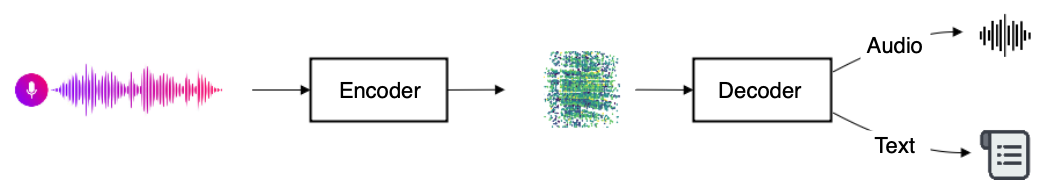
L'audio est encodé, puis décodé en audio ou en texte.

  • Le texte et l'audio sont tous deux séquentiels
  • Exemples : transcription, traduction, synthèse vocale
Modèles multimodaux avec Hugging Face

Reconnaissance automatique de la parole

  • Modèle tiny : 39 M de paramètres, taille 150 Mo
  • Données d'entraînement : 680 k heures (annotées)
from transformers import WhisperProcessor, WhisperForConditionalGeneration
processor = WhisperProcessor.from_pretrained("openai/whisper-tiny")
model = WhisperForConditionalGeneration.from_pretrained("openai/whisper-tiny")
1 https://github.com/openai/whisper
Modèles multimodaux avec Hugging Face

Reconnaissance automatique de la parole

from datasets import load_dataset, Audio
dataset = load_dataset("CSTR-Edinburgh/vctk")["train"]
dataset = dataset.cast_column("audio", Audio(sampling_rate=16_000))

sample = dataset[0]["audio"]
input_preprocessed = processor(sample["array"], sampling_rate=sample["sampling_rate"], return_tensors="pt")
predicted_ids = model.generate(input_preprocessed.input_features)
transcription = processor.batch_decode(predicted_ids, skip_special_tokens=True) print(transcription)
['Please cool Stella.']
Modèles multimodaux avec Hugging Face

Génération audio

Trois composants pour générer de l'audio :

  • Préprocesseur : rééchantillonnage et extraction de caractéristiques
  • Modèle : transformation des caractéristiques
  • Vocodeur : modèle génératif séparé pour les formes d'onde audio
from transformers import SpeechT5Processor, SpeechT5ForSpeechToSpeech, SpeechT5HifiGan

processor = SpeechT5Processor.from_pretrained("microsoft/speecht5_vc") model = SpeechT5ForSpeechToSpeech.from_pretrained("microsoft/speecht5_vc") vocoder = SpeechT5HifiGan.from_pretrained("microsoft/speecht5_hifigan")
Modèles multimodaux avec Hugging Face

Représentations de la parole

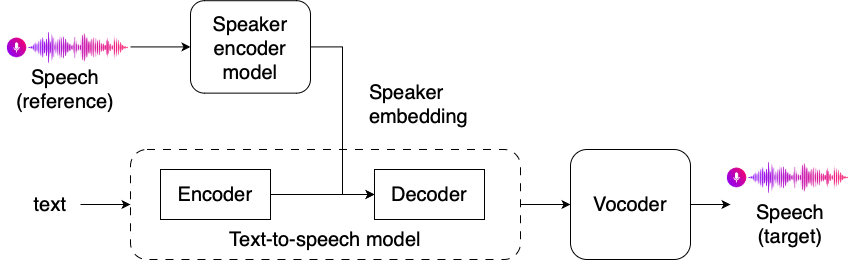
Schéma illustrant l'intégration vocale dans une chaîne de génération de parole

Modèles multimodaux avec Hugging Face

Générer des embeddings de locuteur

  • Encodeur pré-entraîné : tableau d'onde audio → tableau encodé (souvent 512 dimensions)
from speechbrain.inference.speaker import EncoderClassifier
speaker_model = EncoderClassifier.from_hparams(source="speechbrain/spkrec-xvect-voxceleb")
speaker_embeddings = speaker_model.encode_batch(torch.tensor(dataset[0]["audio"]["array"]))

speaker_embeddings = torch.nn.functional.normalize(speaker_embeddings, dim=2).unsqueeze(0)
Modèles multimodaux avec Hugging Face

Génération audio

inputs = processor(audio=dataset[0]["audio"], 
                   sampling_rate=dataset[0]["audio"]["sampling_rate"], 
                   return_tensors="pt")


speech = model.generate_speech(inputs["input_values"], speaker_embedding, vocoder=vocoder)
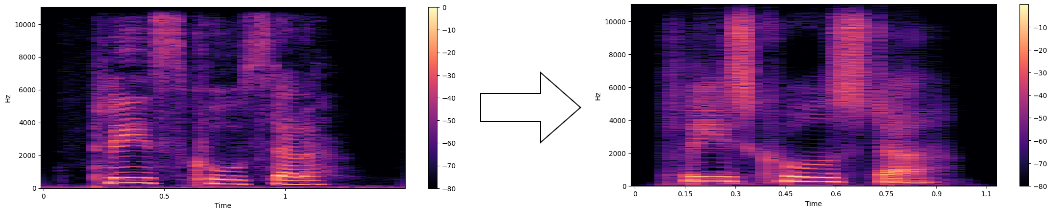
Spectrogramme avant et après

Modèles multimodaux avec Hugging Face

Passons à la pratique !

Modèles multimodaux avec Hugging Face

Preparing Video For Download...