Visual question-answering (VQA)

Modèles multimodaux avec Hugging Face

James Chapman

Curriculum Manager, DataCamp

Tâches de QA multimodales
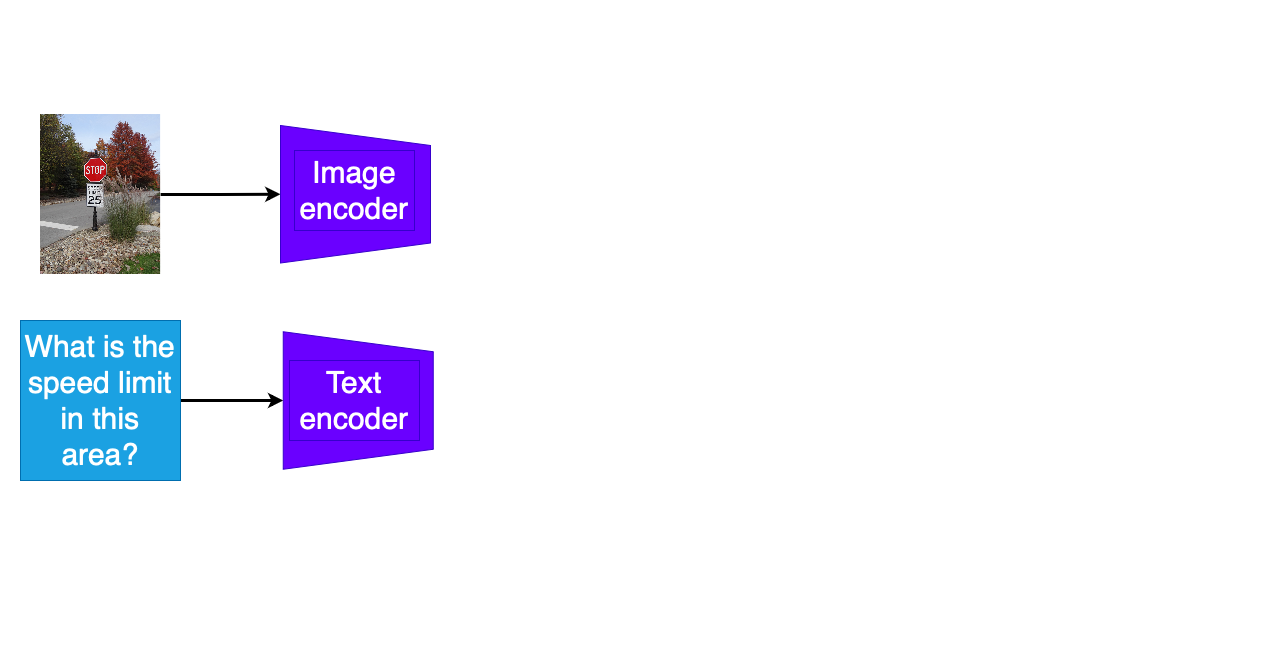
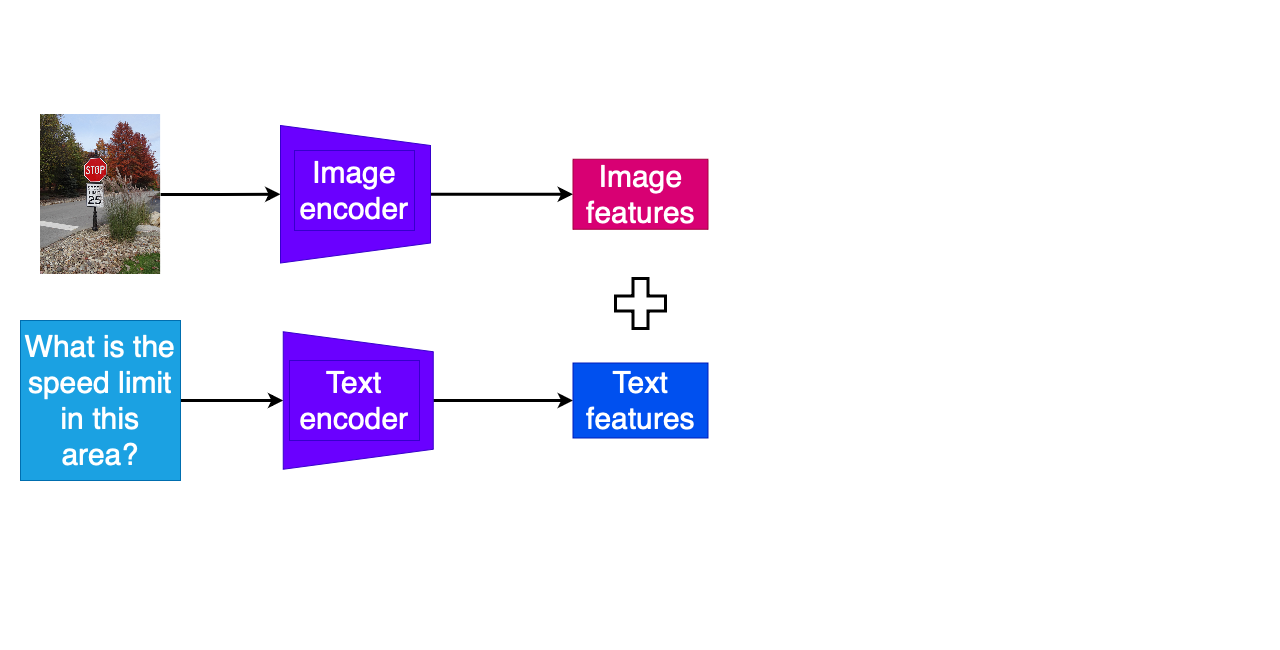
Schéma montrant le traitement de l'image et du texte dans un modèle VQA

  1. Encodage séparé de la question et de l'autre modalité
Modèles multimodaux avec Hugging Face

Tâches de QA multimodales

Schéma montrant le traitement de l'image et du texte dans un modèle VQA

  1. Encodage séparé de la question et de l'autre modalité
  2. Combinaison des caractéristiques encodées
Modèles multimodaux avec Hugging Face

Tâches de QA multimodales

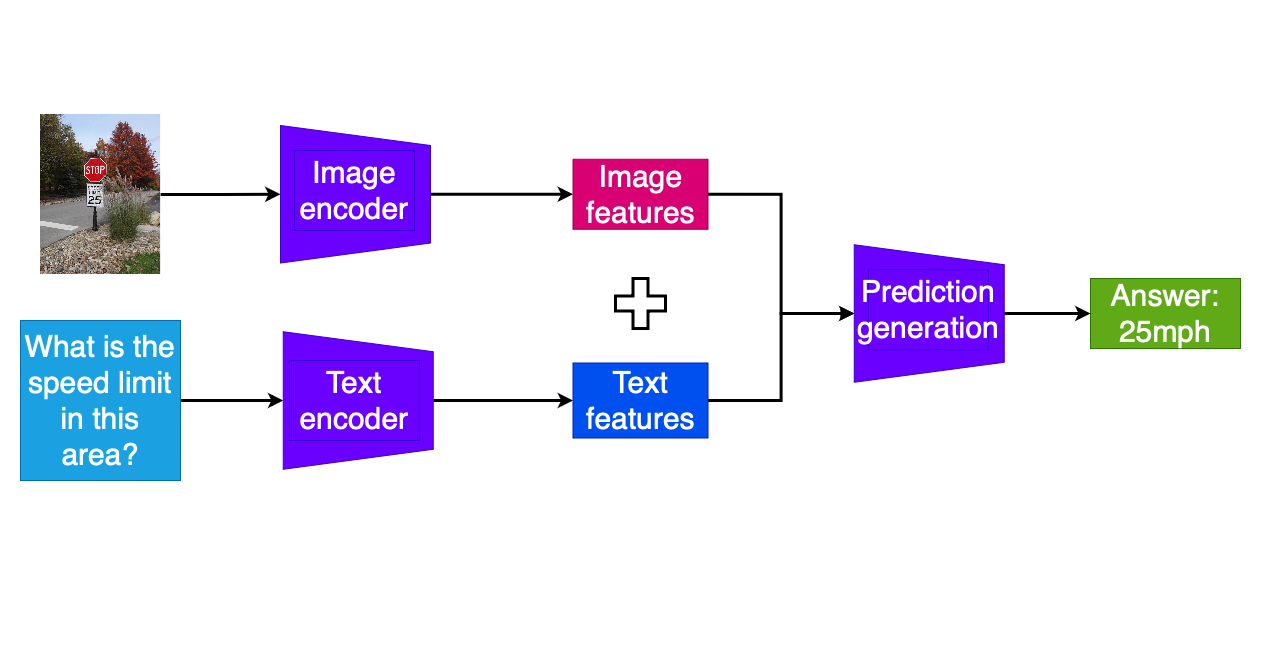
Schéma montrant le traitement de l'image et du texte dans un modèle VQA

  1. Encodage séparé de la question et de l'autre modalité
  2. Combinaison des caractéristiques encodées
  3. Couches supplémentaires pour prédire les jetons de réponse
Modèles multimodaux avec Hugging Face

VQA

import requests
from PIL import Image

url = "https://www.worldanimalprotection
.org/cdn-cgi/image/width=1920,format=
auto/globalassets/images/elephants/1
033551-elephant.jpg"


image = Image.open(requests.get(url, stream=True).raw)
text = "What animal is in this photo?"

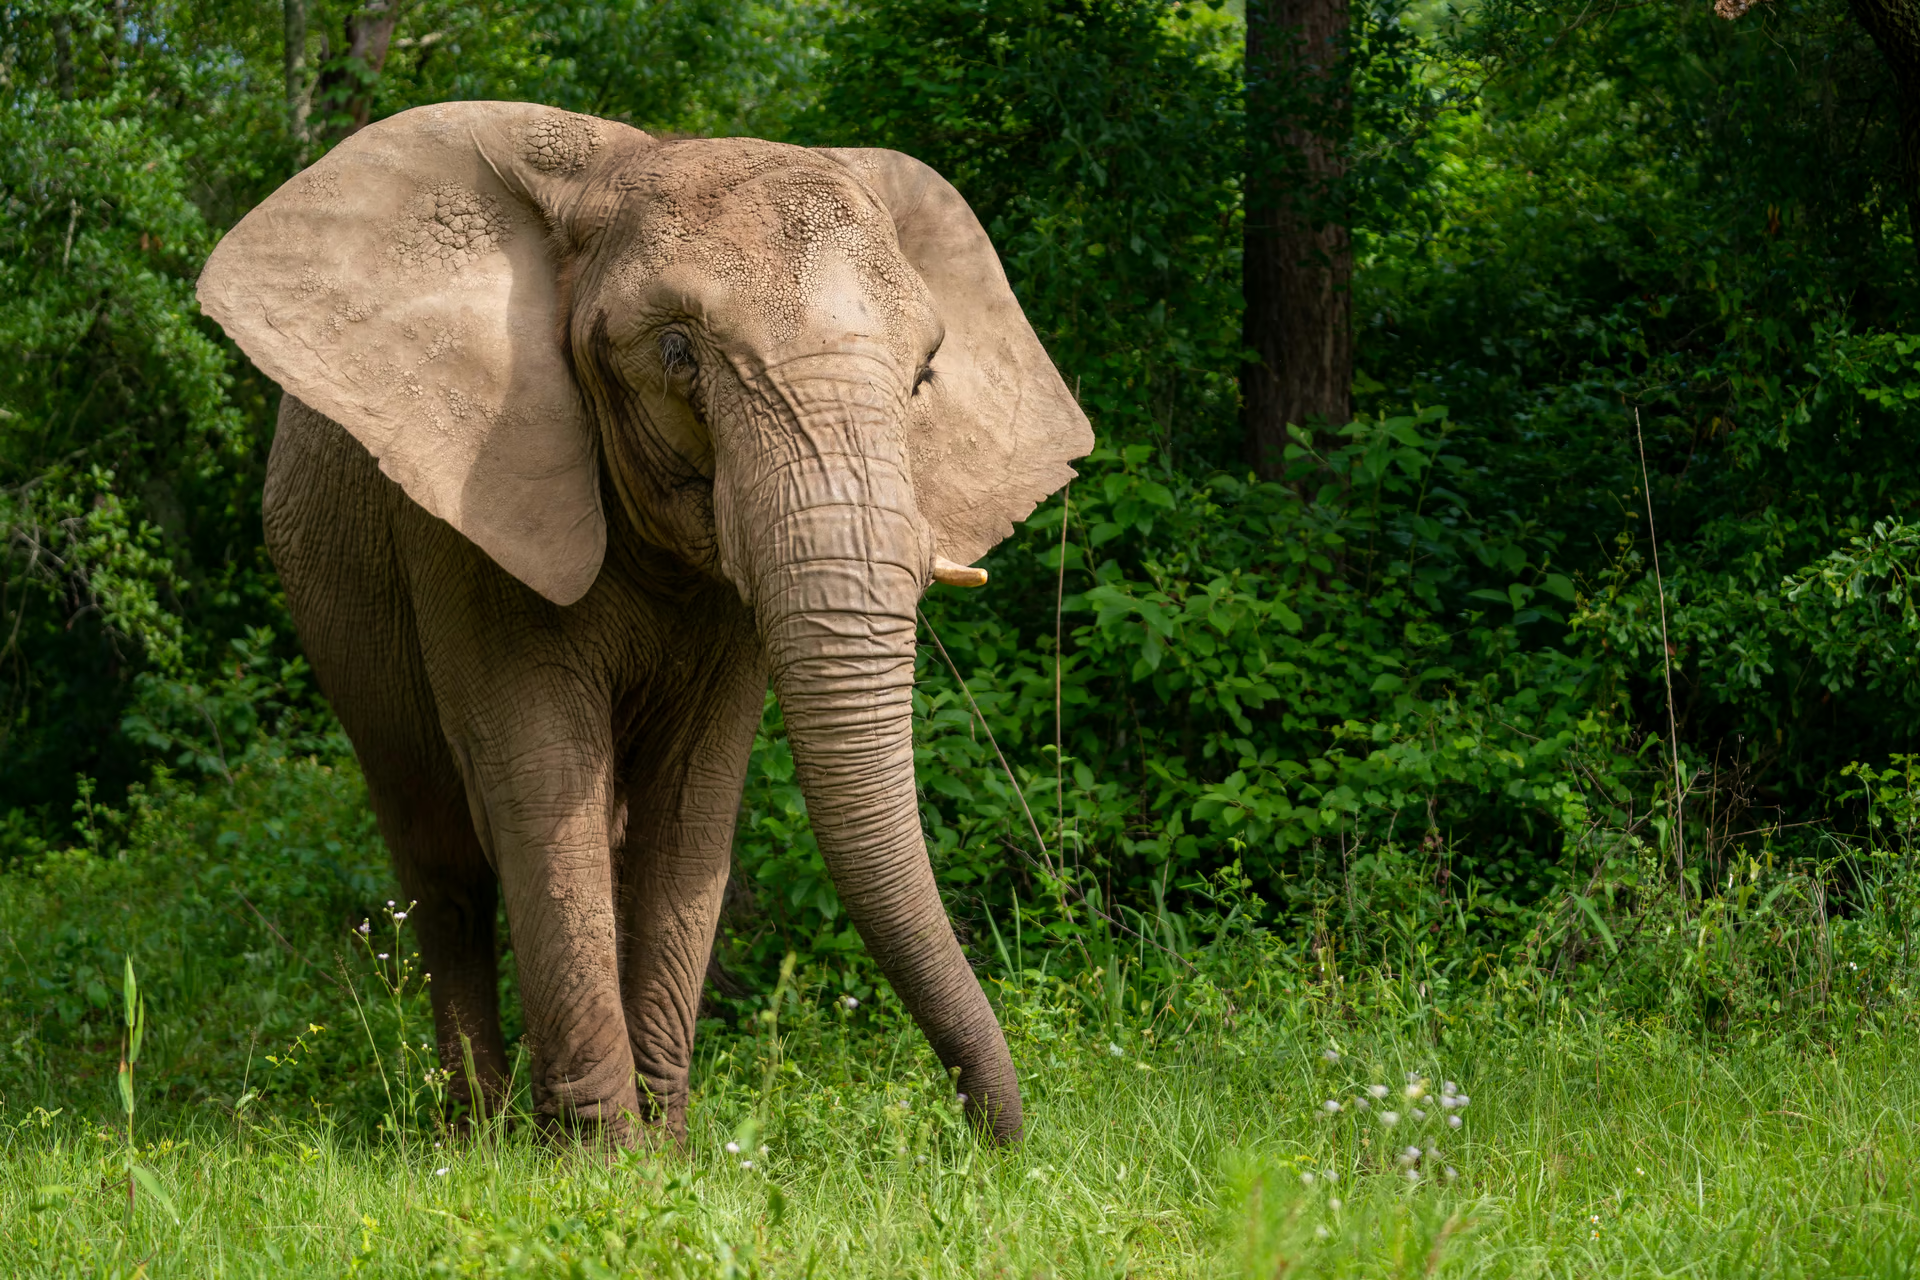
Photo d'un éléphant dans la nature

Modèles multimodaux avec Hugging Face

VQA


  • Le modèle connaît des caractéristiques image et texte de nombreux objets
  • Modèles réutilisables sans affinage supplémentaire

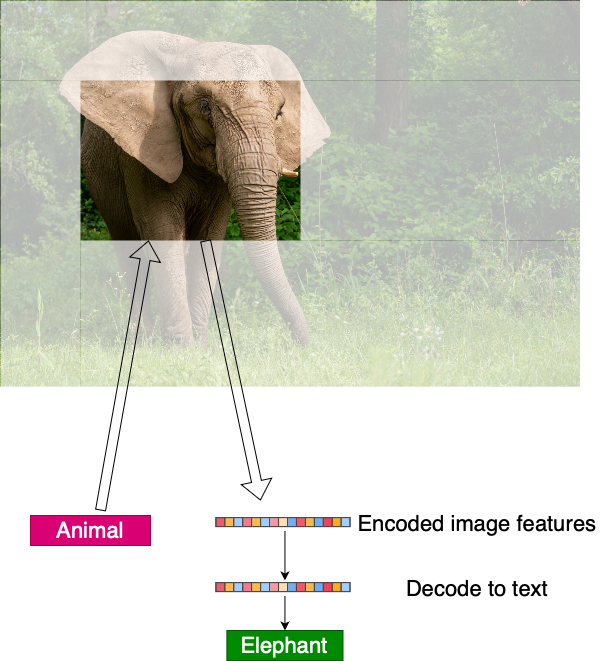
Schéma montrant la focalisation sur un animal et son identification

Modèles multimodaux avec Hugging Face

VQA

from transformers import ViltProcessor, ViltForQuestionAnswering


processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-vqa") model = ViltForQuestionAnswering.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
encoding = processor(image, text, return_tensors="pt")
outputs = model(**encoding)
idx = outputs.logits.argmax(-1).item()
print("Predicted answer:", model.config.id2label[idx])
Predicted answer: elephant
Modèles multimodaux avec Hugging Face

Document VQA

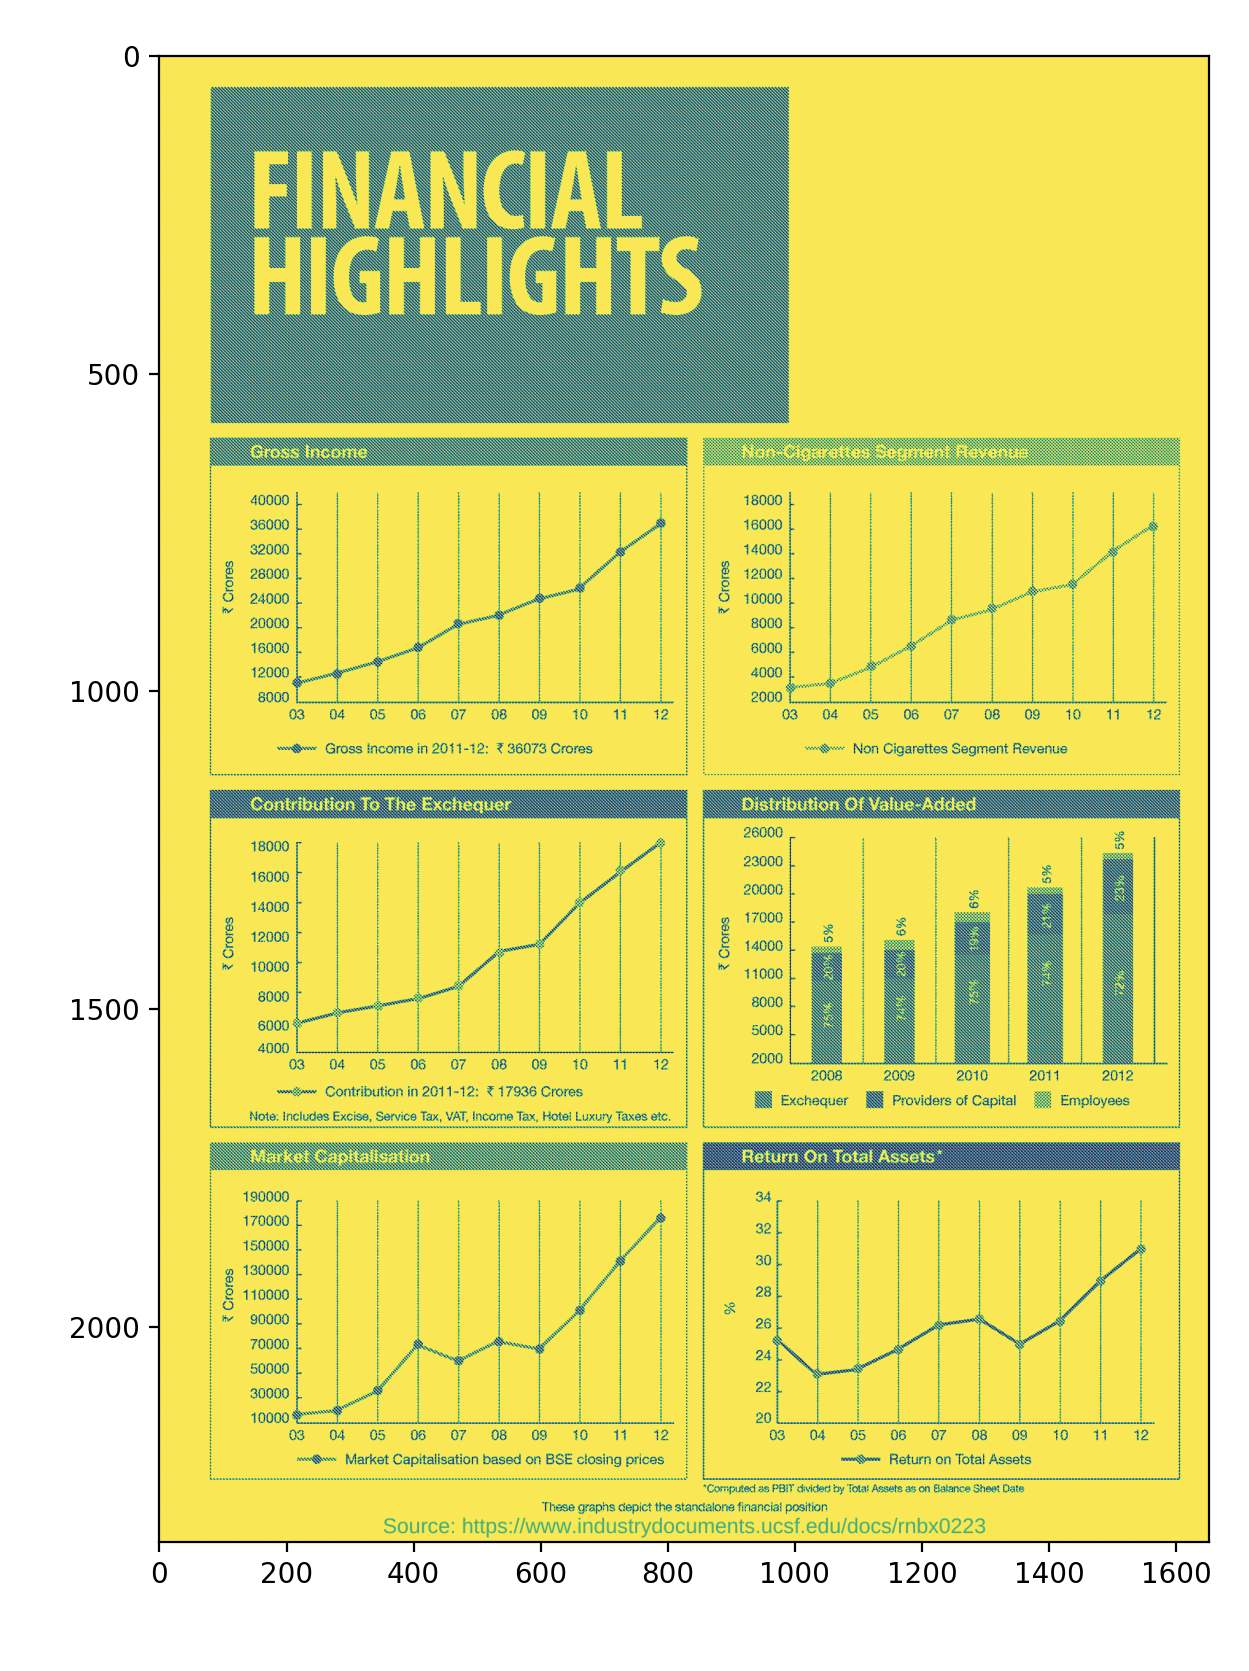
  • Extension de la VQA pour détecter graphiques, tableaux et texte (OCR) dans les images
from datasets import load_dataset
from transformers import pipeline

dataset = load_dataset("lmms-lab/DocVQA")


import matplotlib.pyplot as plt plt.imshow(dataset["test"][2]["image"]) plt.show()

Image d'un document avec graphiques et histogrammes

Modèles multimodaux avec Hugging Face

Document VQA

Logo Google Tesseract

  • Dépendances supplémentaires nécessaires pour exécuter l'OCR
  • pytesseract installé via pip
  • Tesseract OCR via gestionnaire d'installation installer (p. ex. apt-get, exe ou homebrew/macports)

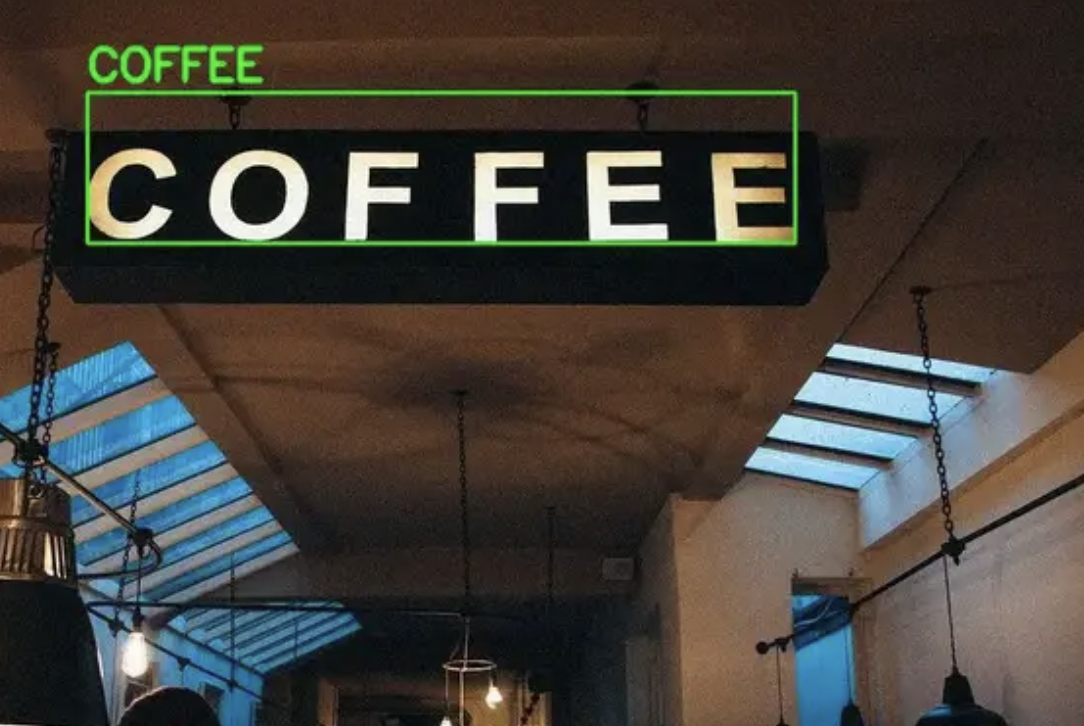
Photo d'une enseigne « coffee » avec l'OCR

Modèles multimodaux avec Hugging Face

Document VQA

from transformers import pipeline
pipe = pipeline("document-question-answering", "impira/layoutlm-document-qa")

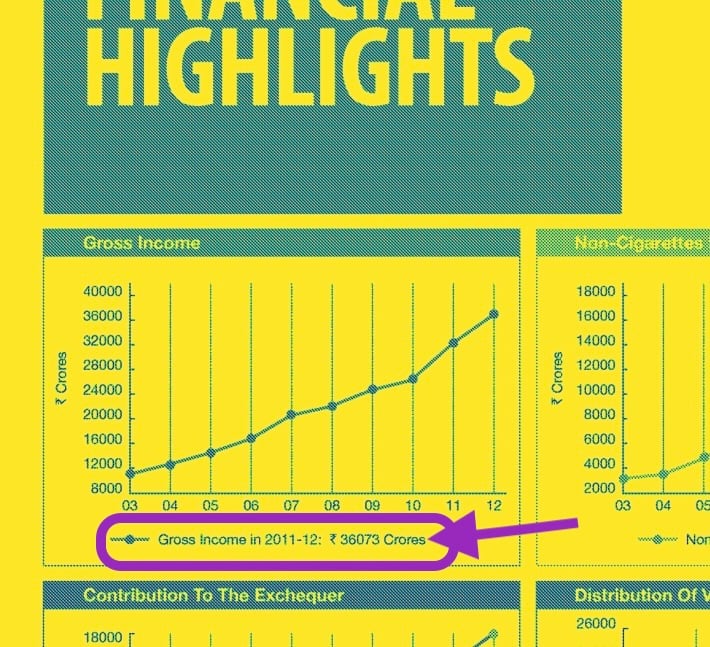
result = pipe( dataset["test"][2]["image"], "What was the gross income in 2011-2012?" )
Modèles multimodaux avec Hugging Face

Document VQA

print(result)
[{'score': 0.05149758607149124,
  'answer': '3 36073 Crores', ...}]

Image d'un document avec graphiques et histogrammes

Modèles multimodaux avec Hugging Face

Passons à la pratique !

Modèles multimodaux avec Hugging Face

Preparing Video For Download...