Ajuster des modèles de synthèse vocale

Modèles multimodaux avec Hugging Face

James Chapman

Curriculum Manager, DataCamp

Objectif de l'ajustement pour la synthèse vocale


  • Apprendre des sons de nouvelles langues et dialectes
  • Les appliquer à de nouveaux contextes

Ex. : grand modèle anglais préentraîné ⇏ parole italienne réaliste
bulles de dialogue anglais et italien en dessin

Modèles multimodaux avec Hugging Face

Objectif de l'ajustement pour la synthèse vocale
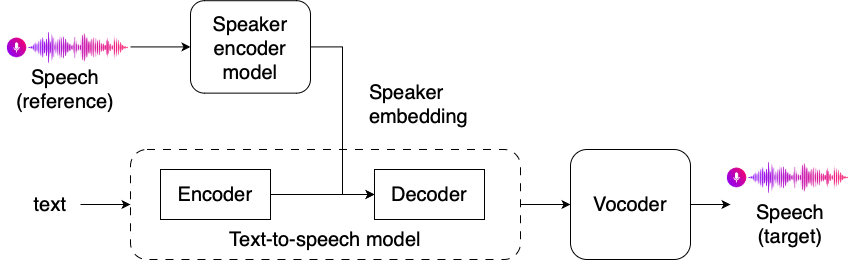
Diagramme montrant l'intégration de locuteur dans une chaîne de génération vocale

  • Intégration de locuteur + caractéristiques du modèle TTS → modèle génératif
  • Une nouvelle intégration de locuteur ne suffit pas seule sans ajustement
Modèles multimodaux avec Hugging Face

Préparer un jeu de données audio

Jeu de données VoxPopuli : parole transcrite en 18 langues du Parlement européen

from datasets import load_dataset
dataset = load_dataset("facebook/voxpopuli", "it", split="train", 
                       trust_remote_code=True)
print(dataset.features)
['audio', 'raw_text', 'normalized_text', 'gender', 'speaker_id', ... ]
  • Prétraiter l'audio + ajouter des embeddings de locuteur :
speaker_model = EncoderClassifier.from_hparams(source="speechbrain/spkrec-xvect-voxceleb", 
                                       savedir="pretrained_models/spkrec-xvect-voxceleb")
Modèles multimodaux avec Hugging Face

Prétraitement audio

from transformers import SpeechT5Processor
processor = SpeechT5Processor.from_pretrained("microsoft/speecht5_tts")


def prepare_dataset(example): audio = example["audio"] example = processor(text=example["normalized_text"], audio_target=audio["array"], sampling_rate=audio["sampling_rate"], return_attention_mask=False)
example["labels"] = example["labels"][0]
with torch.no_grad(): speaker_embeddings = speaker_model.encode_batch(torch.tensor(audio["array"])) speaker_embeddings = torch.nn.functional.normalize(speaker_embeddings, dim=2) example["speaker_embeddings"] = speaker_embeddings.squeeze().cpu().numpy() return example
dataset = dataset.map(prepare_dataset)
Modèles multimodaux avec Hugging Face

Paramètres d'entraînement

from transformers import Seq2SeqTrainingArguments


training_args = Seq2SeqTrainingArguments( per_device_train_batch_size=4,
gradient_accumulation_steps=8,
learning_rate=1e-5,
warmup_steps=500,
label_names=["labels"],
data_collator=data_collator )
Modèles multimodaux avec Hugging Face

Assembler le tout

model = SpeechT5ForTextToSpeech.from_pretrained("microsoft/speecht5_tts")
processor = SpeechT5Processor.from_pretrained("microsoft/speecht5_tts")
vocoder = SpeechT5HifiGan.from_pretrained("microsoft/speecht5_hifigan")

Entraîneur :

trainer = Seq2SeqTrainer(args=training_args, model=model,
    train_dataset=dataset["train"], eval_dataset=dataset["test"],
                         tokenizer=processor)

Lancez l'entraînement : trainer.train()

Modèles multimodaux avec Hugging Face

Utiliser le nouveau modèle

text = "se sono italiano posso cantare l'opera lirica"


speaker_embedding = torch.tensor(dataset[5]["speaker_embeddings"]).unsqueeze(0)
inputs = processor(text=text, return_tensors="pt")
speech = model.generate_speech(inputs["input_ids"], speaker_embedding, vocoder=vocoder)
make_spectrogram(speech)
Modèles multimodaux avec Hugging Face

Utiliser le nouveau modèle

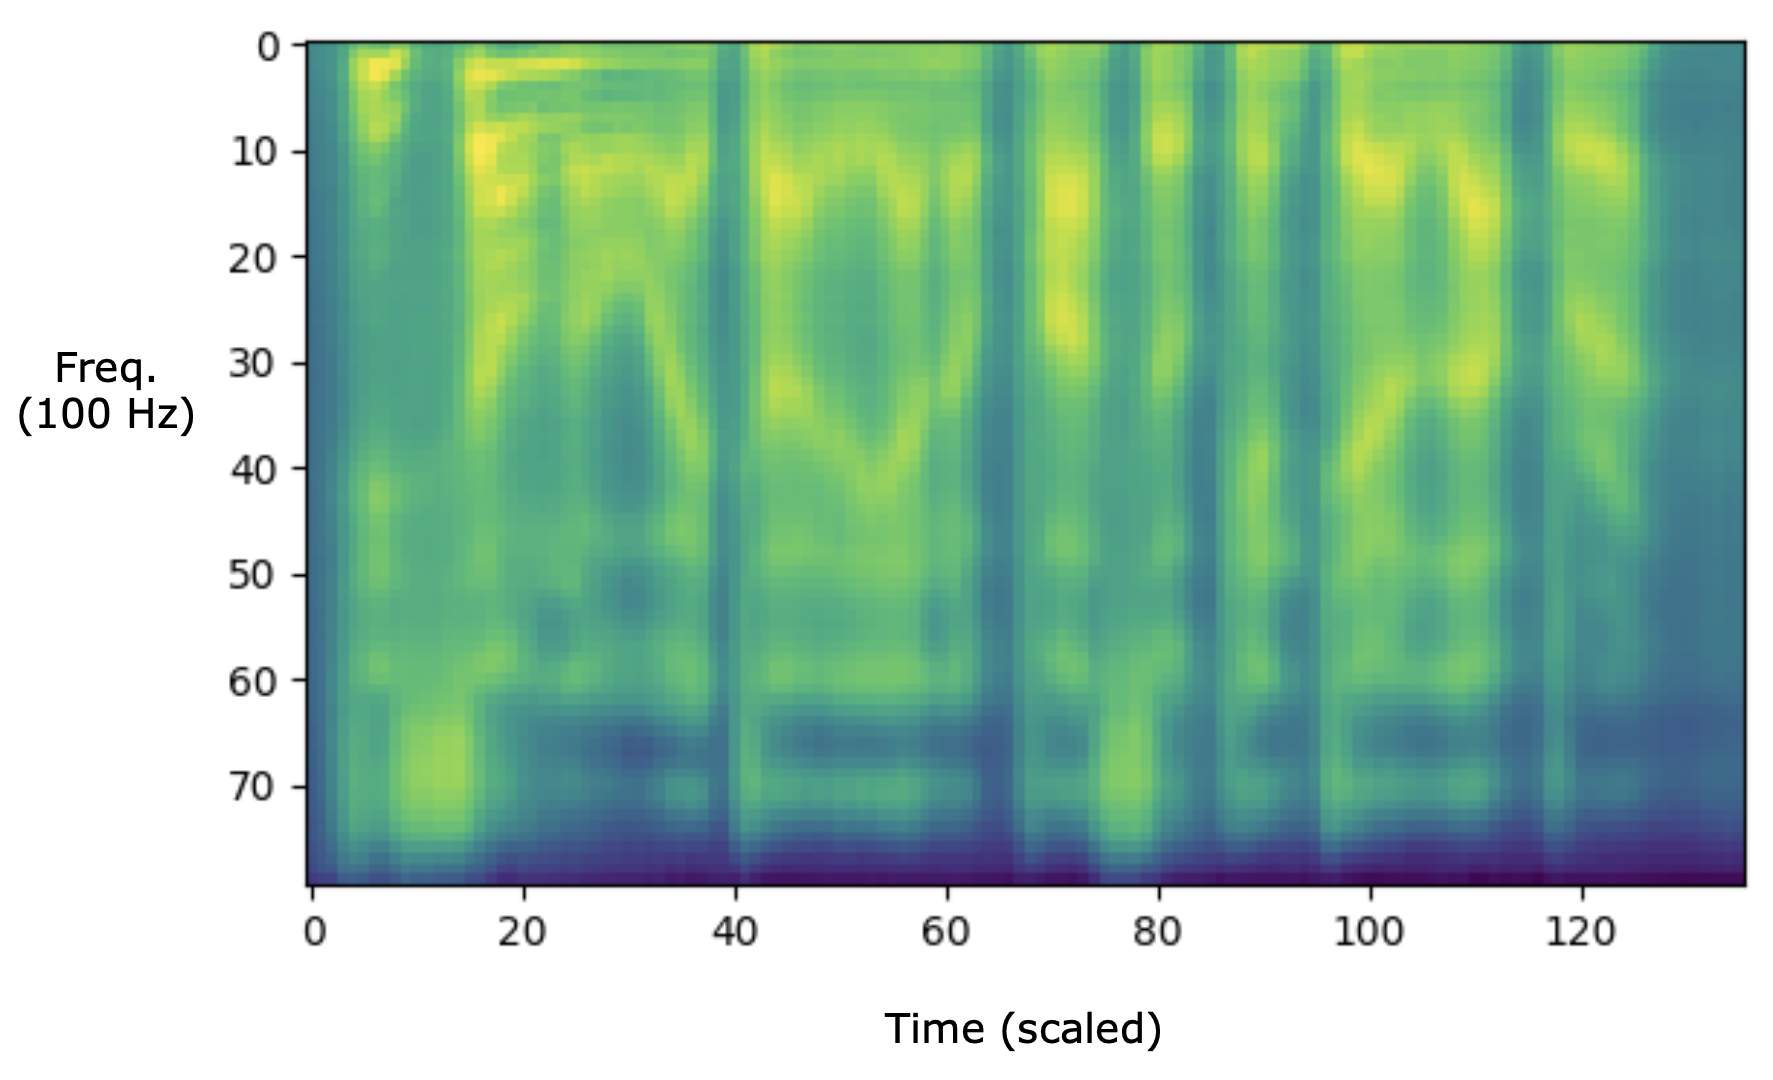
Spectrogramme de parole italienne

Modèles multimodaux avec Hugging Face

Passons à la pratique !

Modèles multimodaux avec Hugging Face

Preparing Video For Download...