Générer du texte avec des modèles de langue

Introduction à Amazon Bedrock

Nikhil Rangarajan

Data Scientist

Envoyer des prompts aux modèles de langue
  • Prompt : le texte d’entrée envoyé au modèle
    • "Explain how AWS Lambda works"

Une icône représentant le prompt.

Introduction à Amazon Bedrock

Envoyer des prompts aux modèles de langue
  • Prompt : le texte d’entrée envoyé au modèle
    • "Explain how AWS Lambda works"
  • Completion : le texte généré par le modèle
    • "AWS Lambda is a serverless compute service that..."

Icônes représentant le prompt et la completion.

Introduction à Amazon Bedrock

Envoyer des prompts aux modèles de langue
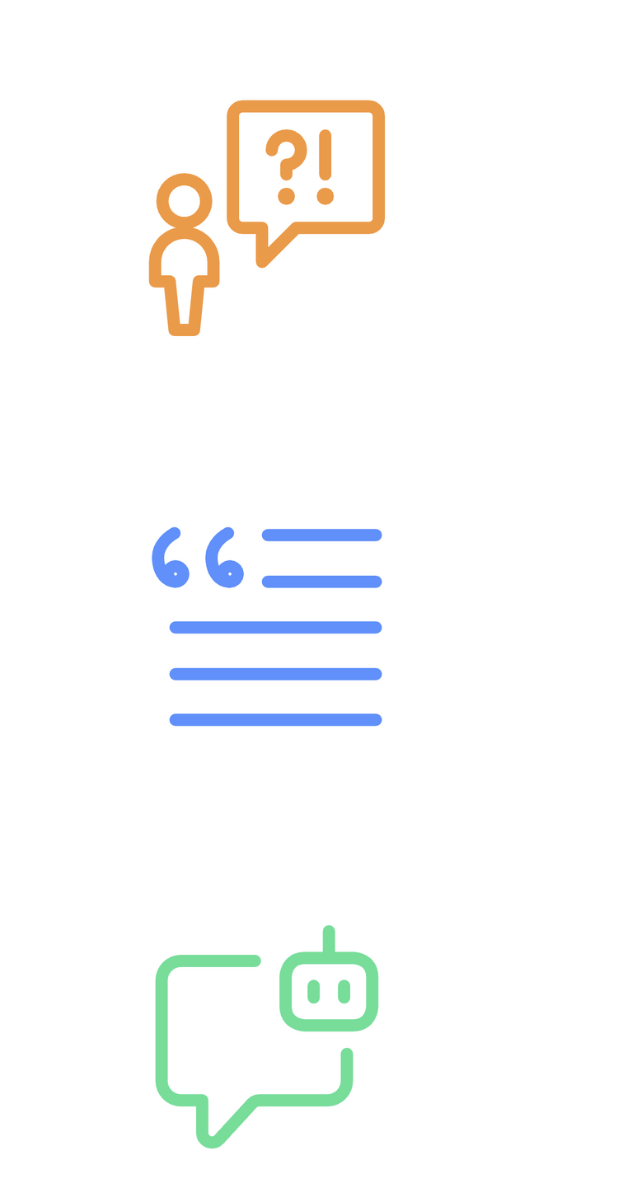
  • Prompt : le texte d’entrée envoyé au modèle
    • "Explain how AWS Lambda works"
  • Completion : le texte généré par le modèle
    • "AWS Lambda is a serverless compute service that..."
  • Response :
    • Texte généré (completion)
    • Métadonnées (tokens, infos modèle)
    • Informations de statut

Trois icônes en séquence représentant le prompt, la completion et la réponse.

Introduction à Amazon Bedrock

Appliquer des techniques de base de prompt engineering

  • Techniques pour de meilleurs résultats :
    • Clarté et précision : consignes détaillées et exactes
    • Attribution de rôle : donner une persona pour le contexte
    • Instructions de formatage : ajouter des contraintes pour guider la réponse
"Explain the benefits of exercise 
in simple terms."
"You are a nutritionist. Explain the 
benefits of a balanced diet."
"List the top 3 benefits of cloud 
computing in bullet points."
Introduction à Amazon Bedrock

Techniques avancées d’analyse de texte

  • Gérer les clés manquantes ou inattendues
data = json.loads(response['body'].read())
if 'completion' in data:
    output = data['completion']

else: output = "Key not found"
  • Analyse JSON multi-niveaux pour naviguer dans des structures imbriquées
try:
    nova_output = data.decode()["output"]

except (KeyError, IndexError) as e: nova_output = f"Error: {str(e)}"
Introduction à Amazon Bedrock

Traitement des réponses et gestion du texte

  • Problèmes Unicode/encodage : gérer les caractères spéciaux dans les réponses
    # Ensure proper encoding
    output = data['completion'].encode('utf-8').decode('unicode_escape')
    print(output)
    
  • Grandes réponses : scinder ou tronquer pour la lisibilité
    # Truncate response for display
    output = data['completion'][:500]  # Limit to 500 characters
    print(output)
    
Introduction à Amazon Bedrock

Extraction de catégories avec Bedrock

  • Exemple : classifier des textes
  • Utiliser des prompts structurés avec options de catégories claires
  • Donner des consignes explicites pour une seule catégorie en sortie
  • Traiter les réponses du modèle efficacement
  • Résultat : catégorisation précise

Icônes représentant la classification de texte

Introduction à Amazon Bedrock

Extraction de catégories avec Bedrock

def categorize_ticket(ticket, categories):
  prompt = f"Categorize into one: {', '.join(categories)}. 
  Ticket: {ticket}"
  response = bedrock.invoke_model(
    modelId='amazon.nova-micro-v1:0',
    body=json.dumps({"messages": [{"role": "user", "content": 
                                   [{"text": prompt}]}]}))

return json.loads(nova_response.get("body").read().decode())["output"]
{"output": {"message": {"role": "assistant","content": [
        {
          "text": "Customer Service"
        }]}, "stop_reason": "stop_sequence"}}
Introduction à Amazon Bedrock

Passons à la pratique !

Introduction à Amazon Bedrock

Preparing Video For Download...