Redes Neurais Recorrentes (RNNs) para Modelagem de Linguagem com Keras
David Cecchini
Data Scientist

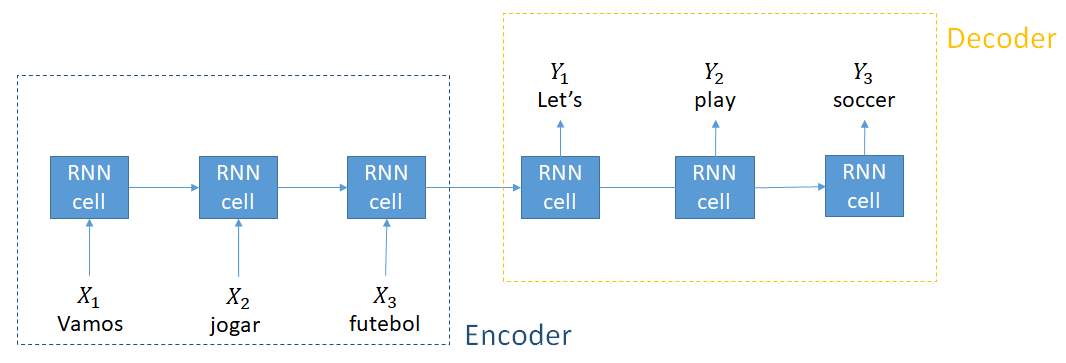
# Instantiate the model model = Sequential()# Camada Embedding para o idioma de entrada model.add(Embedding(input_language_size, input_wordvec_dim, input_length=input_language_len, mask_zero=True))# Adicionar camada LSTM model.add(LSTM(128))# Repetir o último vetor model.add(RepeatVector(output_language_len))
# Logo após o codificador model.add(LSTM(128, return_sequences=True))# Adicionar TimeDistributed model.add(TimeDistributed(Dense(eng_vocab_size, activation='softmax')))

# Import modules
from tensorflow.keras.preprocessing.text import Tokenizer
from tensorflow.keras.preprocessing.sequence import pad_sequences
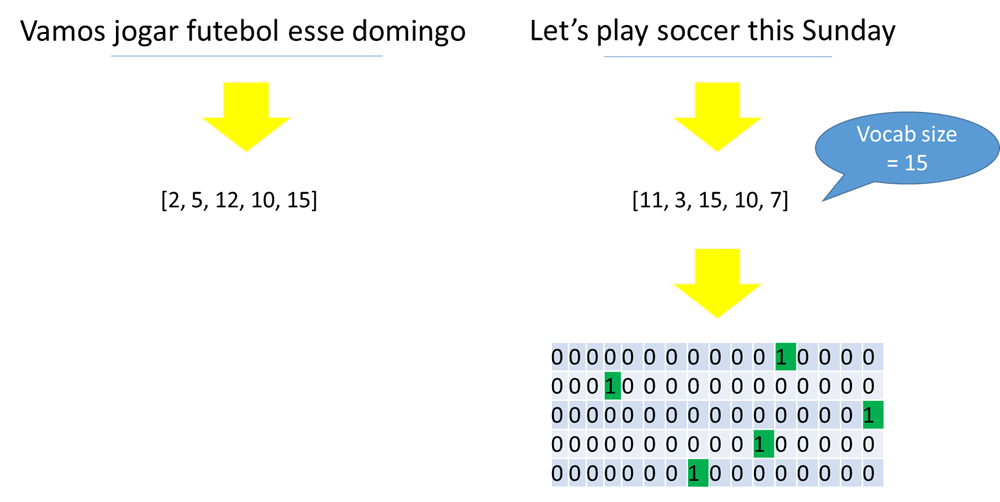
# Usar a classe Tokenizer tokenizer = Tokenizer() tokenizer.fit_on_texts(input_texts_list)# Texto para sequência de índices numéricos X = tokenizer.texts_to_sequences(input_texts_list)# Preencher sequências (padding) X = pad_sequences(X, maxlen=length, padding='post')
# Usar a classe Tokenizer tokenizer = Tokenizer() tokenizer.fit_on_texts(output_texts_list)# Texto para sequência de índices numéricos Y = tokenizer.texts_to_sequences(output_texts_list)# Preencher sequências (padding) Y = pad_sequences(Y, maxlen=length, padding='post')
# Criar uma variável temporária ylist = list()# Percorrer a sequência de índices numéricos for sequence in Y:# One-hot em cada índice da sentença atual encoded = to_categorical(sequence, num_classes=vocab_size)# Adicionar os valores one-hot à lista ylist.append(encoded)# Transformar em np.array e fazer reshape Y = np.array(ylist).reshape(Y.shape[0], Y.shape[1], vocab_size)
Treinando o modelo:
model.fit(X, Y, epochs=N)
Avaliando:
nltk.translate.bleu_scoreRedes Neurais Recorrentes (RNNs) para Modelagem de Linguagem com Keras