Limitação de taxa

Colocando IA em Produção com FastAPI

Matt Eckerle

Software and Data Engineering Leader

Introdução à limitação de taxa
um semáforo


  • Objetivo: Controla a frequência de solicitações à API.
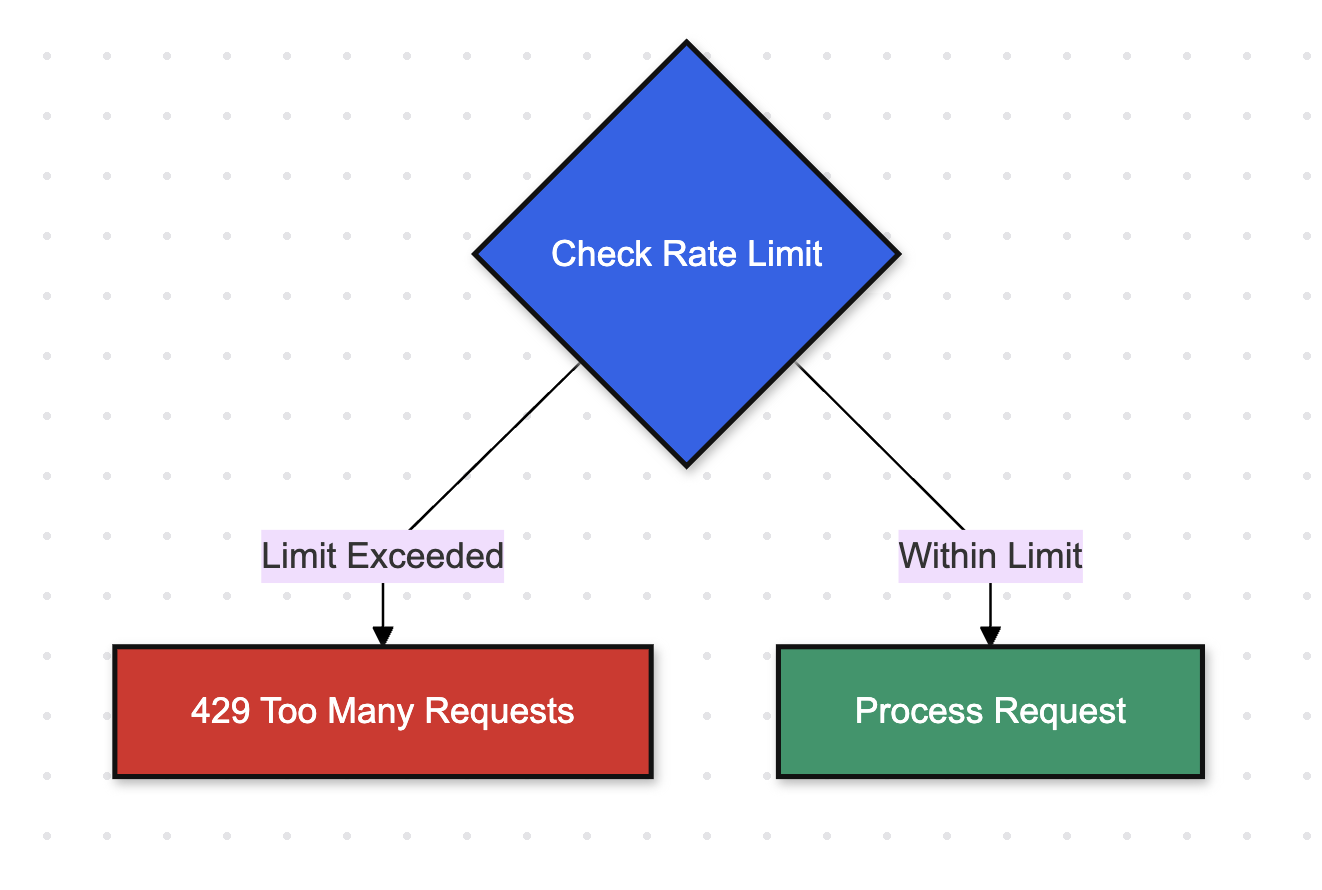
  • Resposta: Retorna HTTP 429 ("Muitas solicitações") quando o limite é excedido.
Colocando IA em Produção com FastAPI

Como a limitação de taxa funciona

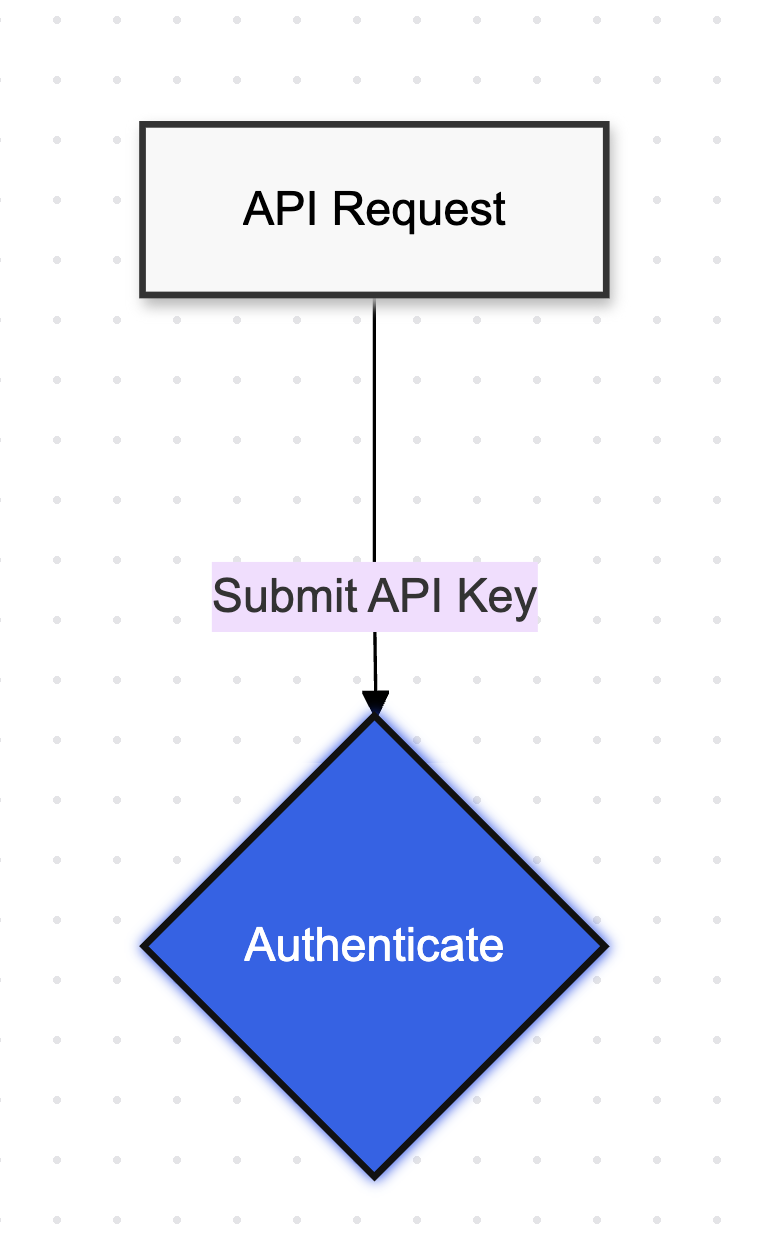
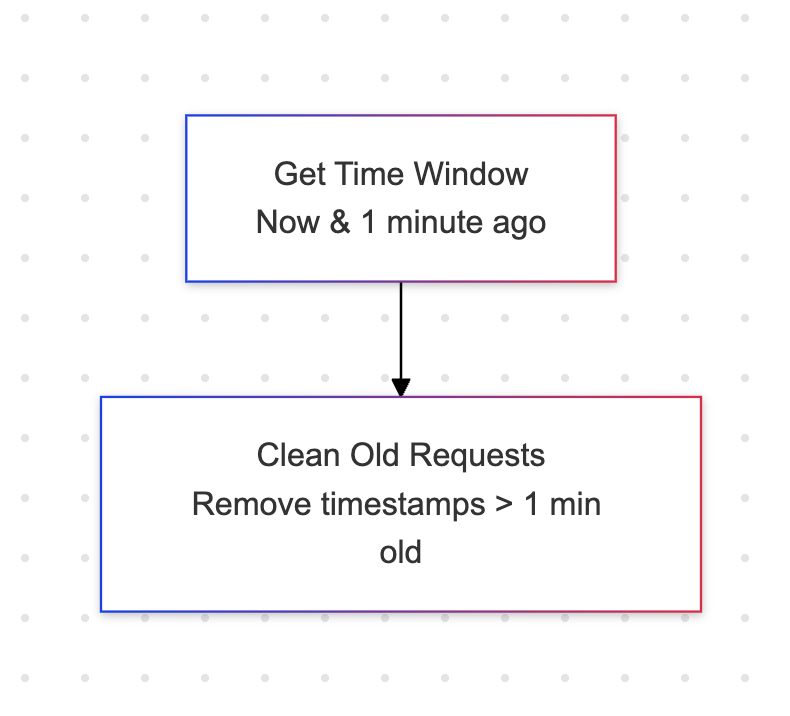
Parte 1 do diagrama de fluxo explicando a limitação de taxa

Colocando IA em Produção com FastAPI

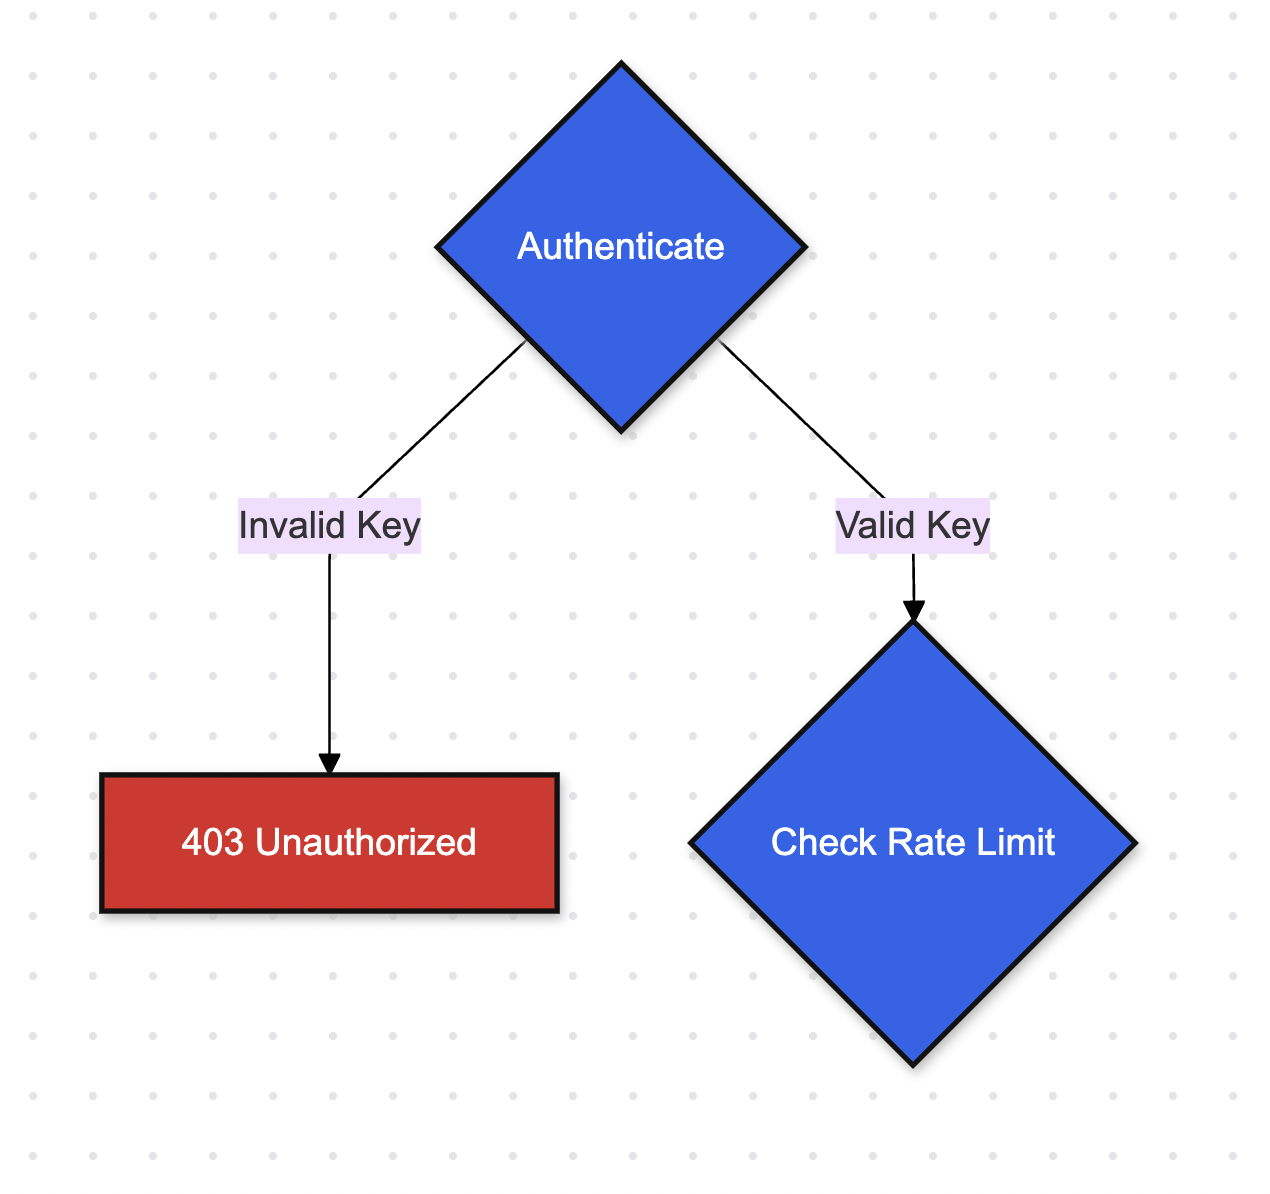
Autenticando credenciais recebidas

Parte 2 do diagrama de fluxo explicando a limitação de taxa

Colocando IA em Produção com FastAPI

Verificação de limitação de taxa

Parte 3 do diagrama de fluxo explicando a limitação de taxa

Colocando IA em Produção com FastAPI

Configurando nossa API

from fastapi import FastAPI, Depends, HTTPException
from fastapi.security import APIKeyHeader
from pydantic import BaseModel

app = FastAPI()
model = SentimentAnalyzer(pkl_file_path)

API_KEY_HEADER = APIKeyHeader(name="X-API-Key")
API_KEY = "your-secret-key"
Colocando IA em Produção com FastAPI

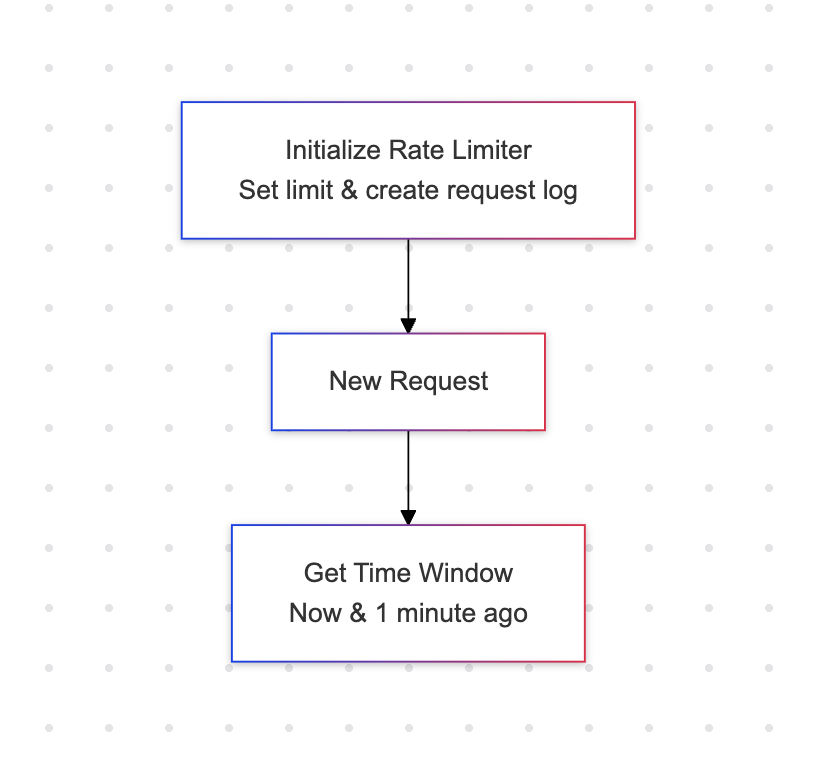
A lógica do limitador de taxa

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:

Parte 1 do diagrama de fluxo da lógica por trás da implementação da limitação de taxa

Colocando IA em Produção com FastAPI

Excluindo solicitações antigas

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:
now = datetime.now() minute_ago = now - timedelta(minutes=1) self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]

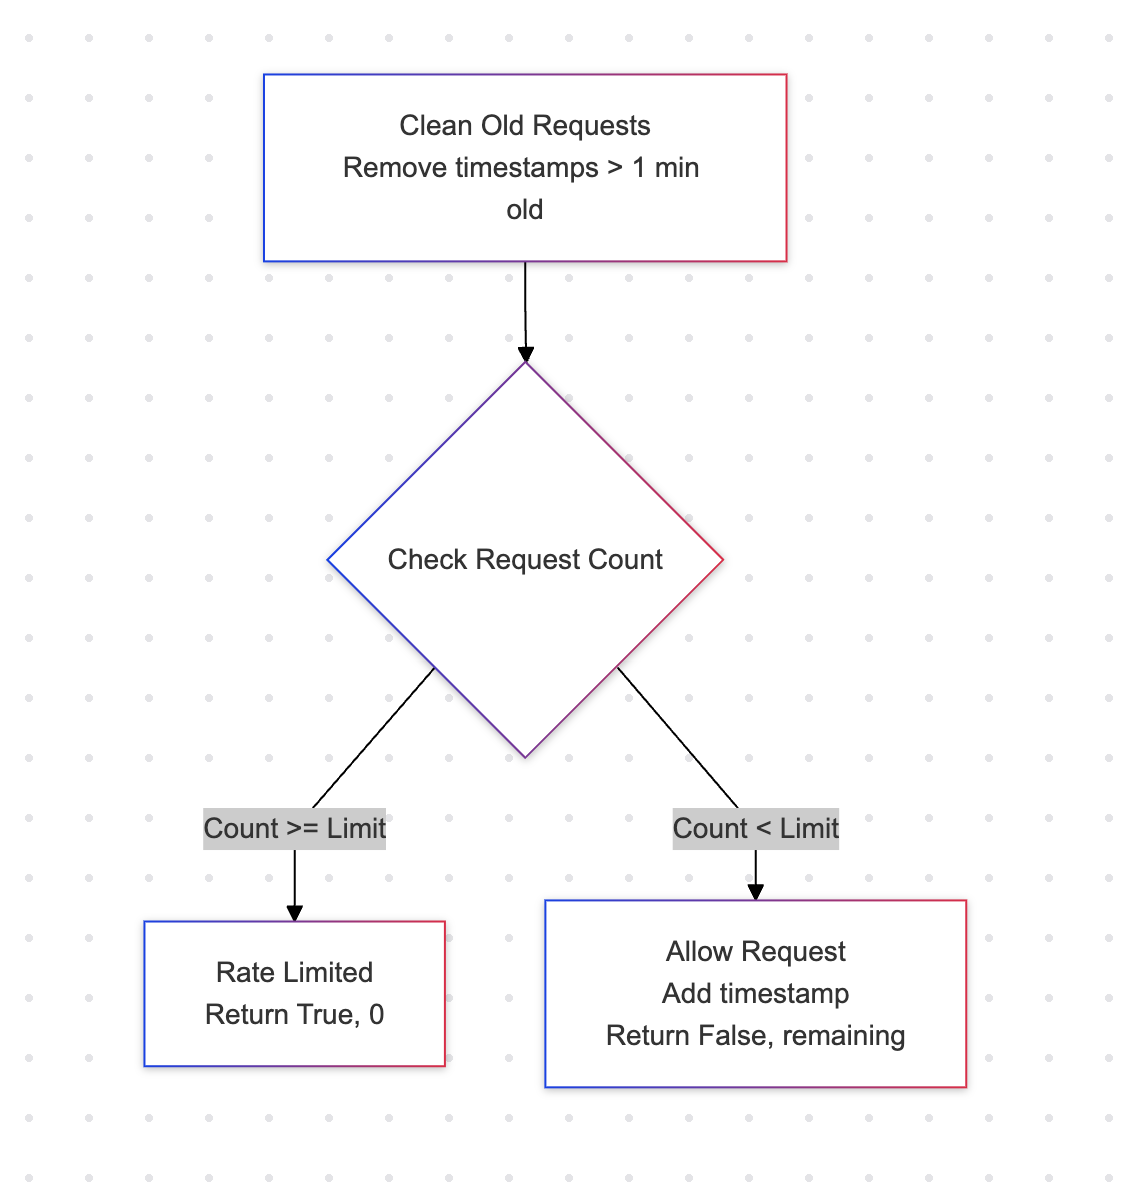
Parte 2 do diagrama de fluxo explicando a limitação de taxa

Colocando IA em Produção com FastAPI

Verificar contagem de solicitações

    def is_rate_limited(self, api_key: str) -> 
  tuple[bool, int]:
        now = datetime.now()
        minute_ago = now - timedelta(minutes=1)

self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]
recent_requests = len(self.requests[api_key]) if recent_requests >= self.requests_per_min: return True, 0 self.requests[api_key].append(now) return False

Um diagrama representando a verificação do número de solicitações feitas à API: se a contagem for maior ou igual ao limite, retorna true; caso contrário, retorna false.

Colocando IA em Produção com FastAPI

Adicionar verificação de limite de taxa

rate_limiter = RateLimiter(requests_per_minute=10)

def test_api_key(api_key: str = Depends(API_KEY_HEADER)): if api_key != API_KEY: raise HTTPException( status_code=403, detail="Invalid API key" ) is_limited, _ = rate_limiter.is_rate_limited(api_key) if is_limited: raise HTTPException( status_code=429, detail="Rate limit exceeded. Please try again later." ) return api_key
Colocando IA em Produção com FastAPI

Aplicar limite de taxa ao endpoint

@app.post("/predict")
def predict_sentiment(
    request: SentimentRequest,
    api_key: str = Depends(test_api_key)
):
    result = sentiment_model(request.text)

    _, requests_remaining = 
           rate_limiter.is_rate_limited(api_key)

    return {
        "text": request.text,
        "sentiment": result[0]["label"].lower(),
        "confidence": result[0]["score"],
        "requests_remaining": requests_remaining
    }

Envie a solicitação 11 vezes:

curl -X POST "http://localhost:8000/predict" \
     -H "Content-Type: application/json" \
     -H "X-API-Key: your-secret-key" \
     -d '{"text": "I love this product"}'

Saída:

{"detail":"Rate limit exceeded. 
           Please try again later."}
Colocando IA em Produção com FastAPI

Vamos praticar!

Colocando IA em Produção com FastAPI

Preparing Video For Download...