Limitation du débit

Déployer l’IA en production avec FastAPI

Matt Eckerle

Software and Data Engineering Leader

Introduction à la limitation du débit
un feu tricolore


  • But : contrôle la fréquence des requêtes API.
  • Réponse : renvoie HTTP 429 (« Too Many Requests ») quand la limite est dépassée.
Déployer l’IA en production avec FastAPI

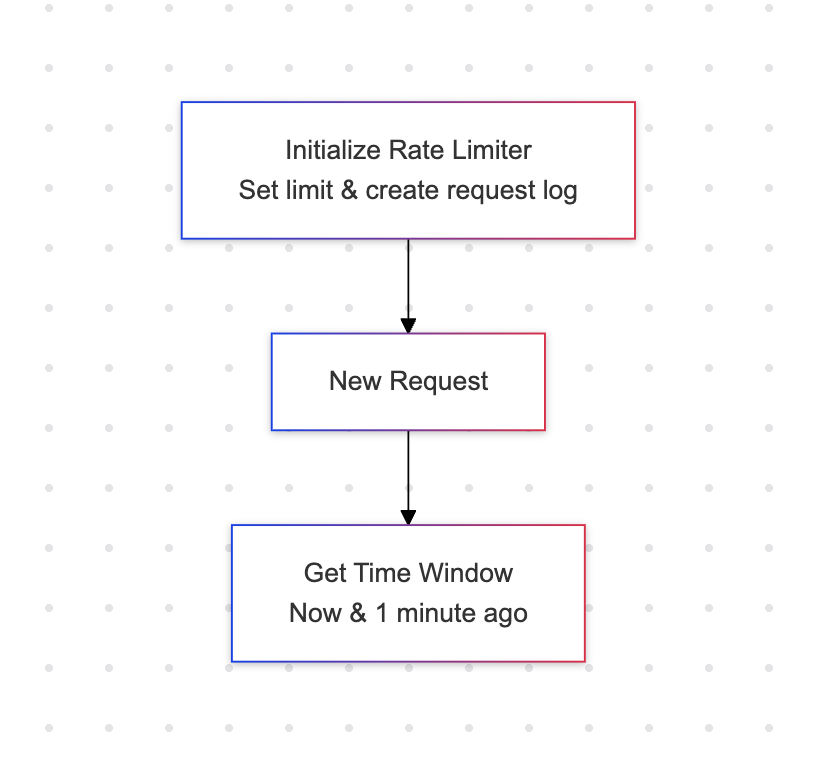
Fonctionnement de la limitation du débit
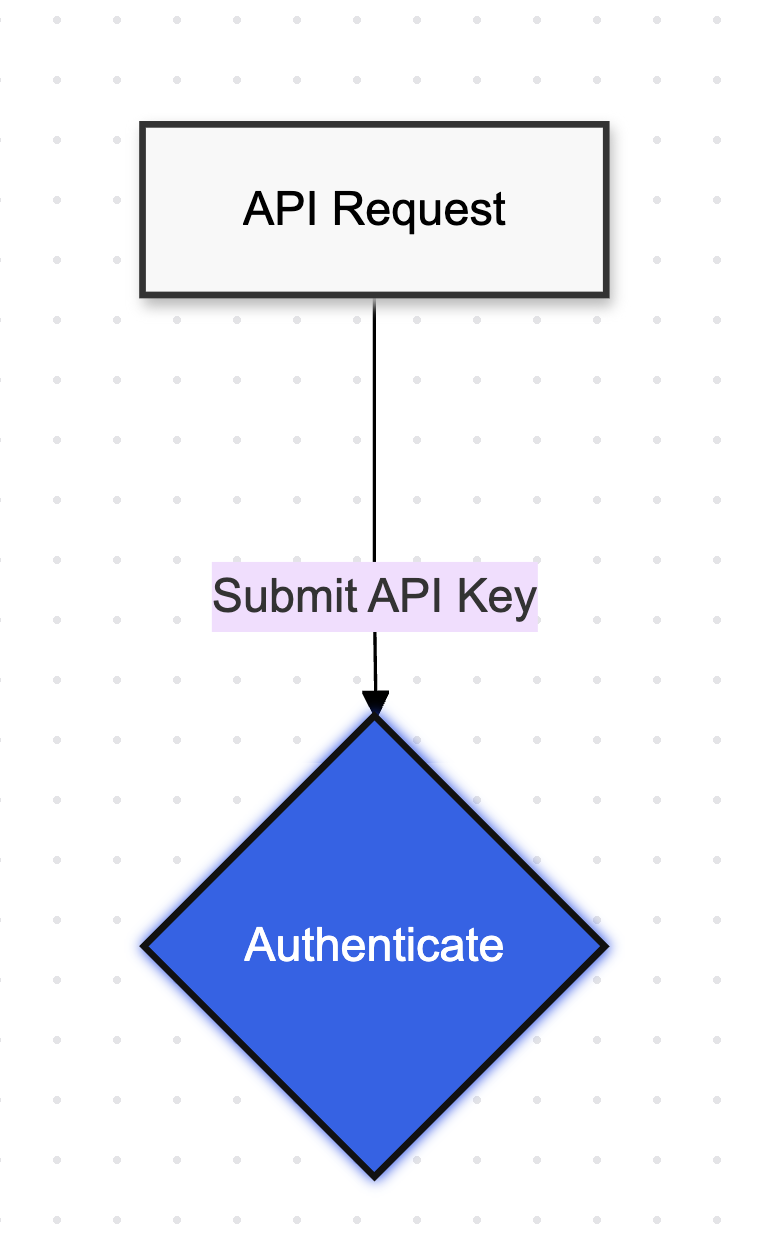
Partie 1 du schéma expliquant la limitation du débit

Déployer l’IA en production avec FastAPI

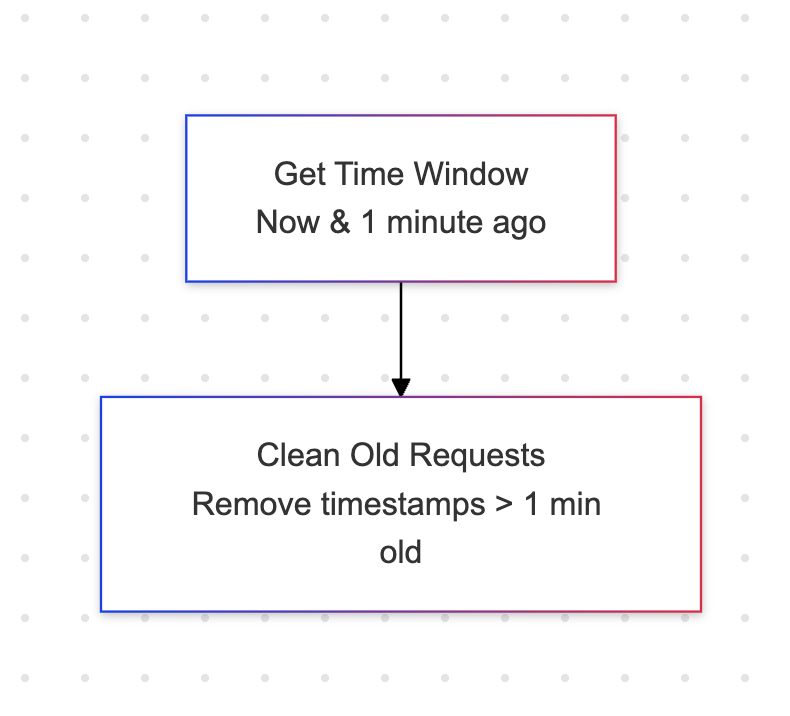
Authentifier les identifiants entrants
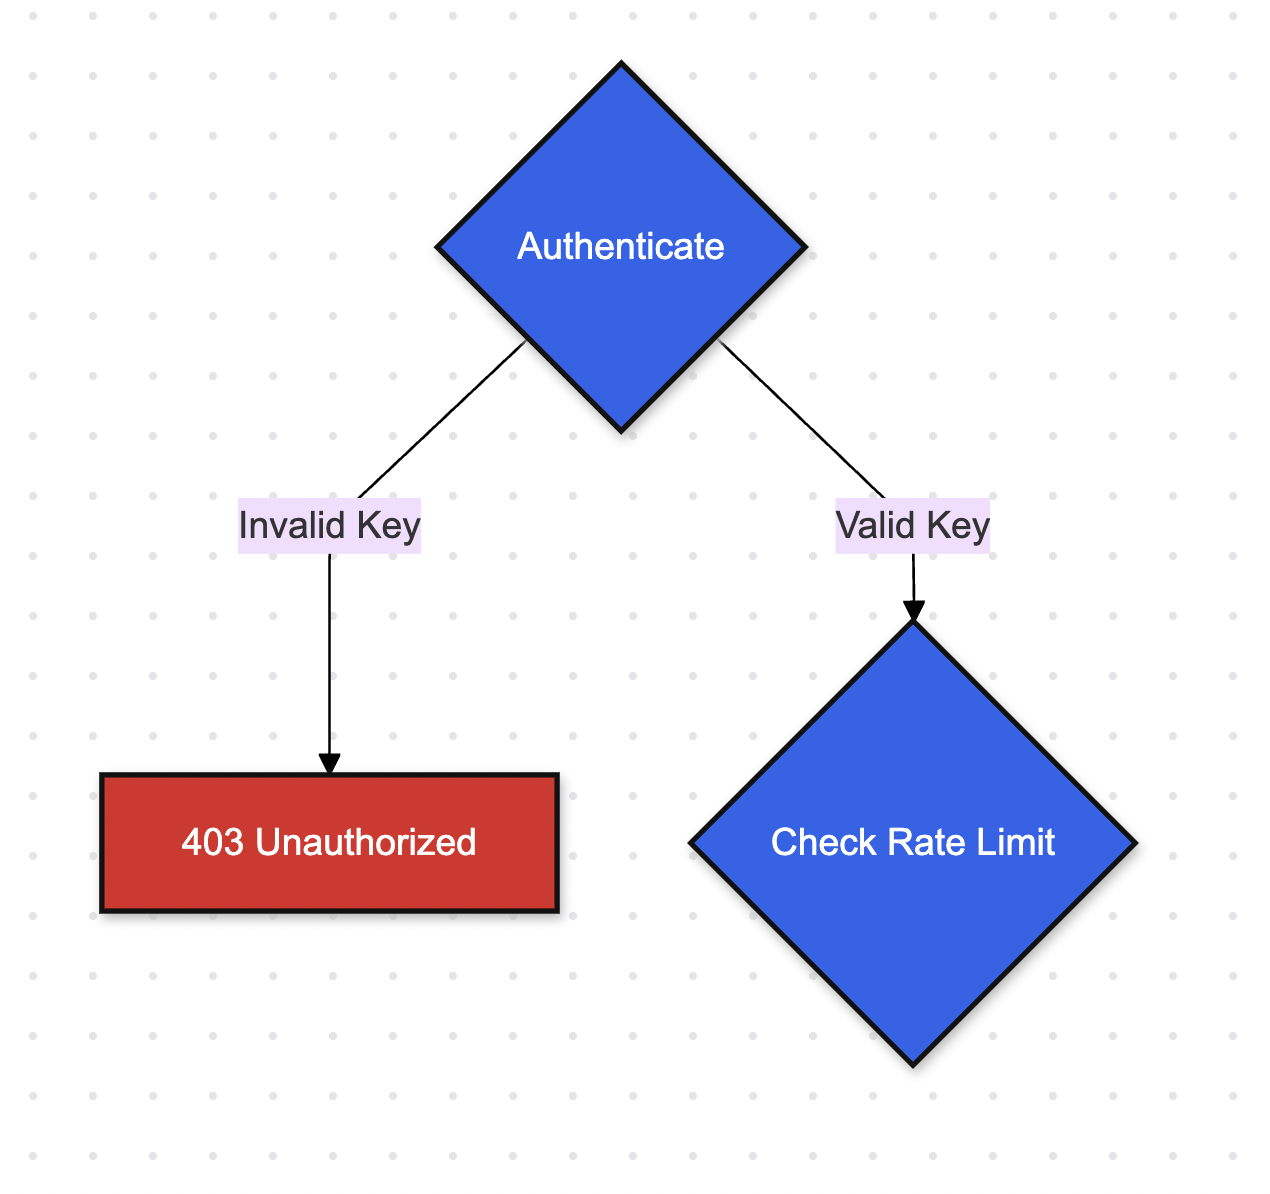
Partie 2 du schéma expliquant la limitation du débit

Déployer l’IA en production avec FastAPI

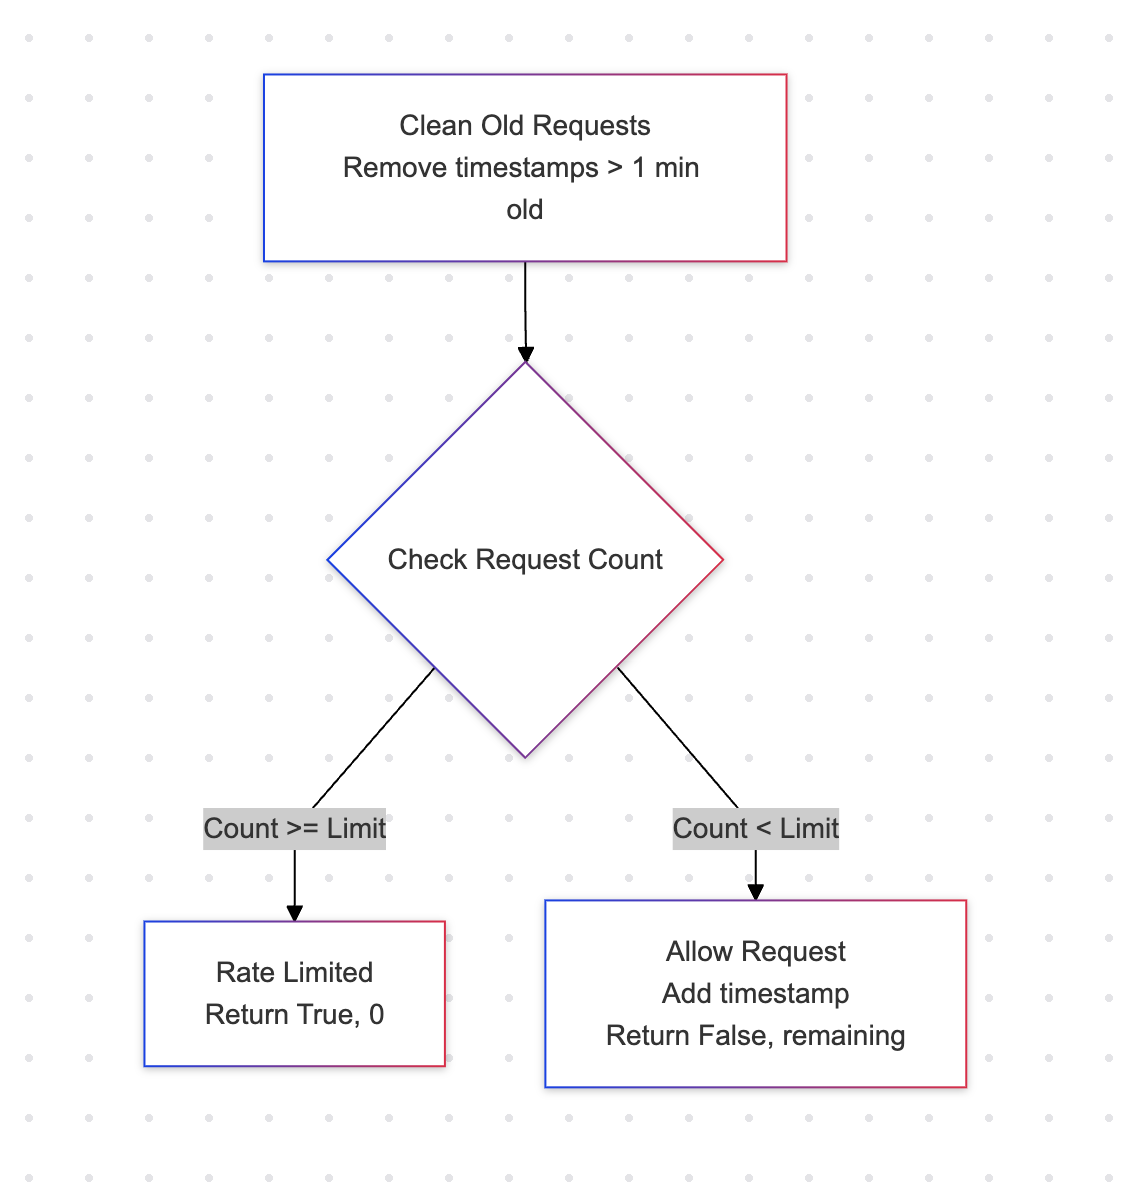
Vérification de la limitation du débit
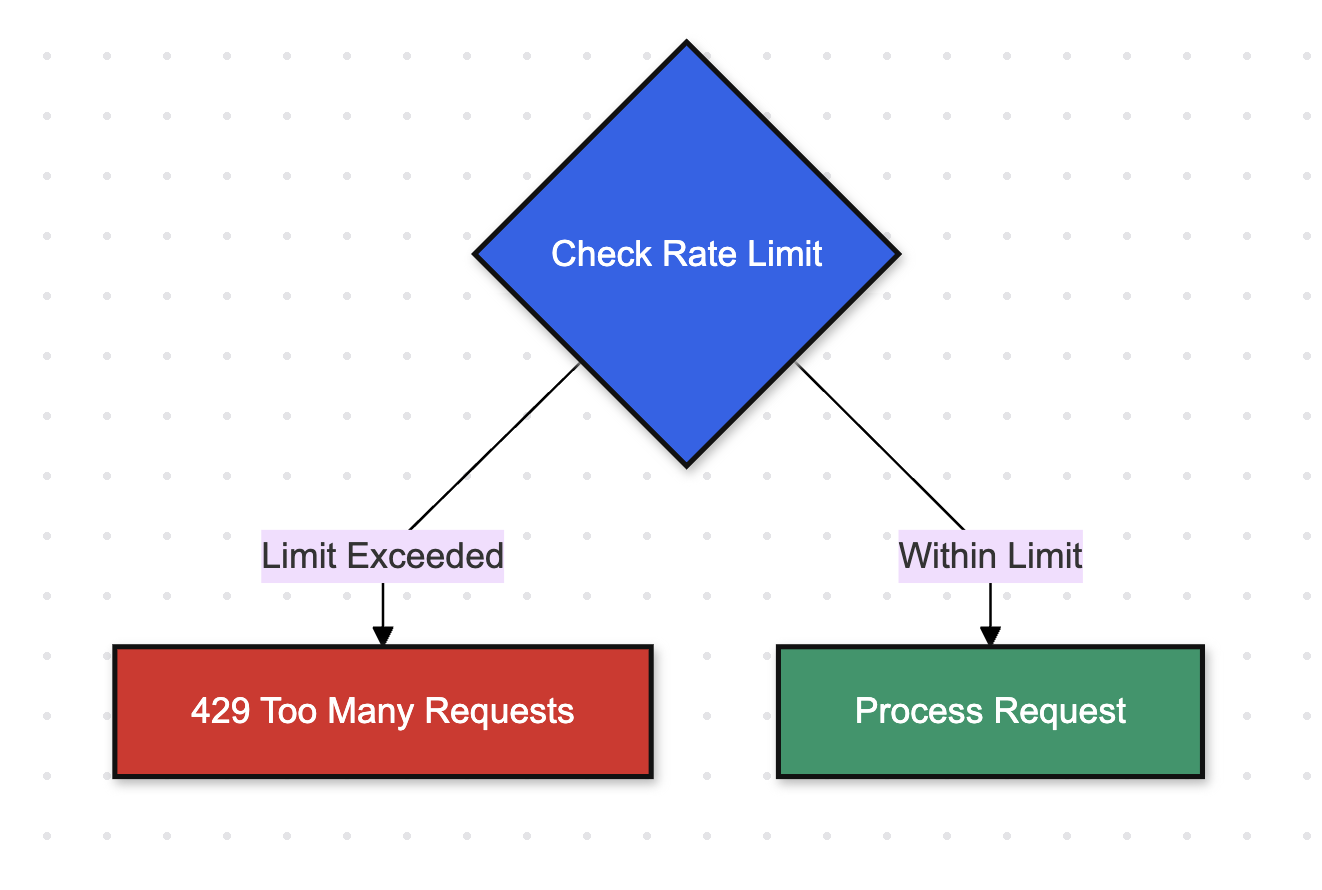
Partie 3 du schéma expliquant la limitation du débit

Déployer l’IA en production avec FastAPI

Configuration de notre API

from fastapi import FastAPI, Depends, HTTPException
from fastapi.security import APIKeyHeader
from pydantic import BaseModel

app = FastAPI()
model = SentimentAnalyzer(pkl_file_path)

API_KEY_HEADER = APIKeyHeader(name="X-API-Key")
API_KEY = "your-secret-key"
Déployer l’IA en production avec FastAPI

Logique du limiteur de débit

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:

Partie 1 du schéma de la logique d'implémentation de la limitation du débit

Déployer l’IA en production avec FastAPI

Suppression des anciennes requêtes

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:
now = datetime.now() minute_ago = now - timedelta(minutes=1) self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]

Partie 2 du schéma expliquant la limitation du débit

Déployer l’IA en production avec FastAPI

Vérifier le nombre de requêtes

    def is_rate_limited(self, api_key: str) -> 
  tuple[bool, int]:
        now = datetime.now()
        minute_ago = now - timedelta(minutes=1)

self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]
recent_requests = len(self.requests[api_key]) if recent_requests >= self.requests_per_min: return True, 0 self.requests[api_key].append(now) return False

Schéma représentant la vérification du nombre de requêtes effectuées par l'API : si le nombre est supérieur ou égal à la limite, renvoyer true, sinon false.

Déployer l’IA en production avec FastAPI

Ajouter la vérification de la limite

rate_limiter = RateLimiter(requests_per_minute=10)

def test_api_key(api_key: str = Depends(API_KEY_HEADER)): if api_key != API_KEY: raise HTTPException( status_code=403, detail="Invalid API key" ) is_limited, _ = rate_limiter.is_rate_limited(api_key) if is_limited: raise HTTPException( status_code=429, detail="Rate limit exceeded. Please try again later." ) return api_key
Déployer l’IA en production avec FastAPI

Appliquer la limite au point de terminaison

@app.post("/predict")
def predict_sentiment(
    request: SentimentRequest,
    api_key: str = Depends(test_api_key)
):
    result = sentiment_model(request.text)

    _, requests_remaining = 
           rate_limiter.is_rate_limited(api_key)

    return {
        "text": request.text,
        "sentiment": result[0]["label"].lower(),
        "confidence": result[0]["score"],
        "requests_remaining": requests_remaining
    }

Envoyez 11 requêtes :

curl -X POST "http://localhost:8000/predict" \
     -H "Content-Type: application/json" \
     -H "X-API-Key: your-secret-key" \
     -d '{"text": "I love this product"}'

Sortie :

{"detail":"Rate limit exceeded. 
           Please try again later."}
Déployer l’IA en production avec FastAPI

Passons à la pratique !

Déployer l’IA en production avec FastAPI

Preparing Video For Download...