Introduction au Deep Q Learning

Apprentissage par renforcement profond en Python

Timothée Carayol

Principal Machine Learning Engineer, Komment

Qu'est-ce que le Deep Q Learning ?
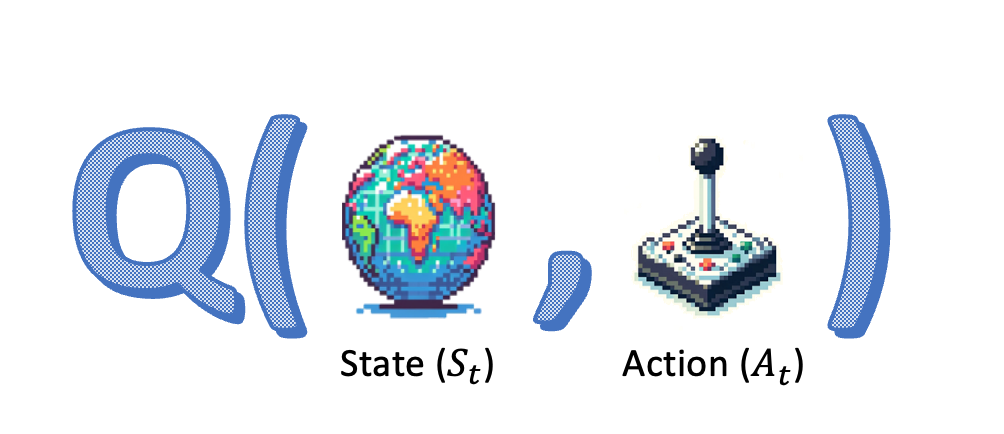


Une image représentant Q(state, action), avec l'état représenté par la Terre et l'action par un joystick

Apprentissage par renforcement profond en Python

Rappel sur le Q-Learning


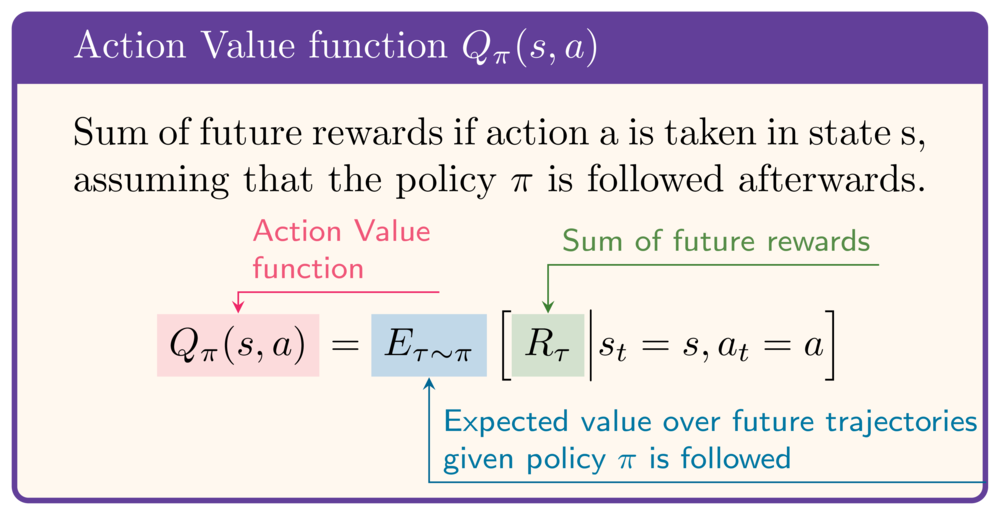
Fonction valeur d'action Q_pi(s,a) : somme des récompenses futures si l'action a est prise dans l'état s, en supposant que la politique pi est suivie ensuite. Q_pi(s,a) = espérance, sur les trajectoires futures étant donné la politique pi, de R_tau sachant s_t=s et a_t=a


  • Connaître $Q$ permet une politique optimale : $$ \pi(s_t) = {\arg\max}_a Q(s_t, a) $$

  • Objectif du Q-learning : apprendre $Q$ au fil du temps

Apprentissage par renforcement profond en Python

Rappel sur le Q-Learning

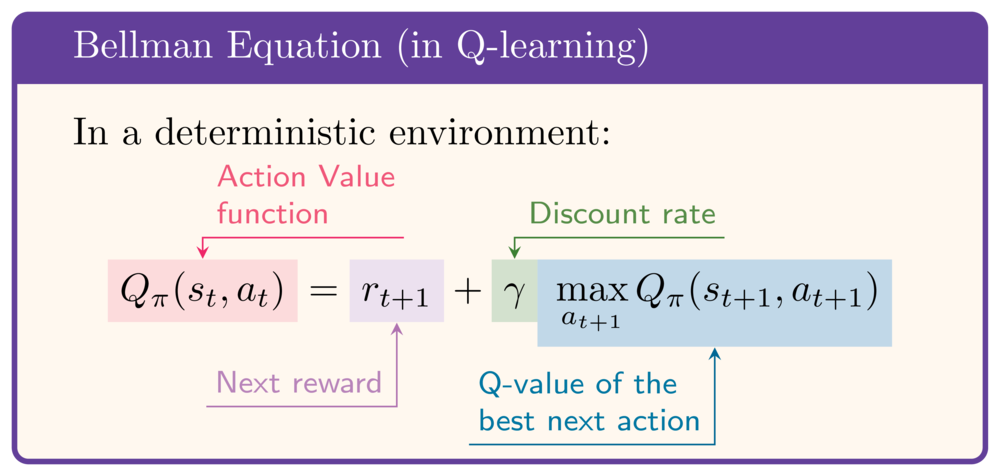
Équation de Bellman (en Q-learning) en environnement déterministe : Q_pi(s_t, a_t) = récompense r_t+1 + taux d'actualisation gamma * max sur a_t+1 de Q_pi(s_t+1, a_t+1))

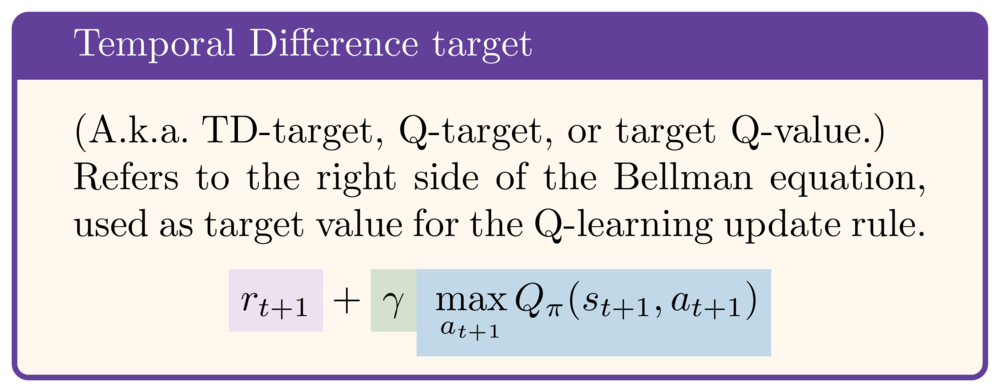
Cible de différence temporelle, alias TD-target, Q-target ou valeur cible de Q : partie droite de l'équation de Bellman, utilisée comme cible pour la mise à jour du Q-learning. r_t+1 + gamma * max sur a_t+1 de Q_pi(s_t+1, a_t+1))

  • Équation de Bellman : formule récursive pour $Q$
  • Partie droite de l'équation de Bellman : « TD-target »
  • Utiliser le TD-target de Bellman pour mettre à jour $\hat{Q}$ à chaque étape
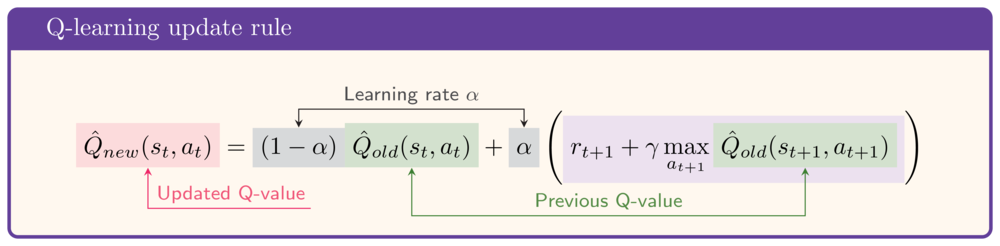
Règle de mise à jour du Q-learning : Q_new = (1-alpha) Q_old + alpha * TD-target

Apprentissage par renforcement profond en Python

Le Q-Network

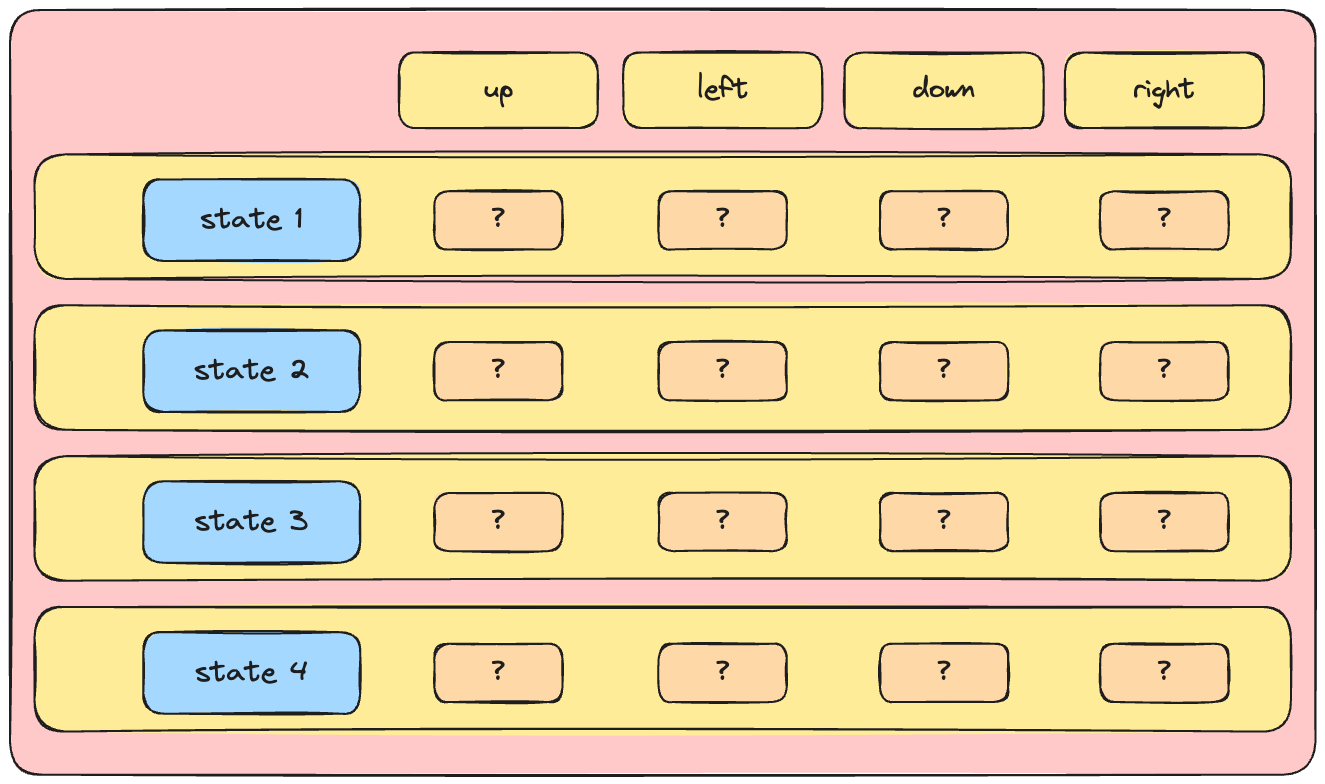
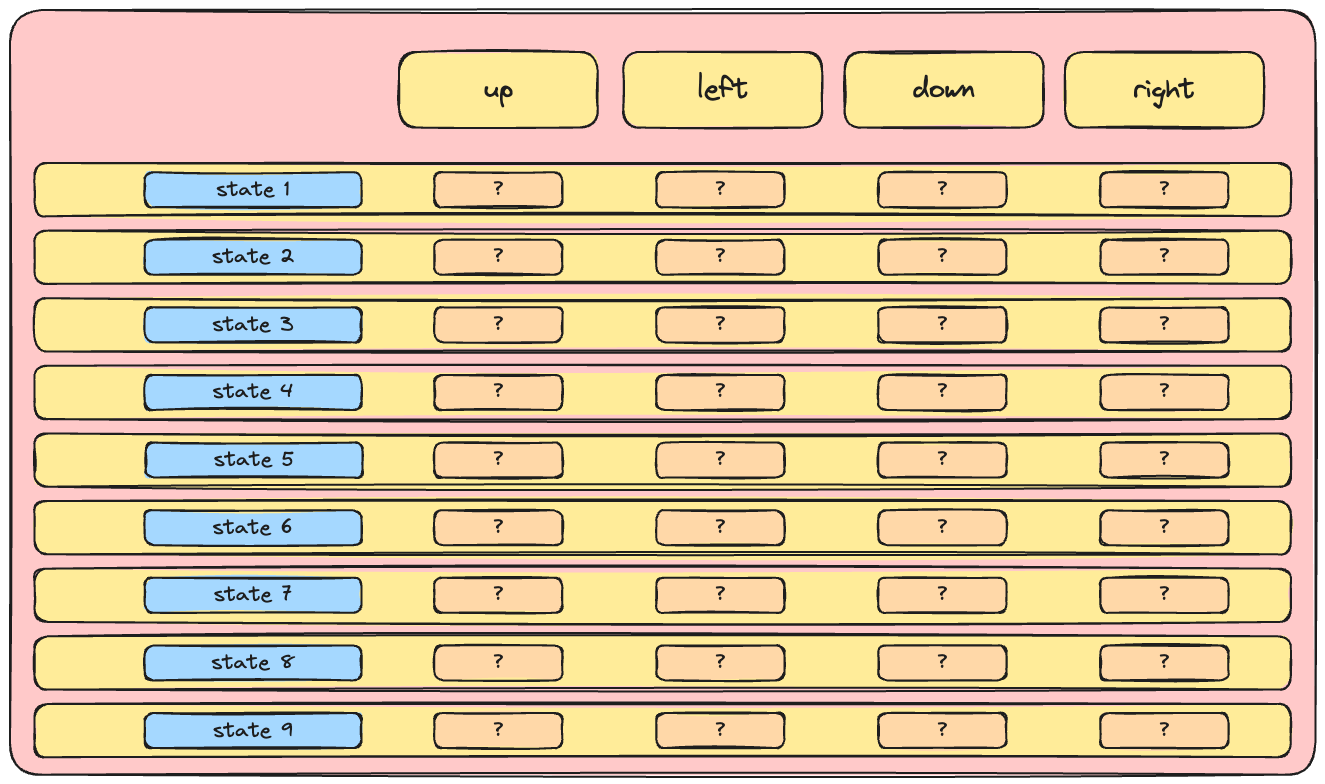
Une table Q avec 4 états et 4 actions, soit 16 cases à remplir

Apprentissage par renforcement profond en Python

Le Q-Network

Une table Q avec 9 états et 4 actions, soit 36 cases à remplir

Apprentissage par renforcement profond en Python

Le Q-Network

Une table Q avec des dizaines d'états et 4 actions, environ 100 cases à remplir

Apprentissage par renforcement profond en Python

Le Q-Network

  • Au cœur du Deep Q Learning : un réseau de neurones
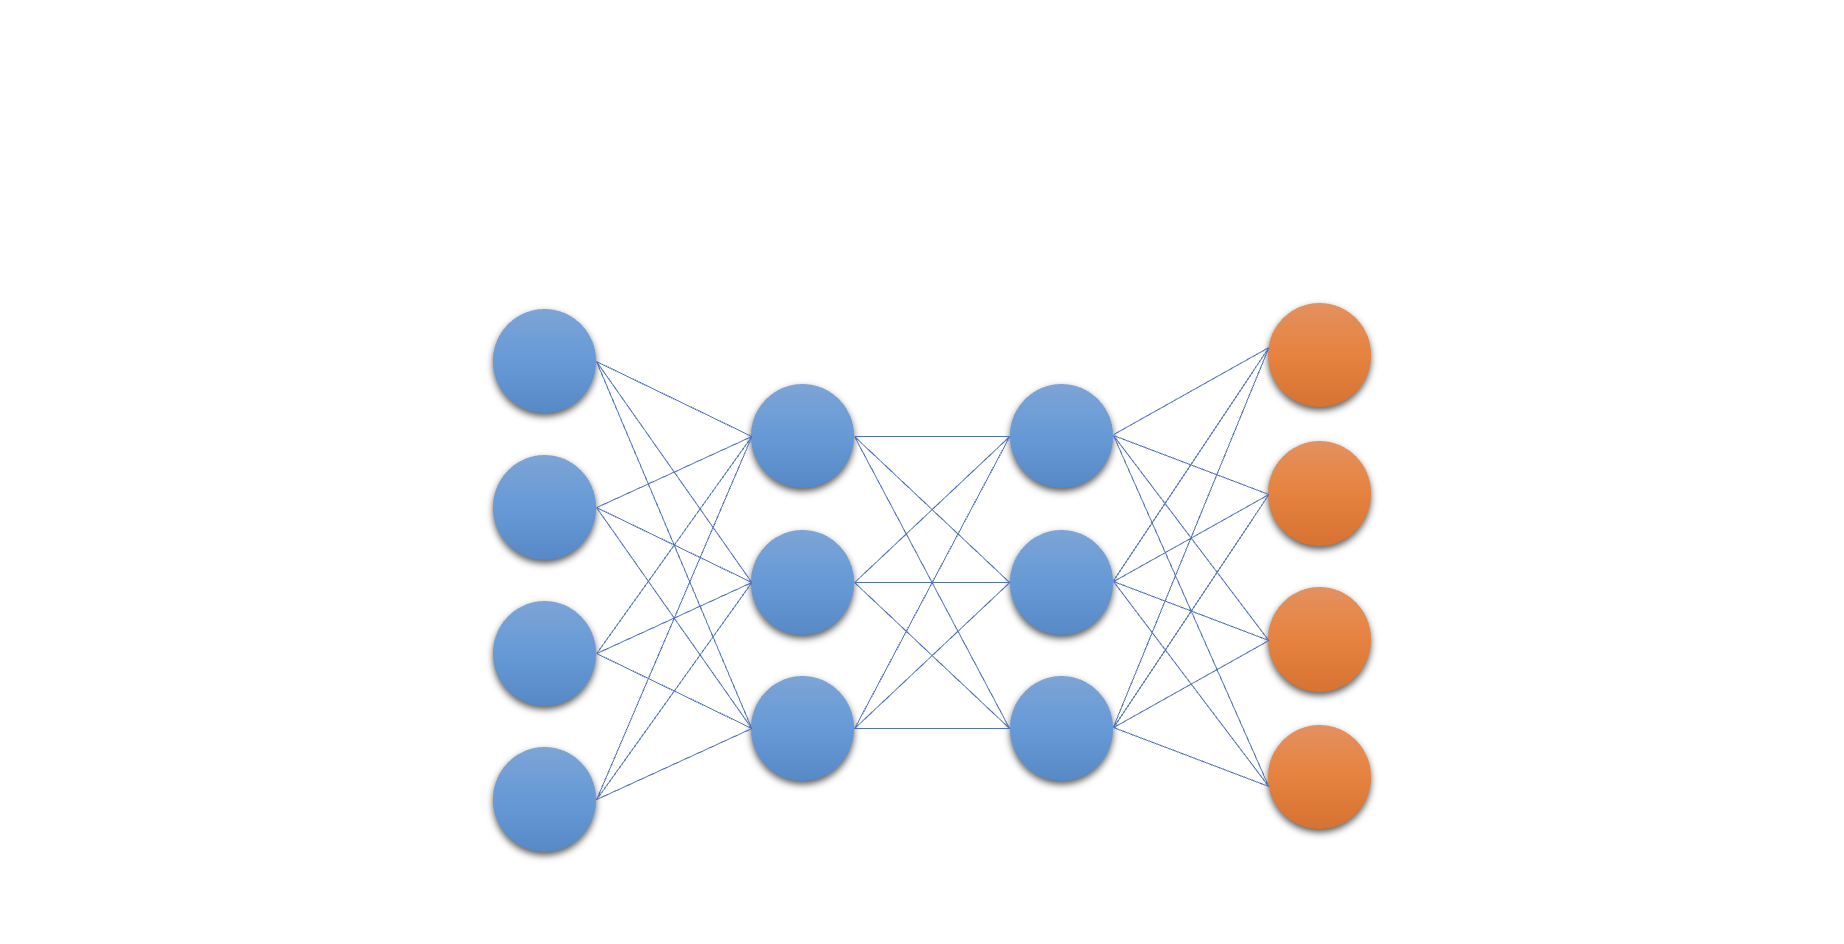
Illustration d'un réseau de neurones entièrement connecté avec deux couches cachées

Apprentissage par renforcement profond en Python

Le Q-Network

  • Au cœur du Deep Q Learning : un réseau de neurones
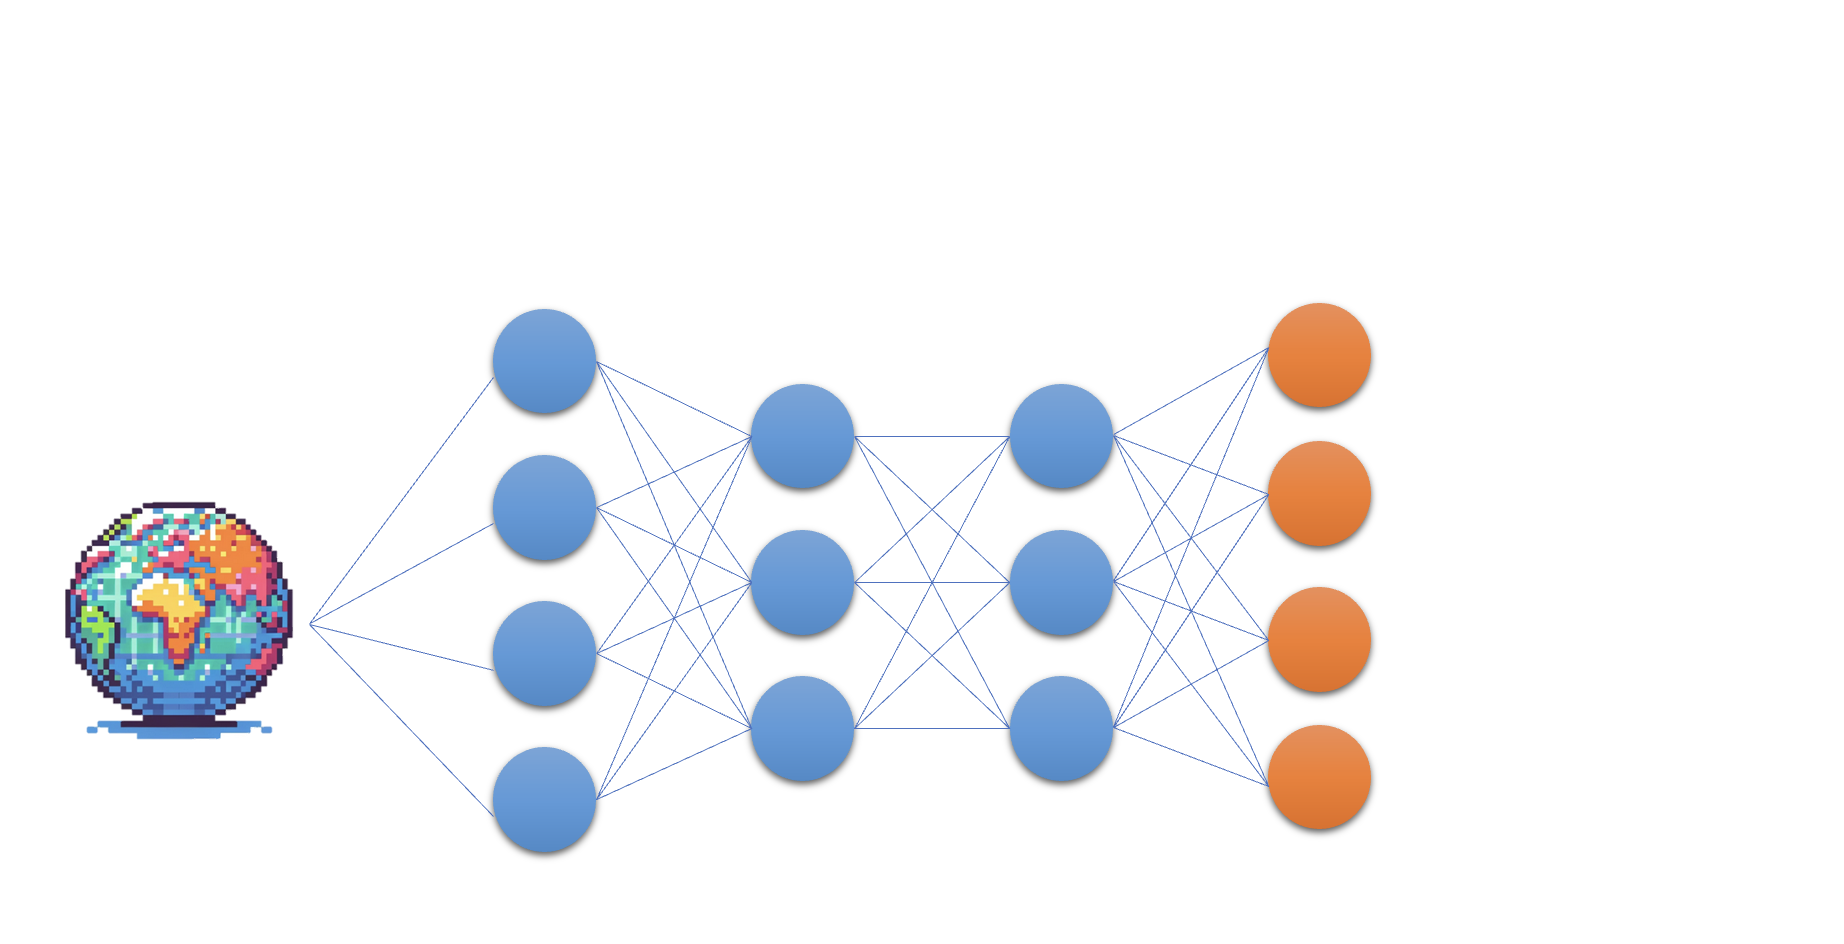
Illustration d'un réseau de neurones entièrement connecté avec deux couches cachées, l'image de la Terre de la diapositive précédente alimentant la couche d'entrée

Apprentissage par renforcement profond en Python

Le Q-Network

  • Au cœur du Deep Q Learning : un réseau de neurones qui mappe l'état vers des valeurs Q
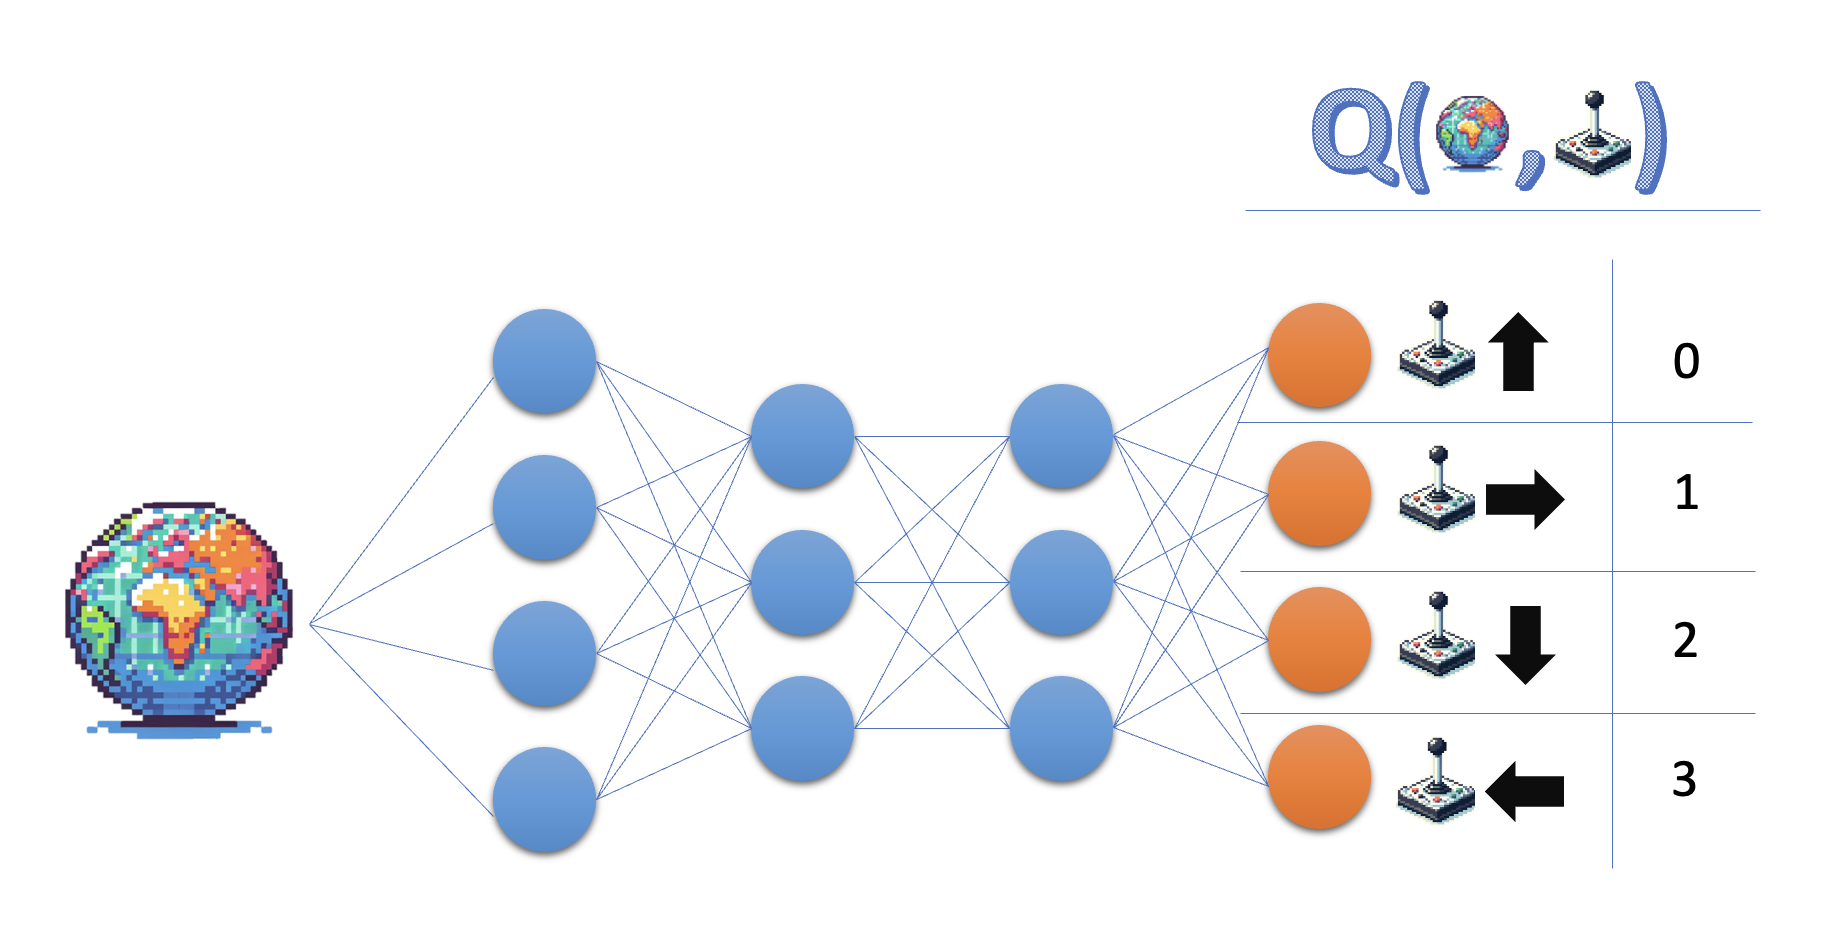
L'illustration de la diapositive précédente, avec chaque nœud de sortie associé à une action représentée comme une direction du joystick. Haut = action 0, droite = 1, bas = 2, gauche = 3.

  • Un réseau qui approxime la fonction valeur d'action est appelé « Q-network »
  • Les Q-networks sont courants dans les algorithmes de Deep Q Learning, comme DQN.
Apprentissage par renforcement profond en Python

Implémenter le Q-network

class QNetwork(nn.Module):

def __init__(self, state_size, action_size): super(QNetwork, self).__init__()
self.fc1 = nn.Linear(state_size, 64) self.fc2 = nn.Linear(64, 64) self.fc3 = nn.Linear(64, action_size)
def forward(self, state): x = torch.relu(self.fc1(torch.tensor(state))) x = torch.relu(self.fc2(x)) return self.fc3(x)
q_network = QNetwork(8, 4)
optimizer = optim.Adam(q_network.parameters(), lr=0.0001)
  • Dimension d'entrée déterminée par l'état
  • Dimension de sortie déterminée par le nombre d'actions possibles

  • Dans cet exemple :

    • 2 couches cachées de 64 nœuds chacune
    • Fonction d'activation ReLu
Apprentissage par renforcement profond en Python

Passons à la pratique !

Apprentissage par renforcement profond en Python

Preparing Video For Download...