Apprentissage par renforcement profond en Python
Timothée Carayol
Principal Machine Learning Engineer, Komment
| Exemples |
|---|
| Taux d'actualisation |
| PPO : épsilon de clipping, bonus d'entropie |
| Experience replay : taille du buffer, taille de lot |
| Barème epsilon décroissant pour le greediness |
| Q-cibles fixes : $\tau$ |
| Taux d'apprentissage |
| Nombre de couches, nœuds par couche... |
Objectif : récompenses cumulées moyennes
Techniques de recherche d'hyperparamètres :


Flux de travail Optuna :
study Optuna
import optunadef objective(trial): ...study = optuna.create_study()study.optimize(objective, n_trials=100)
study.best_params
{'learning_rate': 0.001292481, 'batch_size': 8}
Dans la fonction objectif :
Offre une flexibilité totale pour spécifier les hyperparamètres :
def objective(trial: optuna.trial.Trial):# Hyperparamètres x et y entre -10 et 10x = trial.suggest_float('x', -10, 10) y = trial.suggest_float('y', -10, 10)# Renvoyer la métrique à minimiser return (x - 2) ** 2 + 1.2 * (y + 3) ** 2
n_trials avec l'échantillonneur par défaut (TPE)n_trials est omis : exécute jusqu'à interruption
import sqlite study = optuna.create_study( storage="sqlite:///DRL.db", study_name="my_study")study.optimize(objective, n_trials=100)
loaded_study = optuna.load_study(
study_name="my_study",
storage="sqlite:///DRL.db")
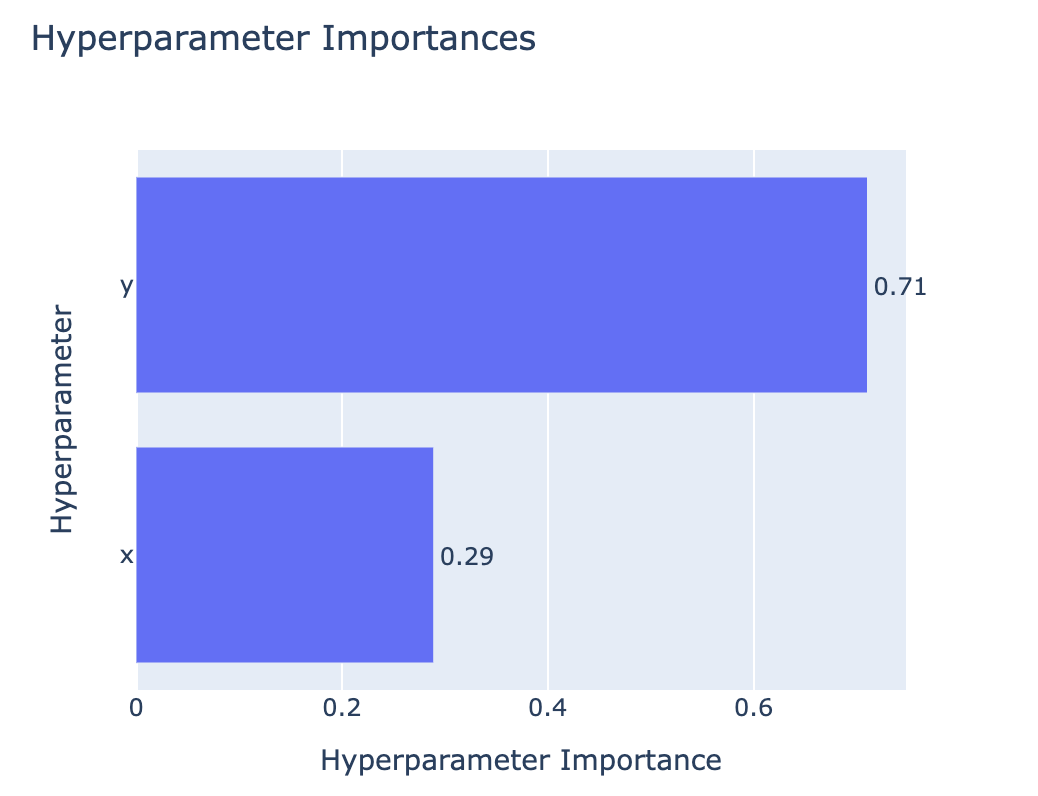
optuna.visualization.plot_param_importances(study)
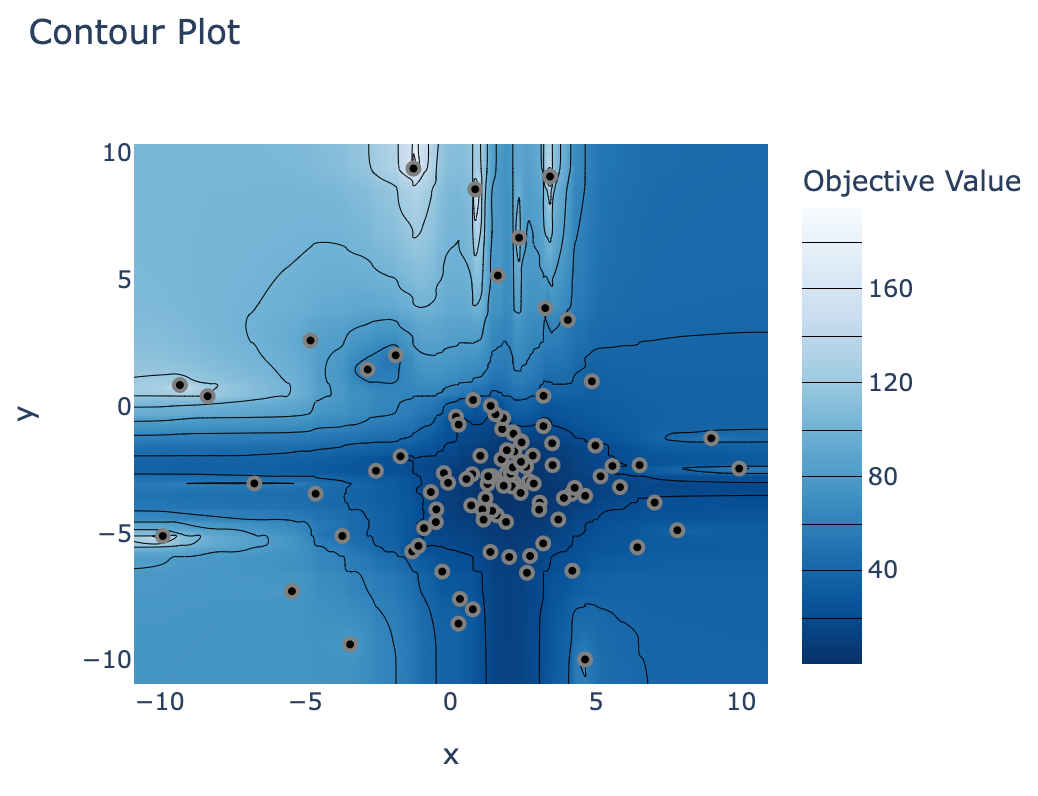
optuna.visualization.plot_contour(study)
Apprentissage par renforcement profond en Python